


让机器人掌握一项新技能,通常有两条路径:人类为它编写程序,或者让它从数据中学习。如今,让由 LLM 驱动的 coding agent 直接控制机器人,成为了第三种可能。然而,coding agent 能否在物理世界的约束下可靠地控制多种机器人?现有基准尚未回答这个问题。
为此,华人科学家李曼玲、Ruohan Zhang、石冠亚联合团队及其合作者(包括李飞飞、Dawn Song、Pieter Abbeel 等)提出了“具身的第一场考试”(Embodied First Exam,EFE),一个统一、全面且 agent 原生的评测框架,旨在考察通用 coding agent 能解决哪些机器人任务、物理世界约束如何影响表现,以及失败发生在哪一步。
论文链接:https://arxiv.org/abs/2611.12177
据论文介绍,EFE 包含 35 个任务套件中的 1156 项任务,涉及 47 款机器人。其中 26 个套件改编自已有机器人基准,9 个新增套件将评测从抓取和放置拓展至空间谜题、灵巧操作、多机器人交互、动态全身控制,以及不同仿真环境之间的工程任务。
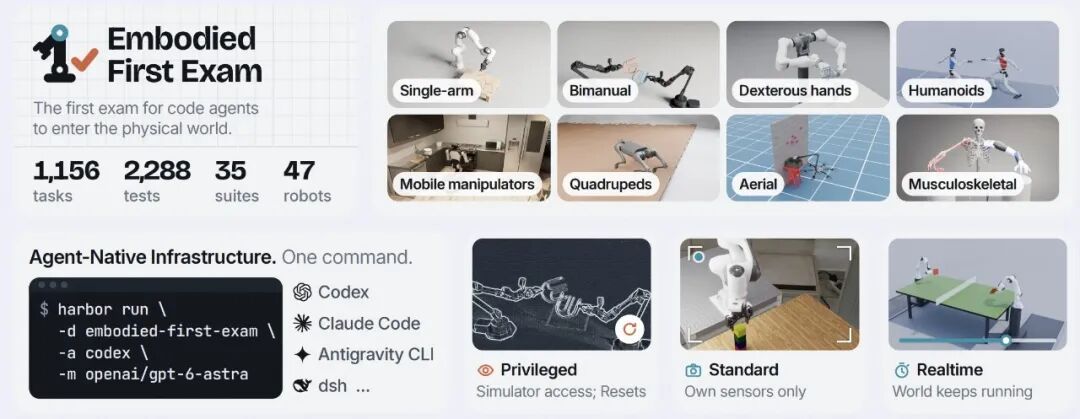
图|Embodied First Exam 概览
面对这些任务,agent 可以自行选择控制方式:直接输出动作、编写控制程序,或训练策略后控制机器人。EFE 用统一的基础设施支持不同模型和 harness 的组合,每次尝试的结果由 agent 无法控制的验证器判定。
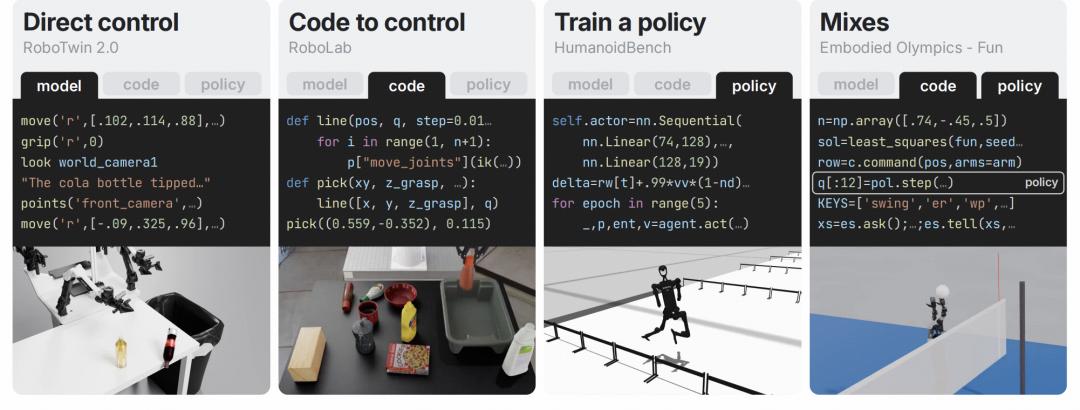
图|控制方式示例
在控制方式之外,EFE 还改变了 agent 观察和试错的条件。每项任务最多具有 3 种评测设置。同一任务在不同设置下共享初始场景和成功判定规则。
标准(Standard)设置只允许 agent 通过机器人传感器观察环境,默认无法重置,但仿真会在 agent 推理时暂停。实时(Realtime)设置保留标准设置的约束,并让环境在 agent 推理期间继续运行。特权(Privileged)设置则开放完整仿真状态和无限重置,允许 agent 反复试错、搜索解法。他们将这一设置下的成功率视为近似上界,也将其作为生成训练数据的一种途径。
他们在 456 项高难度核心任务上评估了 8 个 coding agent。最强的是在 Codex 中运行的 GPT-6 Astra,它在标准设置下的总体成功率为 33.6%。
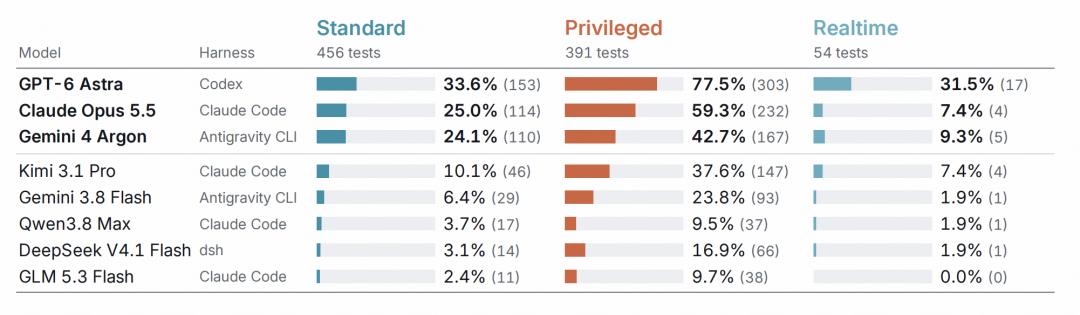
图|各 agent 在核心集合上的成功率
他们进一步比较了同时具有标准和特权设置的 391 项任务。在能够访问完整仿真状态、无限重置环境时,GPT-6 Astra 的成功率达到 77.5%。只能通过机器人传感器观察环境、默认无法重置时,这一成功率降至约 30%。
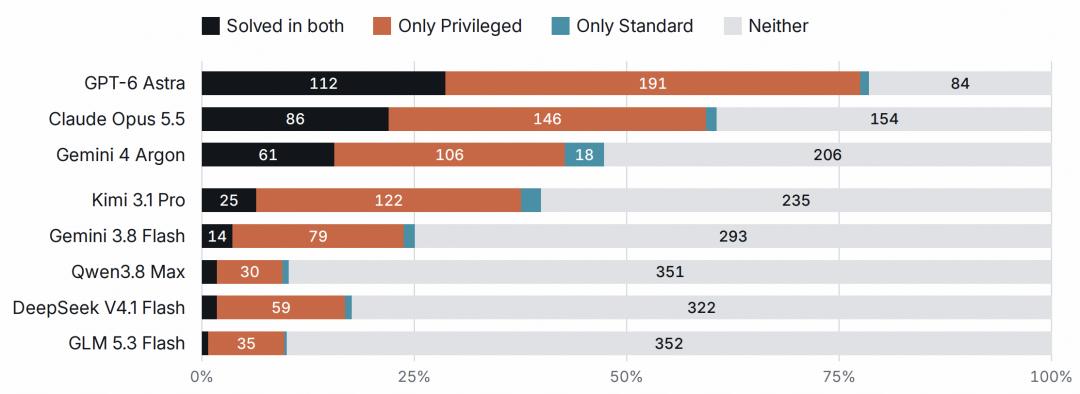
图|同时具有特权与标准测试的 391 项核心任务
针对这一最强 agent 的控制实验进一步区分了状态信息和重置机会的作用。增加无限重置,比增加精确物体状态更能缩小两种设置之间的差距。两者同时提供时,与特权设置之间的大部分差距就能弥合。在需要精确操作的阶段,重置有帮助,仅提供精确状态则没有帮助。
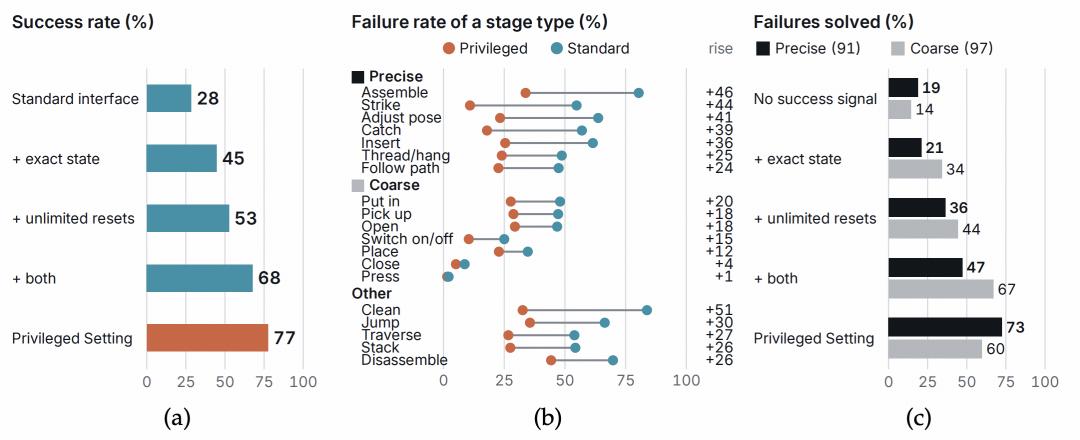
图|在套件内部比较各阶段类型的失败率,单位为百分比
当环境在推理期间持续运行,任务会进一步变难。在同一组 54 项任务上,标准设置中有 50% 的测试未被任何 agent 解决,实时设置下这一比例升至 63%。
这些失败具体发生在哪里?他们按照完成任务所需的世界状态变化,将任务划分为多个阶段。例如,将番茄放入关闭的冰箱,需要打开冰箱、放入番茄,再关闭冰箱。另一个独立的 coding agent 为 8 个受测 agent 在 427 项任务中的失败尝试标注了失败阶段。
分析发现,同一任务中的失败往往集中在相同阶段,而且通常是第一阶段。特权和标准设置下的失败位置也往往一致。涉及改变材料或移动机器人身体的阶段,失败率最高。agent 越弱,越容易在完成所需接触之前失败。
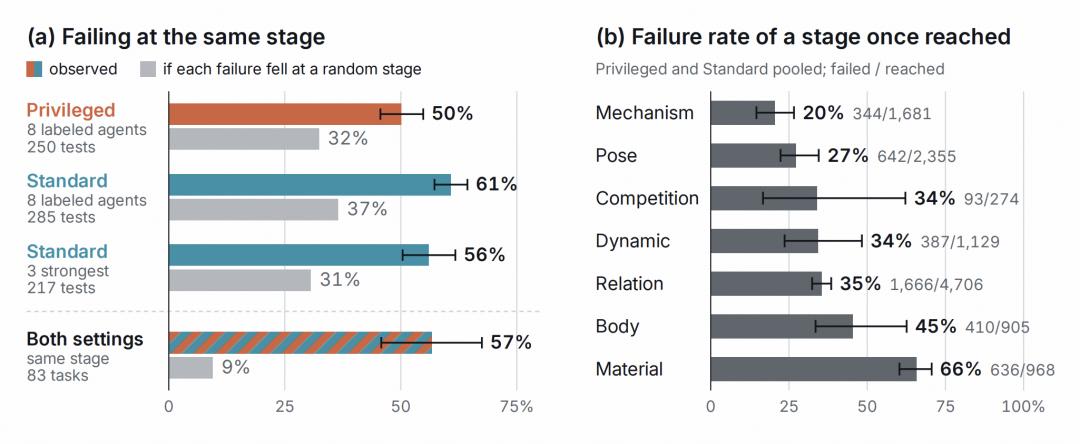
图|失败阶段的集中程度,按测试取平均值;以及在两种设置下具有相同最常见失败阶段的任务比例,排除了两种设置中该阶段均为第一阶段的任务
不同 agent 的能力也并不完全重合。在标准设置下,表现最强的 3 个 agent 解决的是部分不同的测试。harness 同样影响结果:切换 harness 最多能让成功率变化 12 个百分点。
agent 选择的控制方式还会随条件变化。在标准设置下,它们主要直接控制机器人,在特权和实时设置下,则主要编写控制程序。在一项足球任务的标准和实时设置中,当系统提供 GPU 和训练库时,agent 会训练策略,而获胜的只有经过训练的策略。
当然,这样研究也有一些局限,他们明确指出,每个 agent 对每项测试只尝试一次,阶段级标签和控制方式标签由 agent 生成,主要评测结果也都来自仿真。单次运行无法区分反复出现的失败和偶发失误。仿真之外,真实机器人上的表现还需要进一步考察。
接下来,他们计划对每项核心测试做多次运行,区分稳定重复的失败和单次运行失误,并为不同 agent、不同设置之间的比较给出置信区间。由于实时设置中未被任何 agent 解决的测试占比最高,他们还将增加更多实时任务。
真实机器人评测也是后续方向。标准设置已经把 agent 的输入和操作限制在机器人传感器读数和控制接口之内,只要能对任务结果评分,同一接口就能用于真实硬件。他们已经演示了两个 agent 用真实机械臂完成电流迷宫游戏,并计划通过这一接口系统评估 agent 在真实机器人上的表现。
 简体中文
 English