Kimi拿走61%,美国企业开源账单近九成给了中国模型
来源:36kr 2 小时前

美国企业花在开源大模型上的钱,近九成都流进了中国公司的口袋。

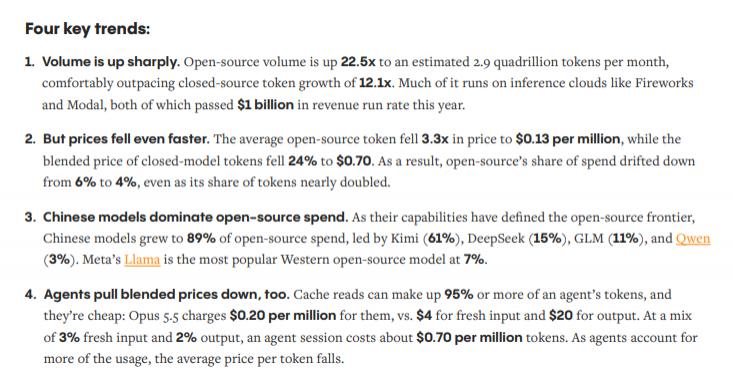
11月3日,硅谷风投门罗风投(Menlo Ventures)发布的《2026年企业 AI 现状报告》把这笔账算得很明白。基于对近 400 名美国企业 AI 业务负责人的调研,报告给出一个刺眼的数字:美国企业花在开源大模型上的支出,89%付给了中国模型。

拆开看,月之暗面的 Kimi 拿走 61%,DeepSeek 占 15%,智谱的 GLM 占 11%,阿里通义千问占 3%。西方模型里份额最高的 Meta Llama,只有 7%。
钱流向中国,不是因为中国模型便宜到白送,而是因为它们把开源这一档的能力上限抬高了。

门罗风投在报告里直言,"随着中国模型定义了开源前沿,它们占到了开源支出的 89%"。过去一年,开源模型的平均 token 价格确实掉了三分之二,从每百万 0.45 美元降到 0.13 美元,但用量同时涨了 22.5 倍,月 token 量冲到 2.9 千万亿。

价格腰斩、数量翻二十多倍,结论是开源占了平台 token 总量的 19%,却只占企业模型支出的 4%。

便宜,但用得狠。

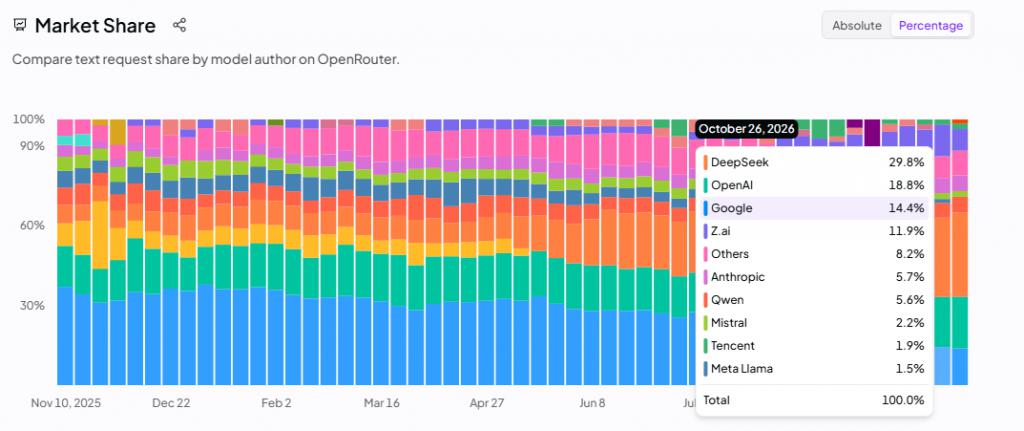
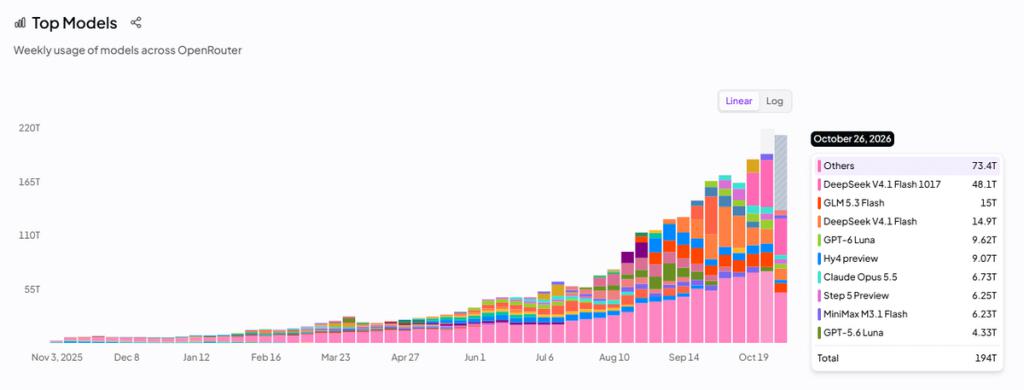
全球 AI 模型聚合平台 OpenRouter 最新一周(10 月 26 日至 11 月 1 日)的排行显示,DeepSeek 以 29.8% 的文本请求份额排在所有作者第一位,环比上涨 7%;OpenAI 以 18.8% 退居第二,Google 掉得最狠,从 14.4% 继续下滑。Z.ai(智谱)以 11.9% 排第四,通义千问以 5.6% 排第六。

这一周,中国大模型的 token 调用量已经连续第 27 周超过美国模型;按单模型排,周调用量前五名里中国模型占了四席。
排在第一位的 DeepSeek,最近动作不断。

10月17日,它把线上主力模型升级到 DeepSeek-V4.1-Flash-1017,API 调用方式和价格都没变,但网页端和 APP 端同步切到了新版本。往上推一个月,9月10日发布的 V4.1 Flash 是这套新模型结构里尺寸最小的一档,原生带多模态视觉理解,官方说法是 "能力上限更高、推理速度更快、吞吐更大"。

在 OpenRouter 上,DeepSeek V4.1 Flash 过去 30 天处理了 114 万亿 token,环比增长 95%;10月17日更新的 1017 版本,单日 token 量已经摸到 6 万亿。

不止模型本身。DeepSeek 8月13日推出的桌面智能体产品 Harness,9月29日桌面端正式上线,官方最新披露的数字是日活 154 万,日均 token 用量 92 万亿。11月3日,DeepSeek 网页和 API 曾出现约 1 小时的部分中断,当天已恢复。

一个值得注意的反差是:在门罗风投统计的 "企业真金白银支出" 维度,Kimi 以 61% 的份额压过 DeepSeek 的 15%;但在 OpenRouter 按实际请求量排的使用榜上,DeepSeek 反超 Kimi,成为开发者调用最频繁的中国模型。

支出向 Kimi 集中,调用向 DeepSeek 集中,背后是同一批美国企业,它们在为开源模型付钱,也在为中国模型写代码。

这笔账还在继续。

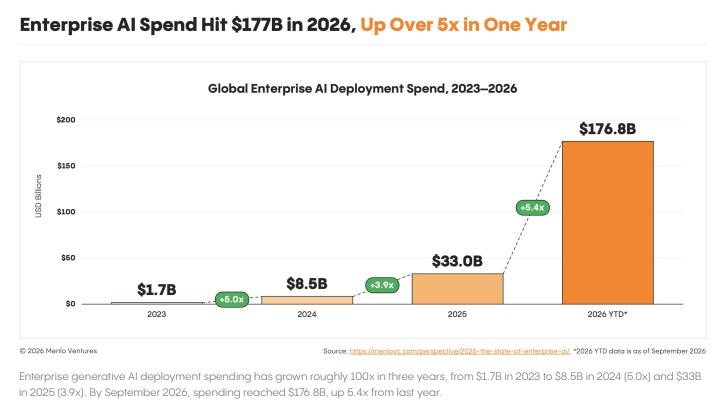
门罗风投的数据显示,2026年美国企业 AI 部署支出已经从去年的 330 亿美元冲到 1768 亿美元,一年涨了 5.4 倍;其中 55% 的新增预算是净新增,不是从传统软件或人力预算里切过来的。
来源:星河商业观察
简体中文 English