


《读佳》独家获知,Soul将推出专为交互场景打造、超具活人感的语音合成产品“Loxinity(洛希无限)”,和市面上面向配音、短视频的TTS不同,这套模型从底层瞄准实时交互场景,主打强活人感。它支持单人配音、多人对话两种模式,配套音色克隆、音色设计等工具,还开放API接入。Loxinity下辖语音合成模型Loxi Speech和视频生成模型Loxi Avatar。
目前看,比起只追求字音标准的传统语音模型,Loxinity更看重对话里的语气停顿、情绪起伏这类副语言细节,用来承接社交场景里的连续语音互动。
该产品的使命为:让 AI 交互更自然——用语音、视觉与多模态技术缩短人与智能之间的距离。逼格不低,不排除这款产品成为Soul在社交业务之外,在AI语音场景的一次重要尝试。
Soul把AI语音和实时视频通话、数字人打包推向市场
《读佳》实测Soul旗下AI产品Loxinity发现,这套产品基于语音合成模型Loxi Speech和视频生成模型Loxi Avatar。而且不只是单一语音合成工具,而是一套面向实时交互的AI音视频一体化方案,核心分为语音合成、实时视频通话与数字人三大板块。
语音合成模块支持单人配音、多人对话,配套音色克隆、音色设计功能,还能添加副语言、拼音与情绪标记。它的优化重心放在对话场景,着重还原真人说话的停顿、语气起伏,同时开放API接入,采用积分、订阅套餐两种计费模式。
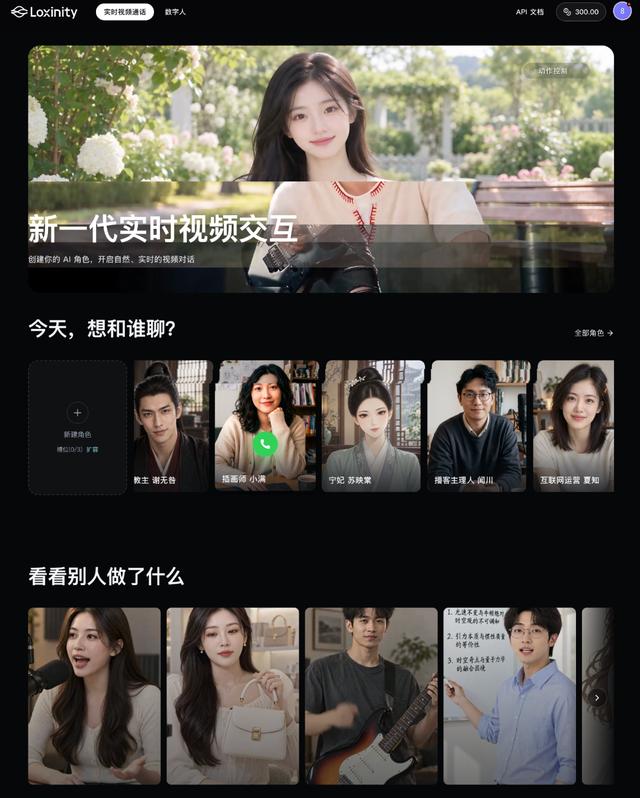
数字人与实时视频通话板块,是这套产品的另一重点。用户可上传图片自定义数字人形象,输入文本脚本或是上传音频,生成对应数字人视频。
平台预置了真人、二次元、奇幻风格等多种角色,用来搭建可实时对话的AI虚拟角色,页面也陈列了大量访谈、讲课类的用户创作案例。
整体来看,Loxinity避开拥挤的通用大模型赛道,专攻交互型音视频AI。很多同类数字人工具存在声音朗读感重、音画脱节的问题,Loxinity选择原生打通语音和数字人驱动,让语音能力服务连续对话。
当然它仍有不确定之处。这类实时交互产品,核心瓶颈在长时间对话稳定性、端到端延迟。离开Soul内部社交场景后,面向外部B端交付,并发能力、使用成本、数字人微表情自然度,都还需要更多落地项目验证。这套出自社交平台的AI交互产品,最终能在市场拿到多少认可,仍有待观察。
从站内社交走向对外输出:Soul押注交互AI
年轻人对AI的核心诉求不是文字问答,而是带有情绪、接近真人的沉浸式交互。早在Loxinity落地之前,Soul就已经在站内做过多轮落地尝试。
2022年,Soul上线AI聊天机器人“AI苟蛋”,作为初代AI陪伴角色,主打生活化对话、主动情绪关怀,不再局限于问答式交互。同期推出NAWA虚拟形象引擎,用户可以自制虚拟Avatar,把AI对话放进虚拟形象载体里,搭建虚拟社交场景。2023年,Soul正式发布自研情绪向垂类大模型SoulX,定位情绪感知交互底座,不再跟风做通用大模型,重点强化AI读懂情绪、维持人设、长上下文记忆的能力。
依托SoulX底座,一系列AI社交产品接连落地。平台上线AI绘画、AI 次元歌手,供用户制作虚拟分身与AI人声;推出端到端全双工语音模型,在群聊派对中落地AI主持人,支持实时插话、自然打断,复刻真实多人闲聊的对话节奏,摆脱机械交互。站内狼人杀、虚拟伴侣等场景,都接入这套语音能力,实现长轮次连续语音对话。这些站内场景,都为持续迭代打磨这套“活人感”交互技术提供了场景。
通用大模型赛道早已巨头扎堆,Soul没有正面硬刚,而是选择情绪交互赛道。多年社交业务积累的海量真人对话样本,是它打磨副语言、自然对话节奏的核心壁垒。
但挑战同样明确:站内场景验证可行的交互能力,向外交付给B端客户时,并发承载、实时延迟、项目成本都是硬性门槛,这套AI能力的商业化潜力,还需要市场落地案例来检验。#Soul#Soul推出AI产品#Soul推出Loxinity




 简体中文
 English