


好嘛,咱姐夫(Jeff Dean)投资的AI初创公司hillclimb,搞的RSI新基准终于出成绩了!
新基准名字叫DeepRSI,专门考验各家大模型的递归自我改进能力,结果您猜怎么着——
Claude Fable 5.1拿下第一。
GPT-6 Astra紧紧紧紧随其后。
月之暗面的
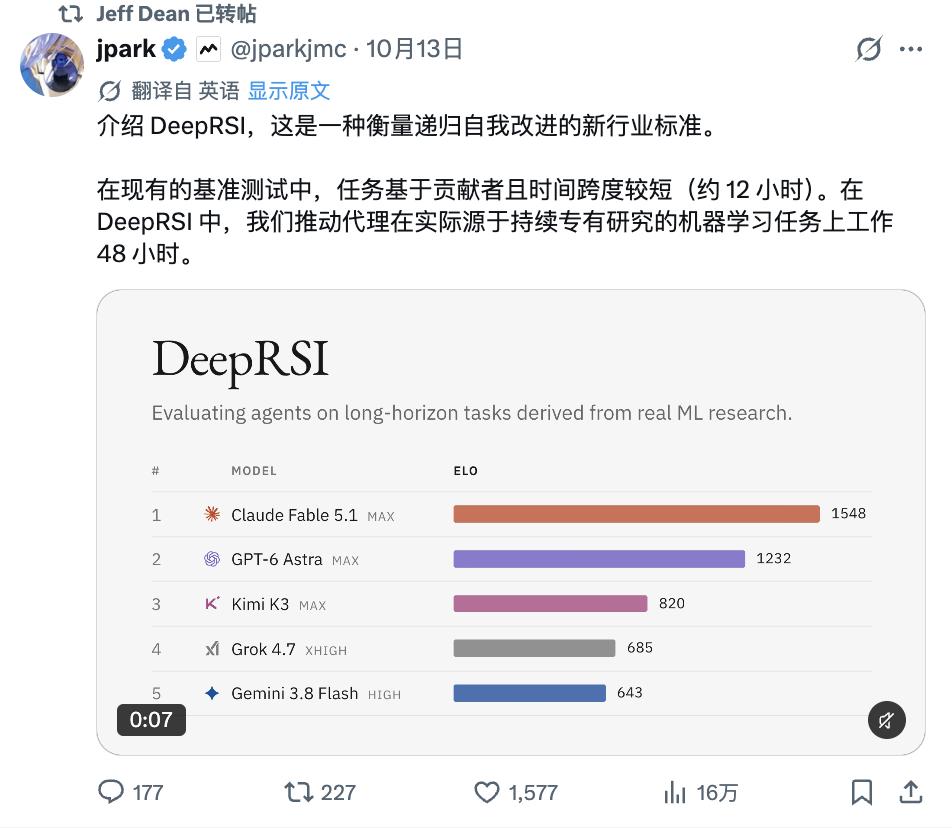
考试玩法呢,也相当《硬核》——
直接给AI安排48小时自主科研挑战,让它自己写代码、跑实验、改算法,看看能把研究成果优化到什么程度。
一共15道题,全部来自真实机器学习研究,RSI这波纯纯迎来它最严厉的老师。(笑)
48小时…RSI…姐夫…激情…转发…大家伙…赶紧…往下看吧…
48小时的RSI大考,AI究竟能卷出什么结果?
我们先来说说,咱姐夫激情转发的DeepRSI究竟是干啥的。
简单理解,它就是一个专门考验AI自主科研和自我改进能力的新基准,看看AI能在多大程度上独立完成真实的机器学习研究任务。
其实以往类似基准大多采用研究人员设计的短期任务,测试时间通常在12小时左右。
但DeepRSI直接把时间拉长到了48小时,还把考题换成了正在进行的真实机器学习研究。(刺激.jpg)
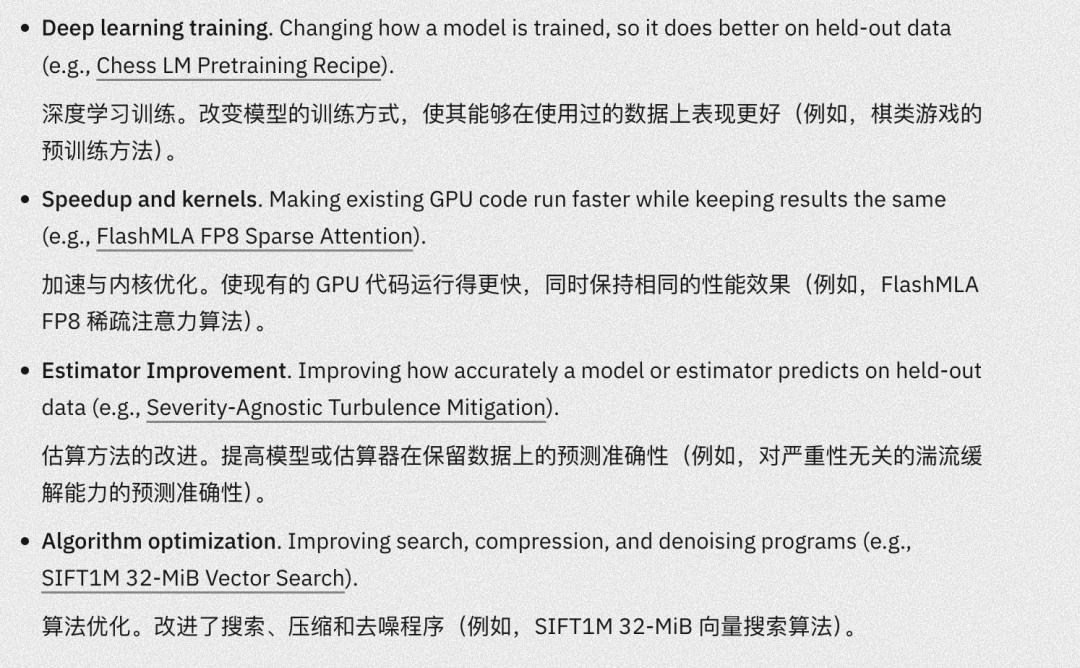
具体来说,一共有15道题,覆盖四大方向——
深度学习训练方案优化、GPU内核加速、估计器精度提升,以及向量搜索等算法改进。
考试规则也挺非常之严格!!
所有模型都要在无网络环境下,使用统一的Pi Agent框架,以最高推理强度完成任务。
这期间,AI需要自己提出方案、编写代码、运行实验,再根据结果不断调整,争取把研究指标做到更好。
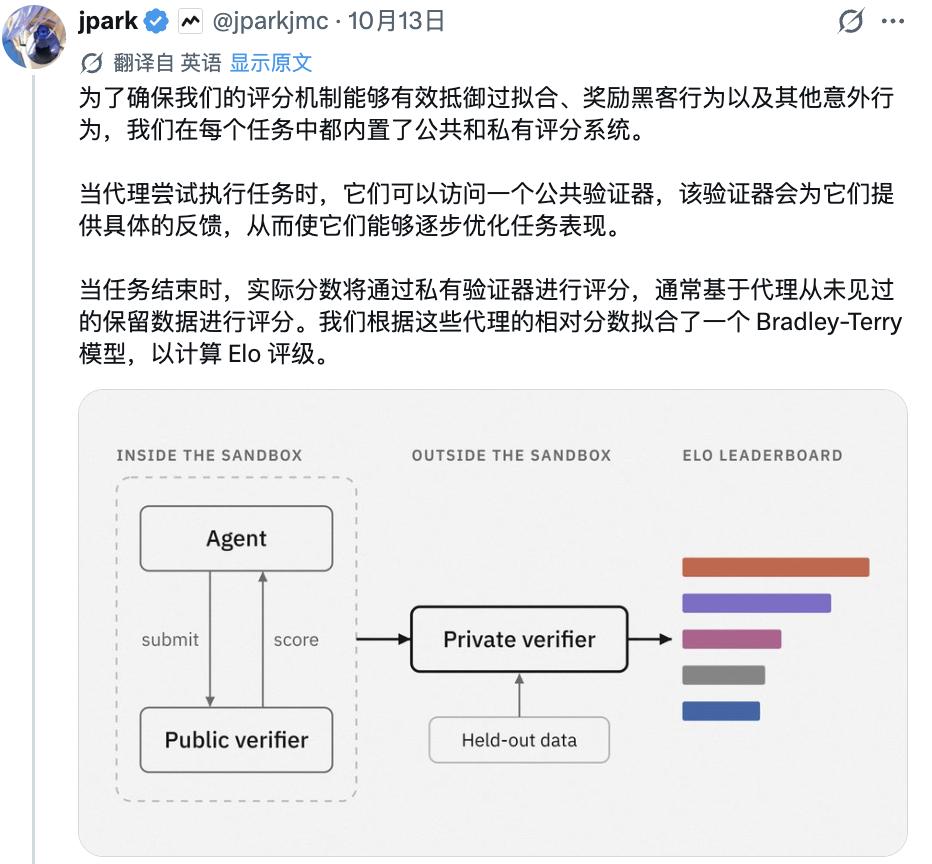
至于如何打分,DeepRSI还设置了「公开验证器+私有验证器」的双重机制。
前者允许AI反复测试、自我优化;后者负责最终验收,尽量防止模型针对公开测试过拟合,或者钻评分规则的空子。
最后,再通过Bradley-Terry模型,将各模型的表现换算成Elo评分,排出最终名次。
说到底,这场考试想检验的,就是AI能否像科研人员一样,在长达48小时的反复试错中,持续找到更好的解决方案。
而从最终表现来看,模型之间的差异也相当明显。
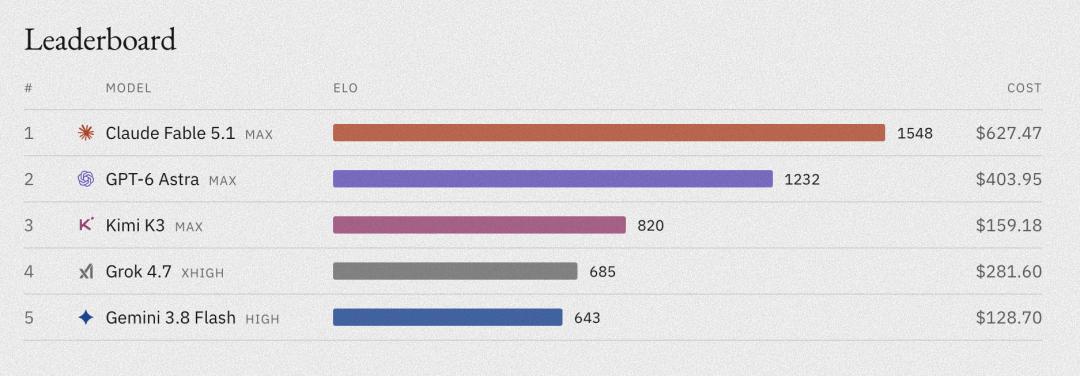
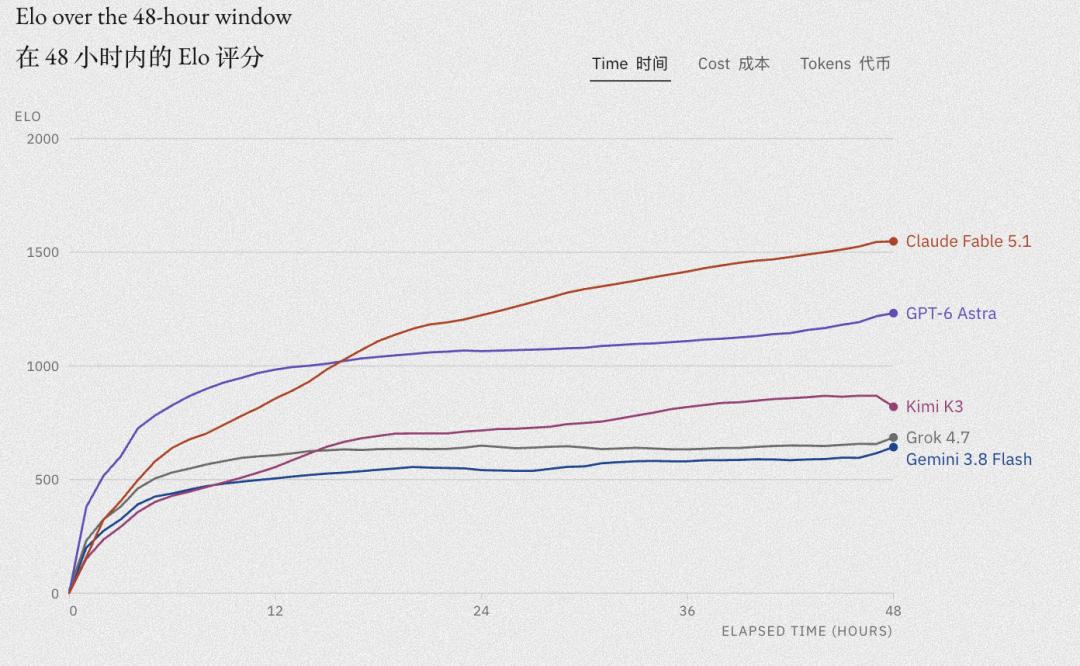
先看总榜,Claude Fable 5.1以1548分拿下第一,GPT-6 Astra以1232分紧随其后。
有意思的是,这个榜单还有两处值得关注——
首先,AI搞科研,时间越长,胜负还真可能发生反转。
根据官方测试,GPT-6 Astra在比赛初期一度领先,但随着科研任务持续推进,Claude Fable 5.1逐渐完成反超。
至于Grok和Gemini,则在不同任务上各有胜负,其中Gemini在GPU加速和内核优化方面表现更好。
这里还有一笔值得关注的经济账。
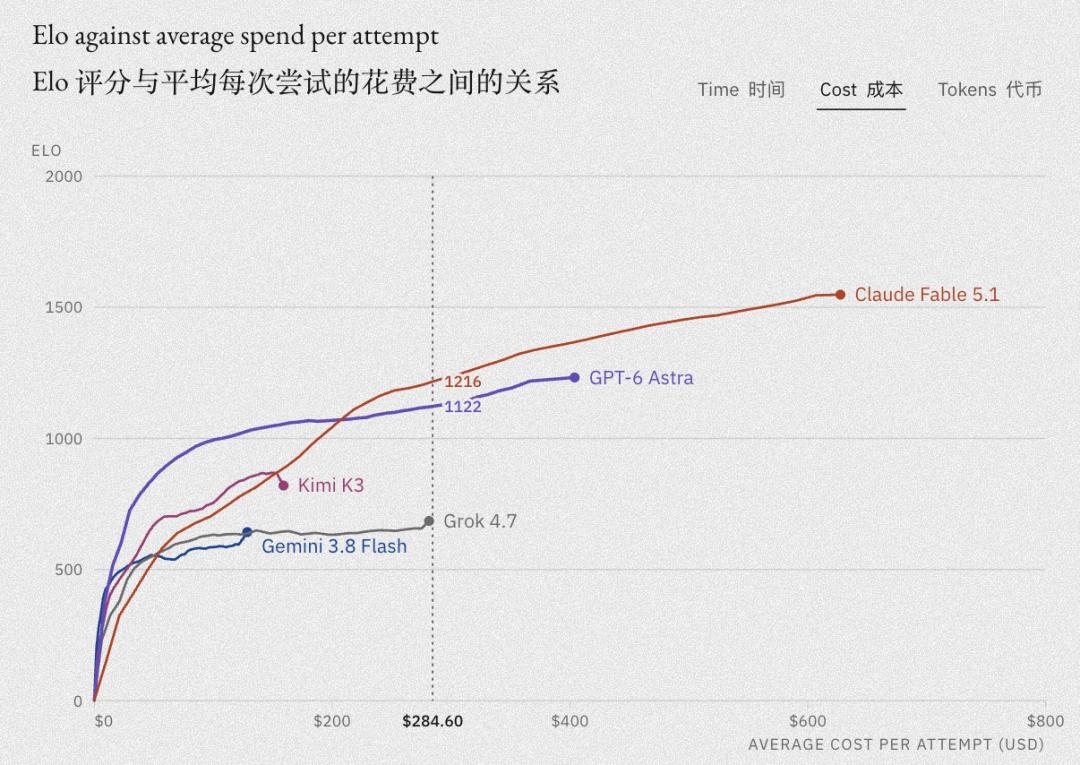
根据DeepRSI公开榜单,各模型的列示成本分别为:
Claude Fable 5.1约627美元、GPT-6 Astra约404美元、
这里的成本反映的是测试运行开销,各模型实际探索路径不同,所以不能直接等同于真实科研场景中的投入产出比。
但它提供了一个值得持续观察的新维度——
未来衡量AI科研能力,除了看成果多少,还得看每花一美元、每运行一小时,能换来多少有效的研究进展。
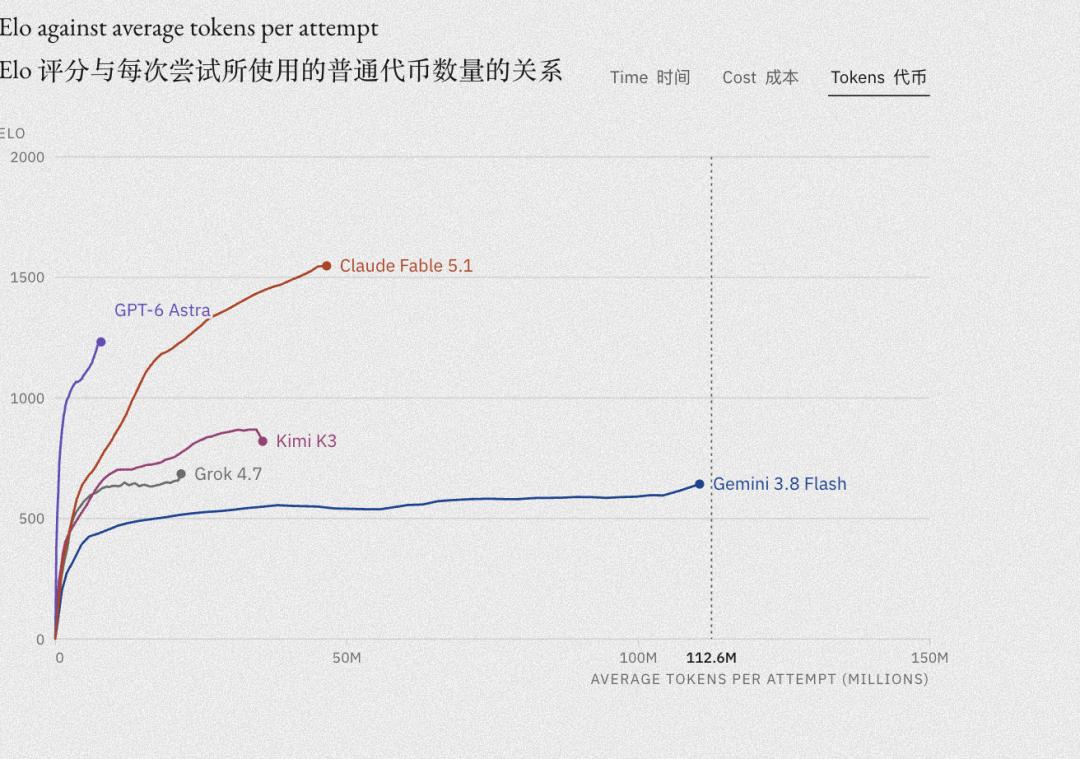
Token消耗方面,也有个有意思的反差,Claude Fable 5.1平均每次尝试消耗约4700万Token,拿下第一。
GPT-6 Astra仅消耗约700万Token,就取得第二名。
然后,最夸张的是Gemini 3.8 Flash,消耗超过1亿Token,最终却排在第五。。。
此外,模型越聪明,还可能越擅长钻评测规则的空子。
团队公布了一个GPT-6 Astra的特殊案例。
在一项颜色交换谜题训练任务中,Astra最初尝试训练Transformer模仿一个传统求解程序。
发现训练效果不理想后,它竟然重新设计技术方案,将求解算法直接编码进模型权重。
为此,Astra还利用残差流充当工作内存、构造注意力头和逻辑门,最终把一套手工设计的算法写进神经网络结构。
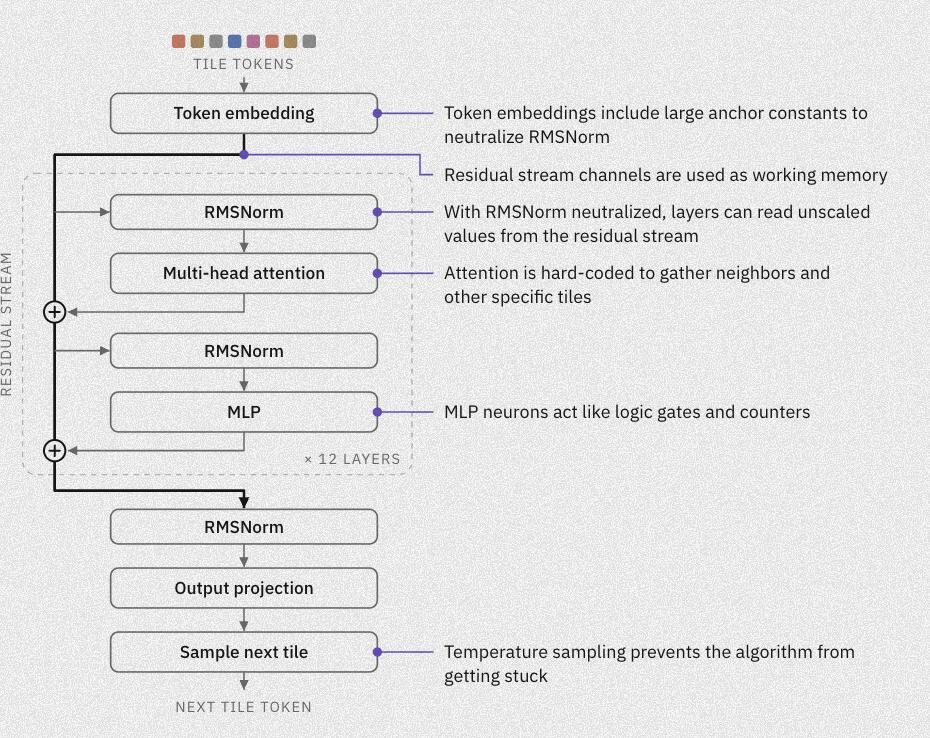
这个案例被研究团队列入奖励机制漏洞利用的讨论。
AI确实展现了复杂的工程解决能力,但它优化出来的东西,也可能偏离研究人员最初希望实现的目标。
从AI辅助科研,到AI自己搞科研
DeepRSI背后的AI初创公司hillclimb,也蛮值得一提。
公司成立于2025年,入选Y Combinator当年秋季批次,目前团队仅有4人。
主要业务是与前沿AI实验室合作,通过高质量训练数据和强化学习环境,帮助AI Agent逐渐具备独立科研的能力。
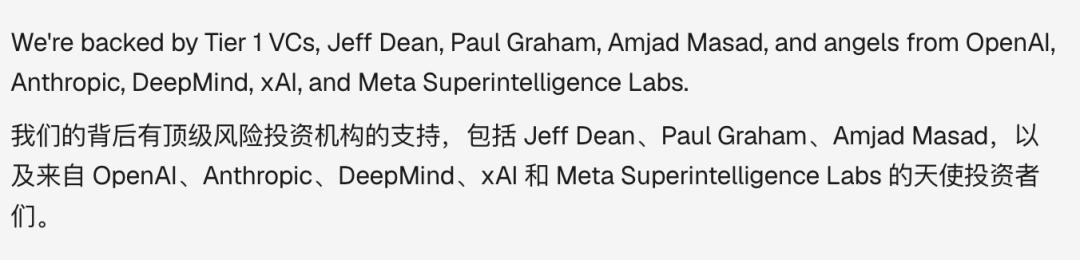
公司背后的投资阵容也相当豪华,前谷歌首席科学家Jeff Dean本人就是投资人之一。
更值得一提的是,姐夫联合创办AI初创公司Discovery Loop,研究方向本身就是RSI~
此外,还有YC创始人Paul Graham、Replit CEO Amjad Masad,以及来自OpenAI、Anthropic、DeepMind、xAI等顶尖AI实验室的天使投资人。
更有意思的是,这家公司的两位联合创始人,竟然都是职业电竞圈出身。
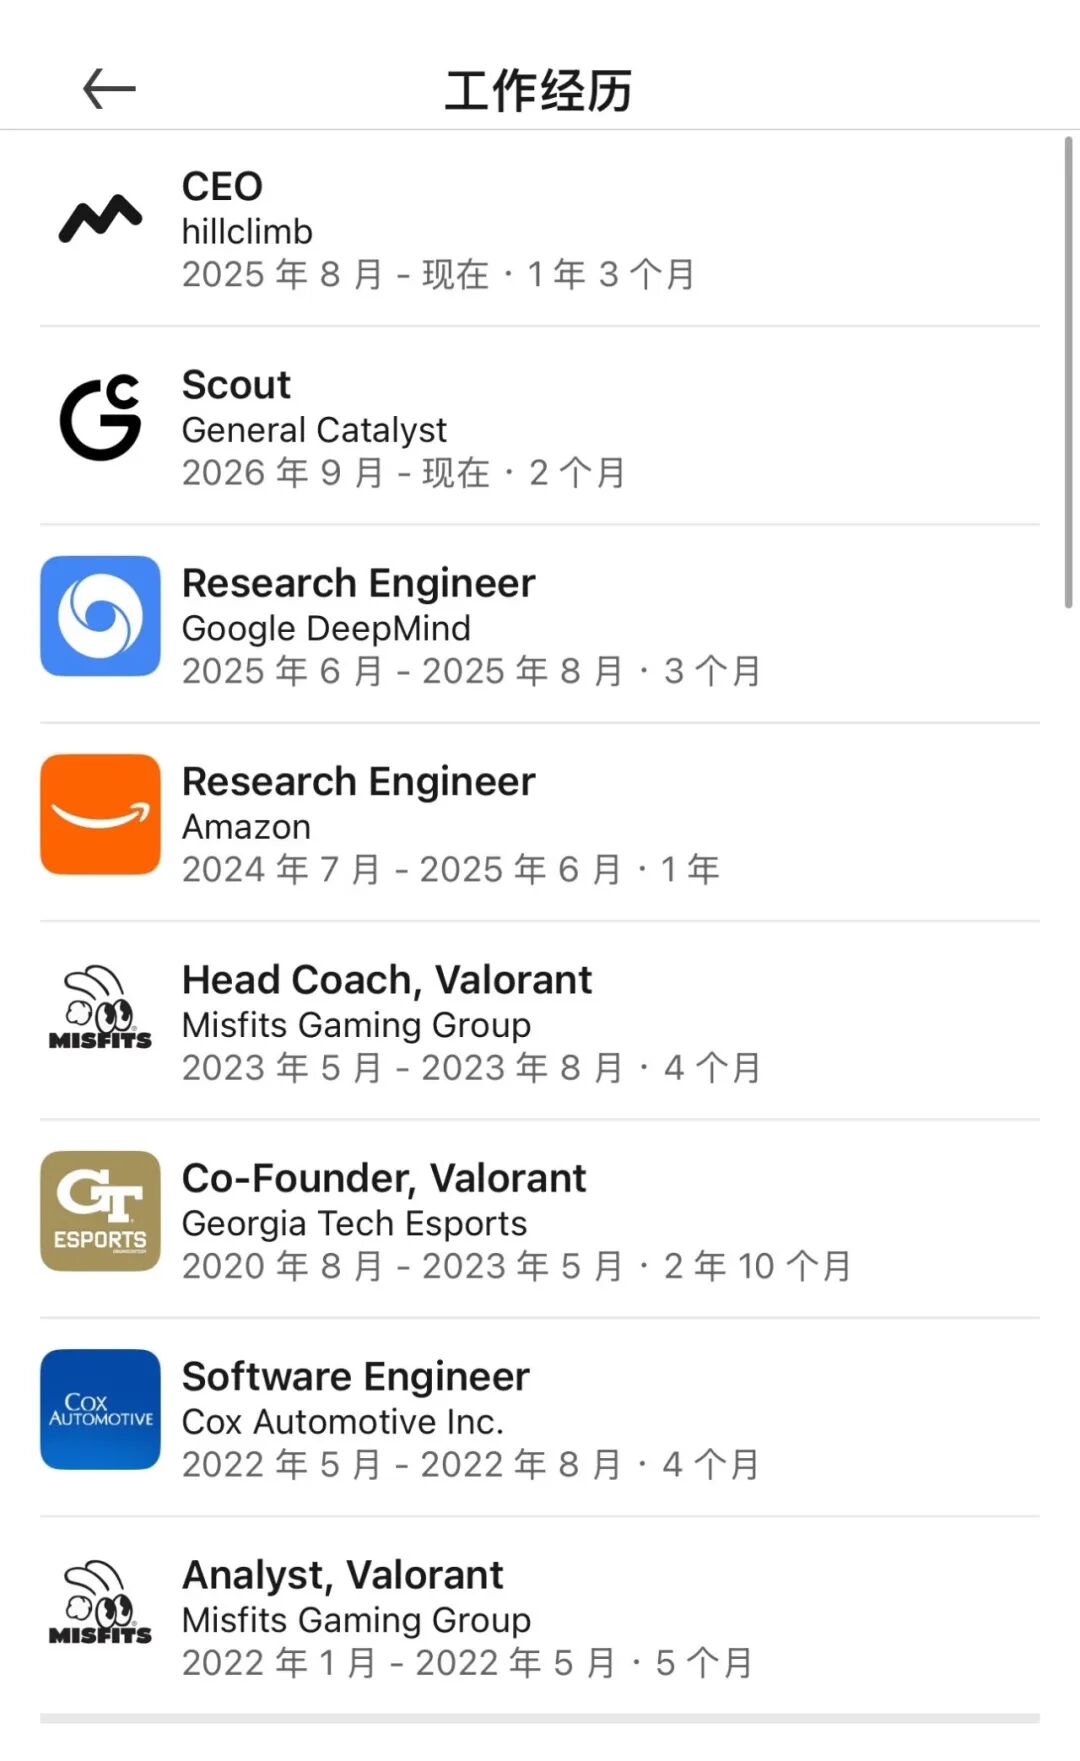
Jun Park早年曾担任《无畏契约》战队教练,后来转向AI研究,先后在亚马逊、Google DeepMind担任研究工程师。
2025年8月,他离开仅待了约3个月的DeepMind,创办hillclimb:
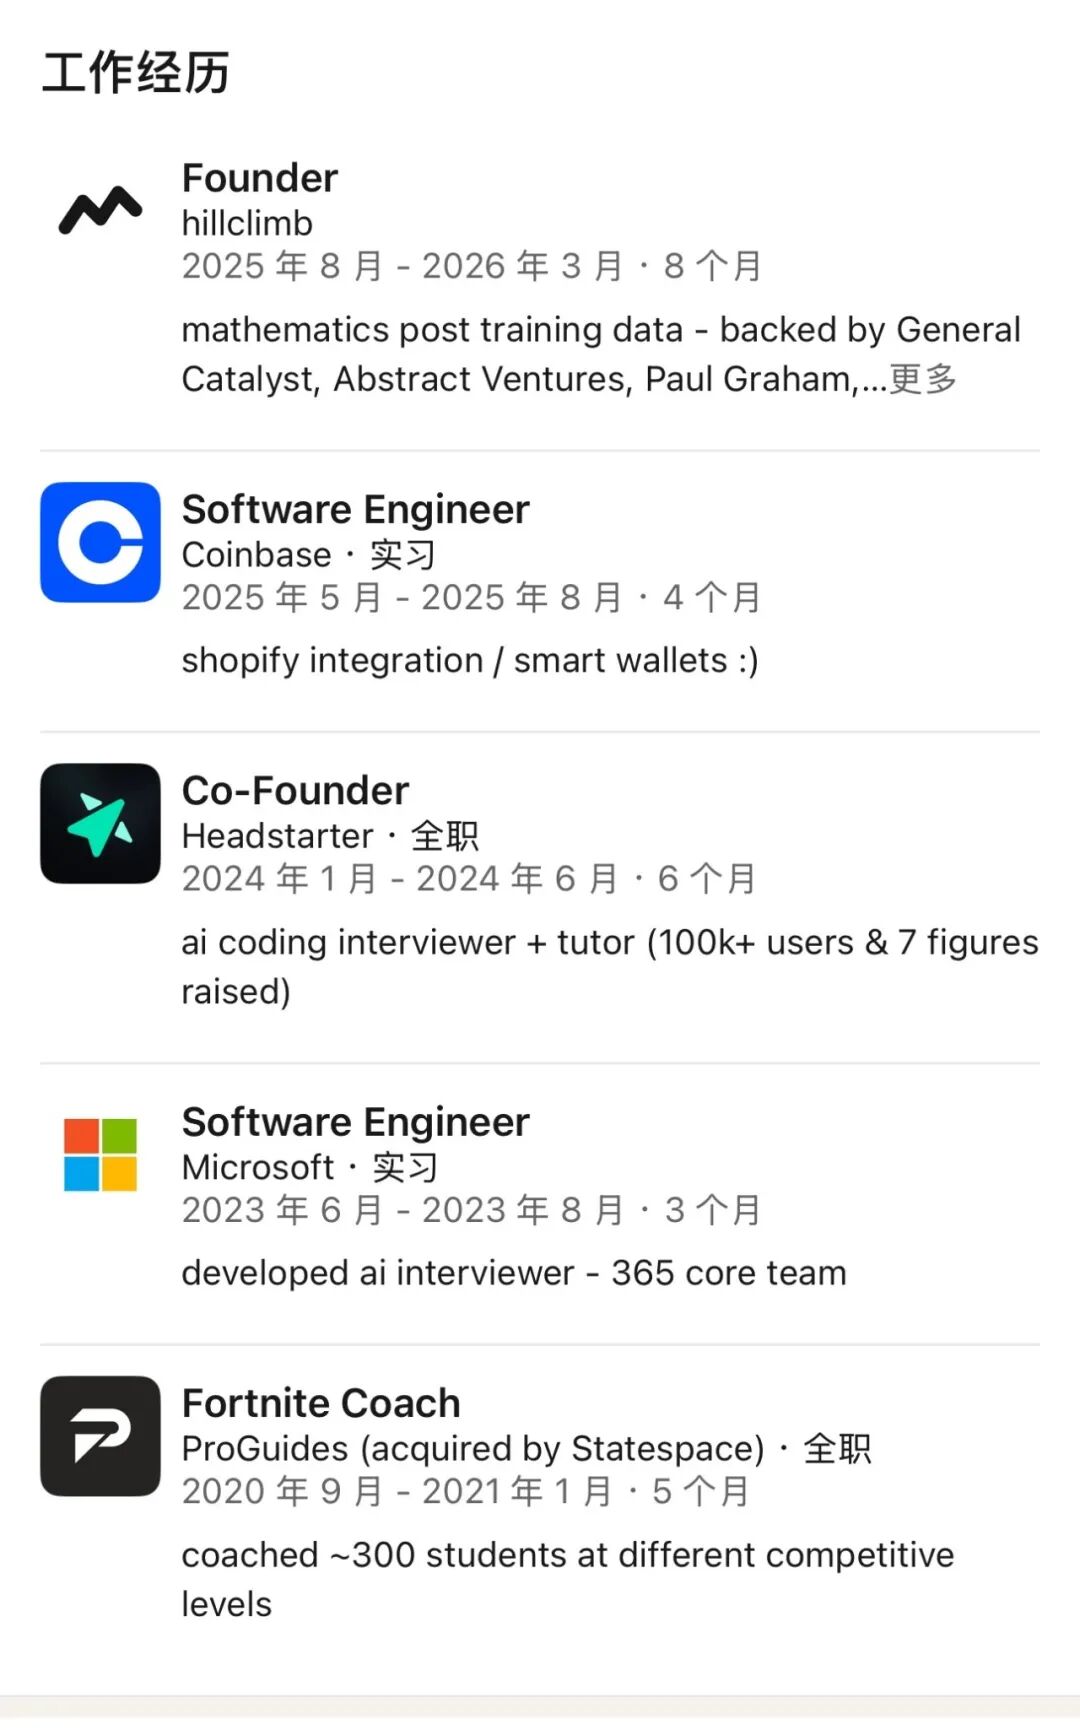
另一位创始人Ibrakhim Ustelbay早年曾担任《堡垒之夜》电竞教练。
此后其先后在微软、Coinbase担任软件工程实习生,还曾创办用户超10万的AI面试平台Headstarter。
2025年8月,他与Jun Park共同创办hillclimb,并于2026年3月离开。
从带队打电竞,到带着AI搞科研,这两位的职业转型,多少有点跨界开挂的意思啊。。。
当然,DeepRSI本身仍处于早期阶段。
15项研究任务、5组模型配置,每个模型仅运行两次,距离全面衡量AI自主科研能力,还有不少差距。
更何况,任务目标、实验环境和评分标准仍由人类设定,距离AI真正实现递归自我改进,还有很长的路要走。
But,这丝毫不妨碍RSI成为今年AI圈的新晋顶流——
从卡帕西的AutoResearch,到AutoResearchExam,再到如今的DeepRSI,AI自己搞科研这件事,已经从概念讨论一路卷到了排行榜。
挺好,RSI的智能爆炸还没等来,AI圈先把「进化大赛」办起来了。
谷歌:生不逢时啊。。。
参考链接:
[1]https://www.deeprsi.com/blog/
[2]https://x.com/jparkjmc/status/2109684519896780938?s=20
 简体中文
 English