


何恺明团队的新论文,在X上炸了!
十一期间刚挂上arXiv的VISTA论文显示,过去半年,全世界最顶尖的大模型,全是被「蒙着眼睛」赶上AGI考场的。
同一个Claude Opus 5,在官方标准测试里只拿了可怜的40分。
何恺明团队只不过帮它摘掉了眼罩,让它亲眼看游戏画面,顺手递给它一本能随时往回翻的「相册」。
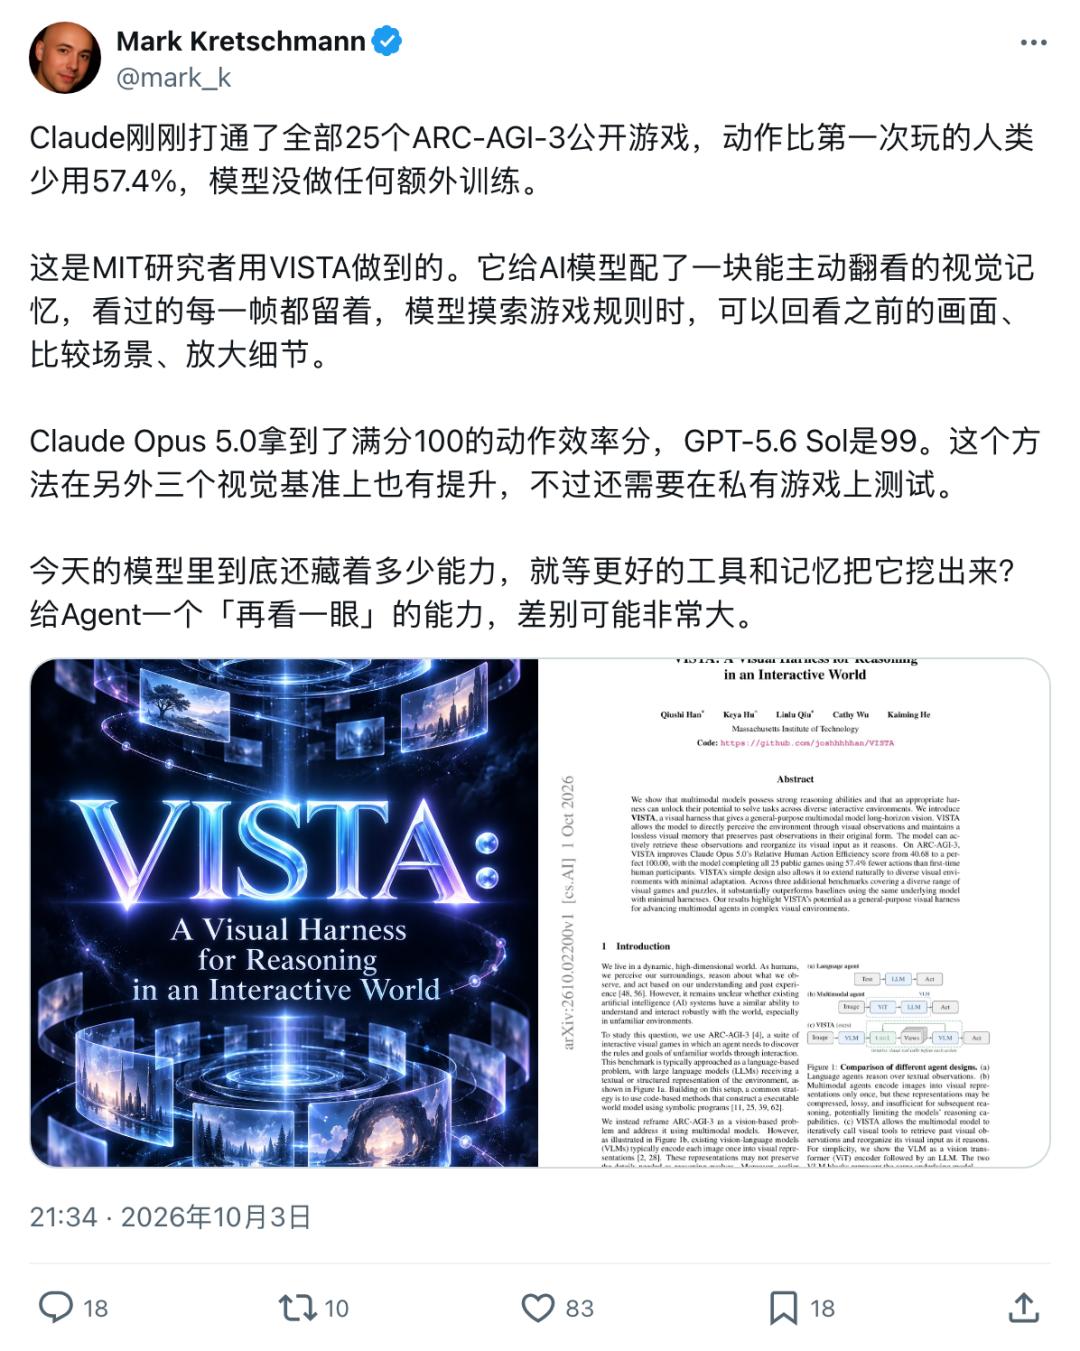
结果,Claude直接把ARC-AGI-3的25个公开游戏全部打穿,拿下100分满分!
而且它走的步数,甚至比第一次玩的人类还少了一半多。
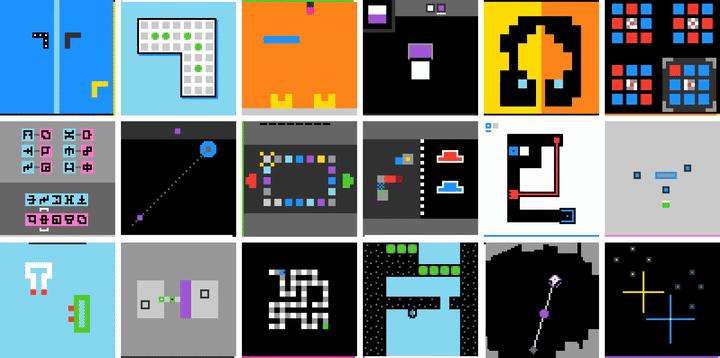
18个从没见过的游戏,没人给它一句说明,AI自己摸清规则一路通关
知名AI博主Mark Kretschmann在X上写道:「给Agent一个『再看一眼』的能力,差别可能非常大。」
过去几个月,为了打穿ARC-AGI-3,各路代码大神写了几千行代码搞世界模拟器。
何恺明团队的判断是,大模型的脑子早就够用了,卡住它的,是眼睛和记性。
大模型被一张数字表,坑了半年
ARC-AGI-3,是Keras之父François Chollet和ARC Prize基金会今年3月出的AGI考卷。一堆交互式像素小游戏,开局没有任何说明和规则,全靠玩家自己摸索试错。
分数算法极其严苛。官方找来近500名人类小白实测,AI不光要通关,步数还不能比人类多,才能拿满分。
可官方考场递给大模型的,只是一张64×64的数字表。人类看到的小人、机关和路线,到了模型那里只剩4096个数字。
这相当于让人闭着眼,听别人报坐标去玩《超级马里奥》。
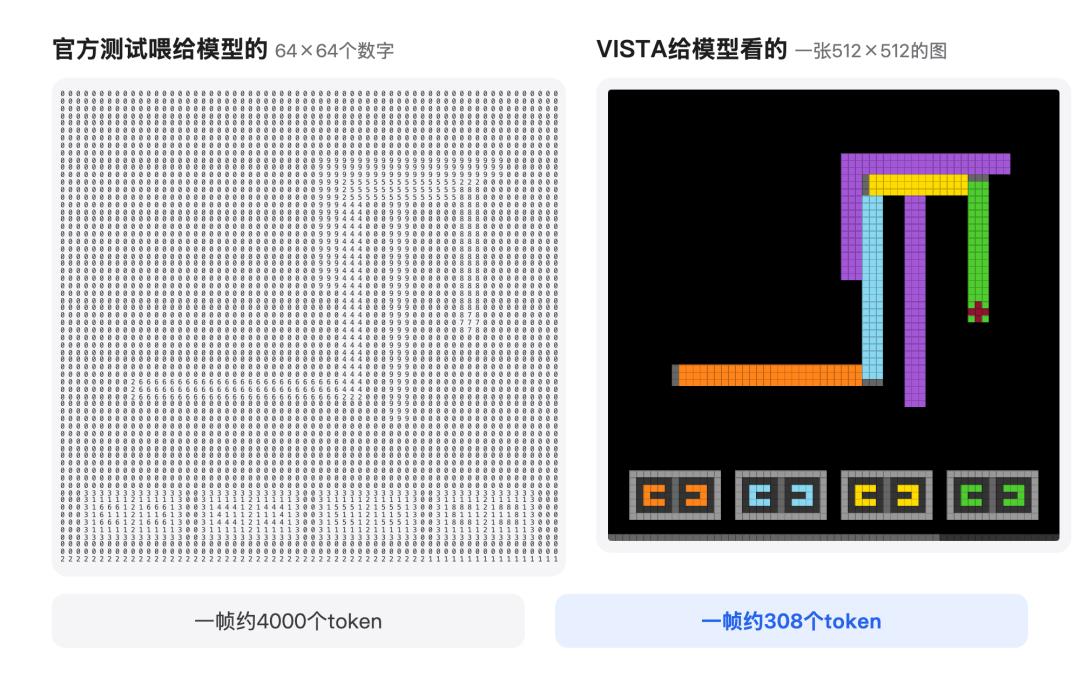
同一帧画面,左边是官方递给模型的数字表,右边是VISTA让它直接看的图
VISTA团队做的第一件事,就是把数字表换回图片。
别的什么都没改,GPT-5.6 Sol的分数就从13.33分跳到了47.32分。
看图还更省算力。一个数字格子要吃掉约4000个Token,一张512×512的图片只要308个。
一局跑下来,文本版烧掉7190万Token,图片版只要3070万,分数还更高。
光是换上一双真正的眼睛,大模型就捡回了34分。
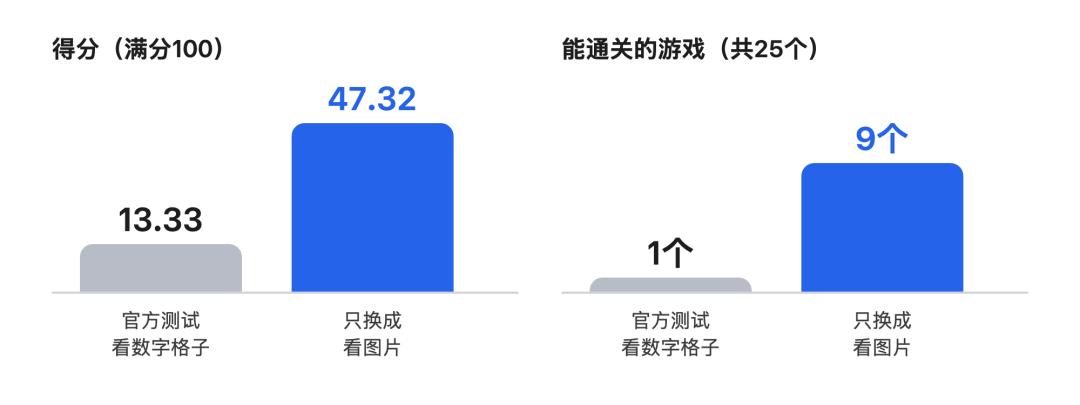
只把数字换成图片,GPT-5.6 Sol的分数涨了三倍多,能通关的游戏从1个变成9个
让AI过目不忘,一步多拿24分
光能看见还不够。一局游戏动辄几百步,多模态模型的通病是:图片看一遍,上下文一满就删,或者压缩成几句文字摘要。
等模型想回头核对细节时,那一帧早就灰飞烟灭了。
VISTA的核心杀招,就是一本无损视觉记忆「相册」。
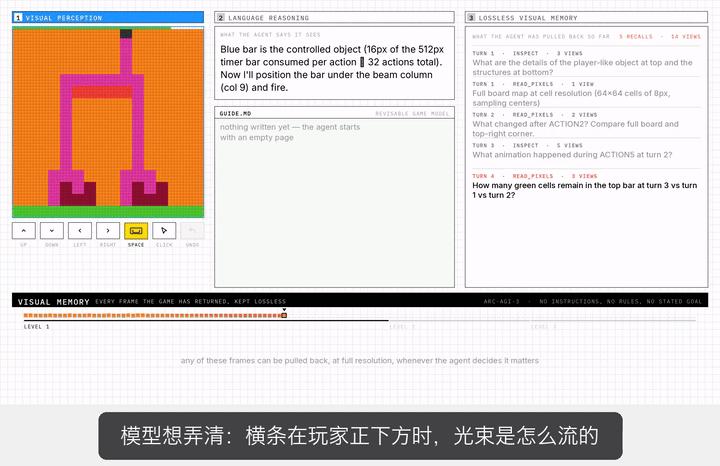
游戏吐出的每一帧画面,连动画帧在内,全按编号原样存档。模型想看哪一帧,随时调用inspect翻出来,几帧并排对比、角落放大都行,还能用read_pixels读出精确颜色。
最重要的是,翻相册不算步数,只有真在游戏里操作才计步。
团队把这套机制叫作「显式注意力」,翻哪一帧、看哪一块,全由模型自己说了算。
它还随身带着两个笔记本,GUIDE.md记游戏规则,WORKING.md当草稿纸。
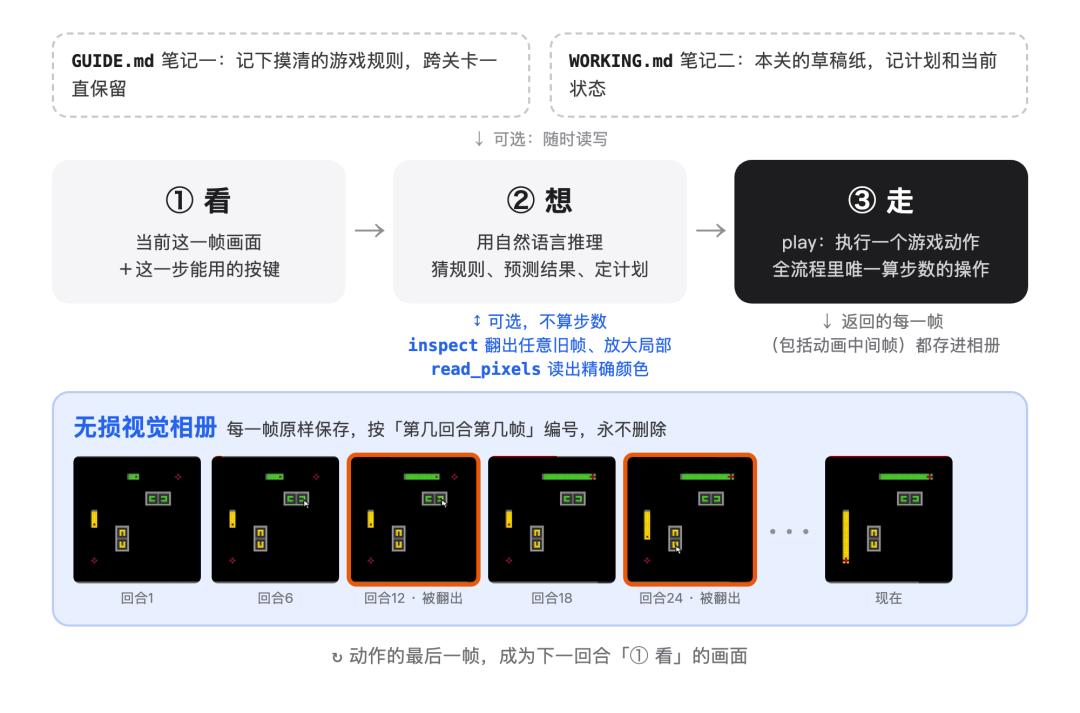
VISTA的一个回合,模型看画面、想规则,需要时翻相册,最后才走一步
论文里记录了一个极度「像人」的操作瞬间。
在BP35游戏第3关,画面出现了一个橙色方块。模型点了一下,橙块变成了X。
它先停了下来,把上一回合的最后一帧和刚才的三帧动画调出来,并排回放。
几回合后,它又发现点X能让橙块重新长出来,当场写道:「这就是我要的工具,用它搭天花板,挡住会要命的上升。」
这一关,第一次玩的人类要走44步,它只用了34步。
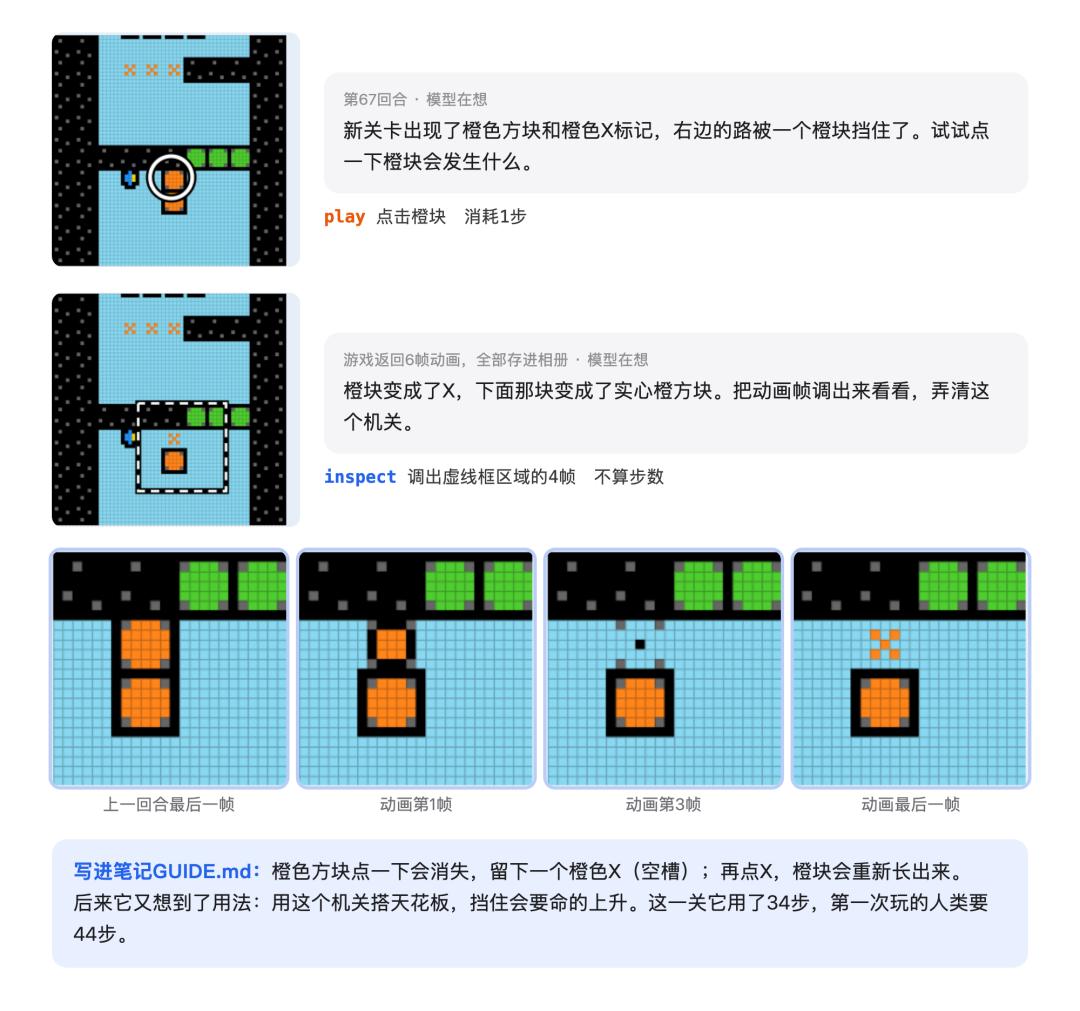
点完橙块,模型先把前后4帧动画调出来逐帧比对,看懂了才接着走
到了《吃豆人》里,迷宫里的豆子吃一颗少一颗。模型干脆在第13回合和第36回合,两次强行翻回开局第一帧去记迷宫地图找路。
给模型多塞上下文、多给像素,是很多人的第一反应。论文测下来,这两招都不灵。
上下文从默认的200K开到780K,每局Token从3070万涨到1.057亿,成绩却从99分退到93.9。
图片也是这样。放大到16倍,每帧Token涨到1229个,成绩只剩88.3;只放大4倍,成绩是99.7,比默认的8倍还高。
论文的解释是,图片太大,多出来的Token白白占掉上下文,模型却没有因此看得更明白。
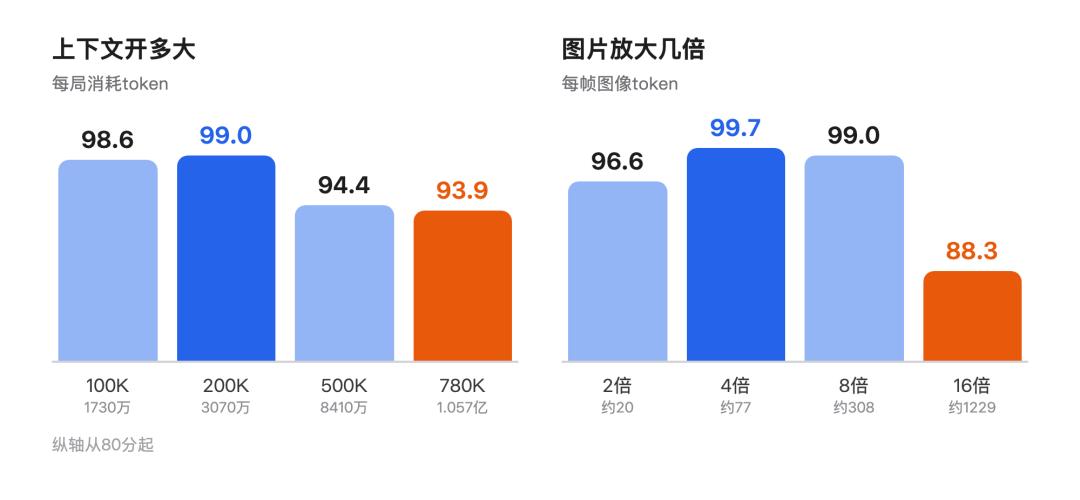
上下文从200K拉到780K、图片从8倍放到16倍,分数都不升反降
多给不一定更好,VISTA整套设计走的都是这个思路,团队在博客里说,他们刻意追求极简。
系统里没有一个新训练的模型,每个游戏的提示词都是同一份,一共四句话,没有一个字教它具体怎么玩。
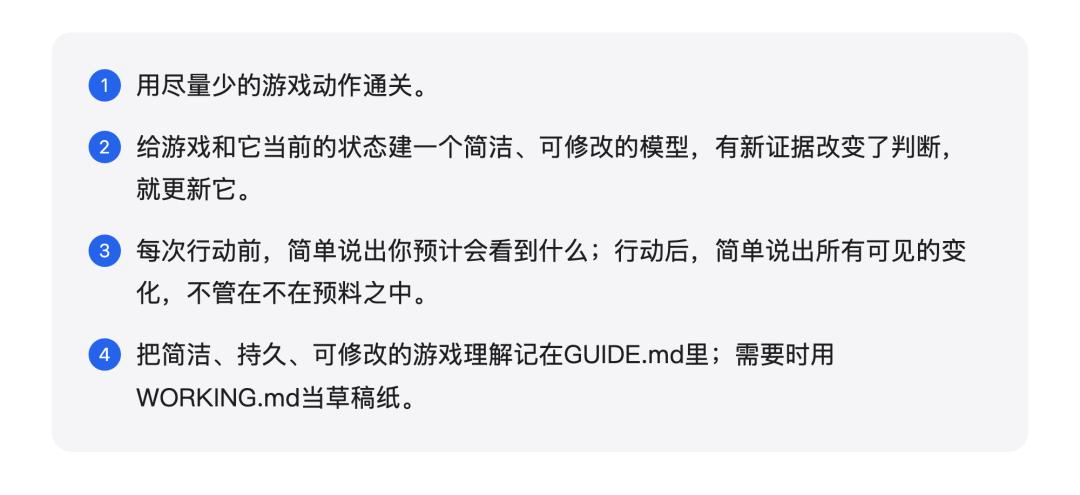
VISTA给模型的全部提示词
代码派卷了一夏天,它一页笔记就追平
这个夏天刷爆ARC-AGI-3的高分方案,比如Tycho和Schema,都是让大模型给每个游戏写一套能运行的程序,硬造一个模拟器来反复试错。
光跳棋游戏LF52一个,Schema就写了整整4000行Python。
而VISTA里的模型,只用自然语言在笔记里写了三句话,就搞定了同样的规则。
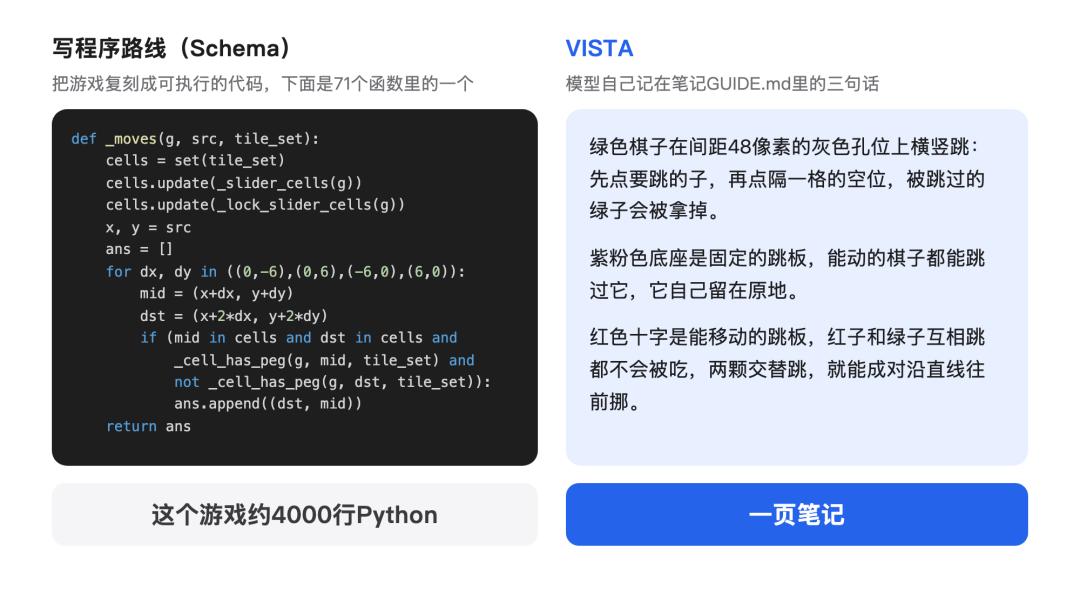
同一条跳棋规则,左边是程序路线的代码(全部约4000行),右边是VISTA的模型自己记的三句笔记
按论文的说法,VISTA是第一个不靠写程序,就在ARC-AGI-3上做到满分或近满分的系统。
这一点放到游戏之外更要紧,真实世界里,没有谁能提前给你写好一套4000行的模拟器。
Claude Opus 5打通了25个游戏的全部183关,每个游戏都是100分,总共走了7302步,只有人类的0.43倍。
GPT-5.6 Sol同样全部通关,拿到99分。
m0r0这个游戏,人类要走1107步,Claude只用了219步。两份成绩在ARC Prize官方平台上都有记分卡。
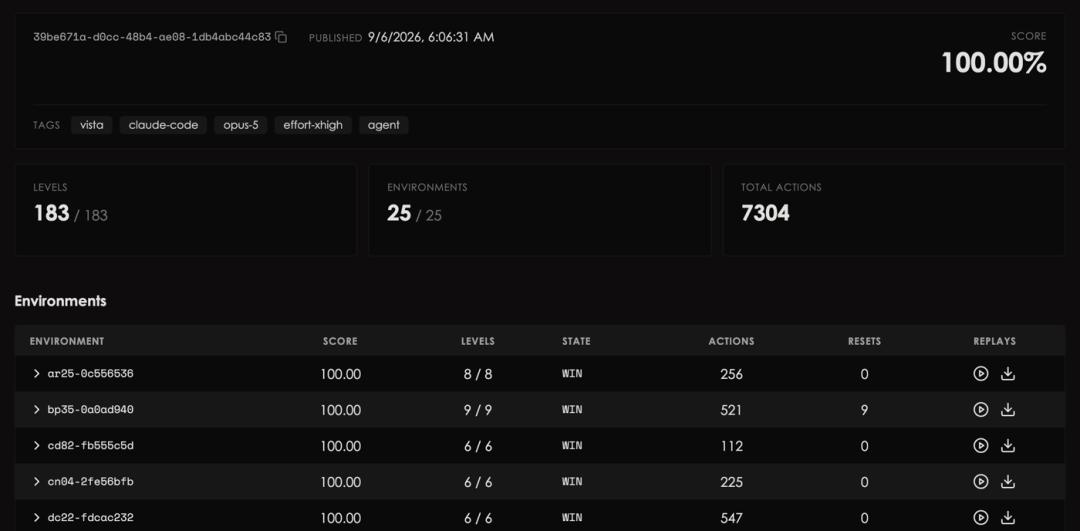
ARC Prize官方平台上的记分卡,183关全部通关,25个游戏全是满分
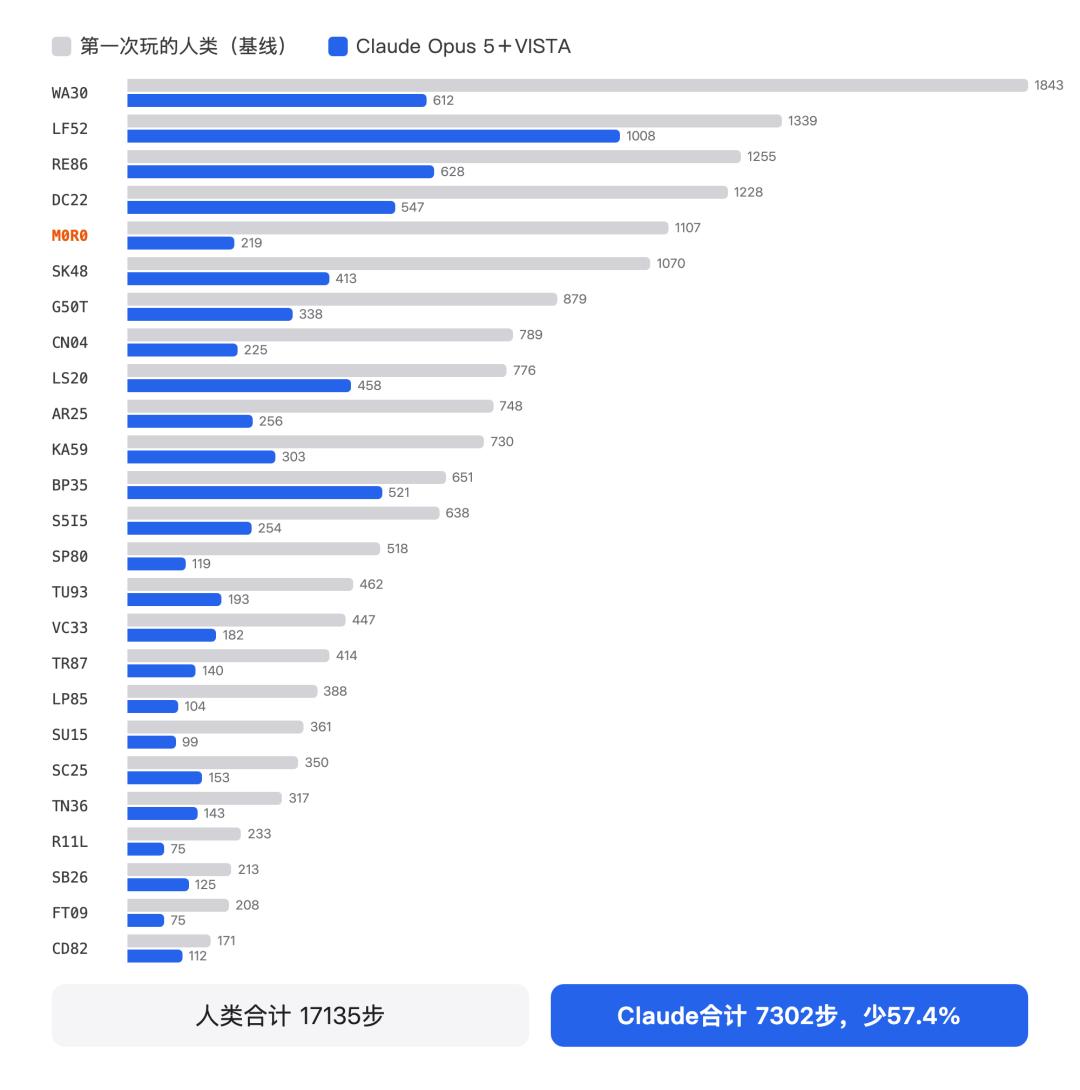
25个游戏挨个比,蓝条全都比灰条短,蓝色是Claude,灰色是第一次玩的人类
这套纯机械、0训练的Harness极其泛用。
把它塞进带透视的3D画面里,照样拿下84.12分。
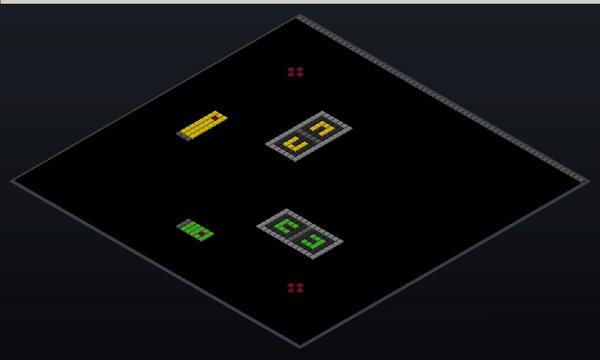
套上GPT-5.6 Sol扔进34个网页游戏(包含马里奥、2048、我的世界等),任务成功率63.3%,直接压过人类小白(55.3%)。
就连静态的看图题也能用上。BabyVision的一道连线题,不用VISTA时模型把驼鹿和兔子连反了,用上VISTA放大一看,就答对了。
哪怕是用官方实现几乎交了白卷(1.89分)的320B开源模型,套上VISTA后硬生生被抬到了66.93分,暴涨35倍!
一年三篇,何恺明团队死磕视觉
ARC测试的主流解法,一直是被大语言模型垄断的文本推理。
但何恺明团队偏不信邪,一年连发三篇,死磕同一件事:ARC是视觉问题。
第一篇VARC,1800万参数的小号视觉模型从零训练,纯看图就追平了人类平均分。
第二篇NAT-ARC,先让模型在ImageNet上看猫看狗补课,抽象推理跟着变强。
第三篇就是VISTA,小模型都不练了,直接给前沿大模型配上「相册」。
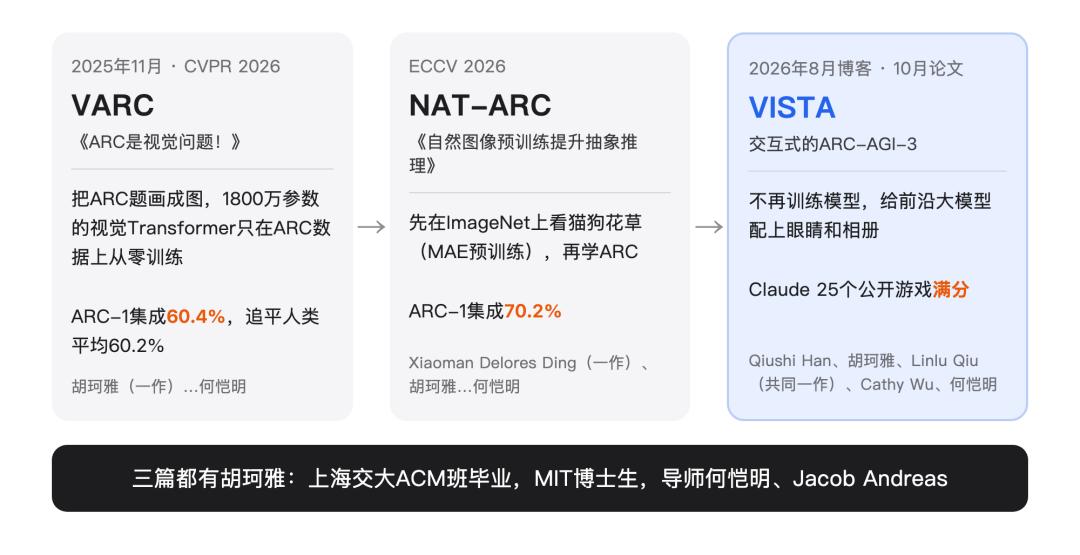
何恺明组一年三篇ARC论文,押的都是「ARC是视觉问题」
串起三篇论文的,是何恺明的博士生胡珂雅,本科出自上海交大ACM班,三篇里两篇一作、一篇二作。
VISTA另外两位共同一作是MIT博士生Qiushi Han和Linlu Qiu,MIT副教授Cathy Wu也在作者之列。
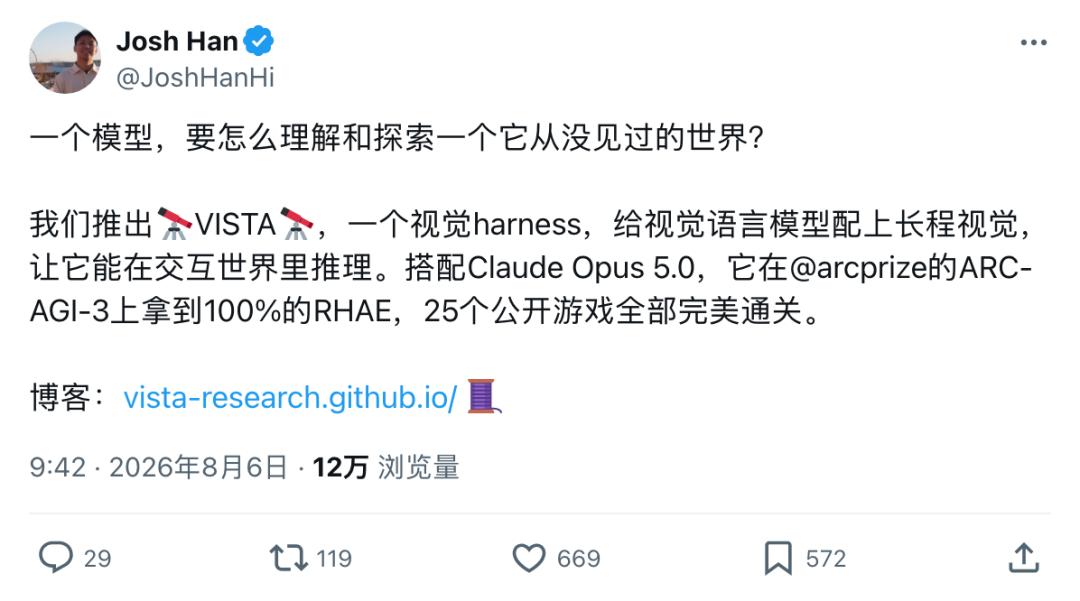
曾经靠ResNet和MAE封神的何恺明,这一次把视觉路线一路推进了AGI考场。
这也是在挑战整个行业的默认路线。
过去几年,大家拼命把模型做大、把推理拉长,智能的进步几乎都押在模型本身。
VISTA让同一个Claude从40分打到满分,靠的却是模型外面的一双眼睛和一本相册。
ARC Prize联合创始人Mike Knoop也判断,越来越多的「学习」会发生在模型权重之外。
通往AGI的下一程,比的是谁能让模型看清世界、记住世界。
何恺明团队的下一站,是充满真实画面的具身环境,那里没有人会提前把世界翻译成一张数字表。
参考资料:
https://x.com/mark_k/status/2106377357078450620
 简体中文
 English