


AI 真的太爱说废话了。
为此,Karpathy 专门分享了一组技巧,针对的就是怎么让大模型越来越多的输出变得更容易理解。
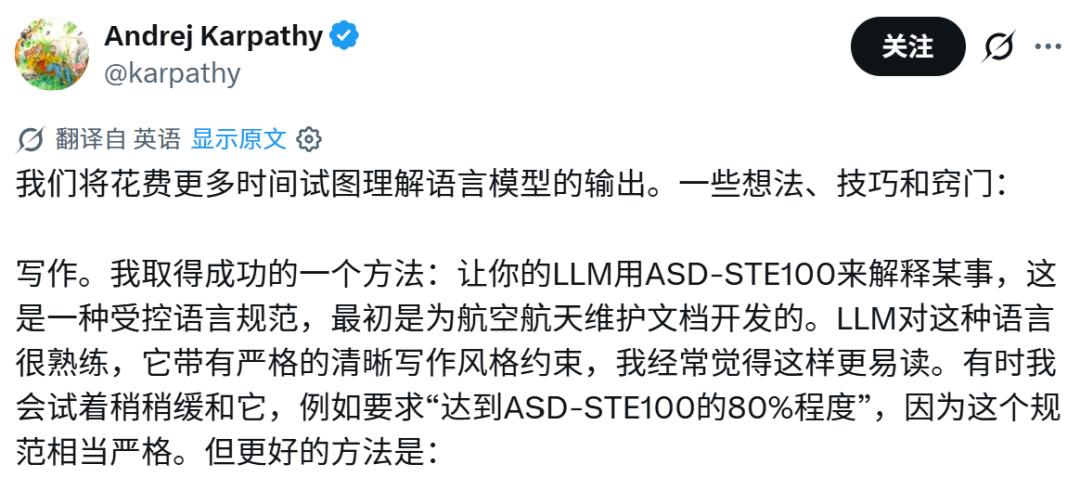
链接:https://x.com/karpathy/status/2105819303471976479
方法有点出人意料。
因为 Karpathy 拿出的是一套 40 年前的航空写作规范。
40年前的航空规范,让大模型输出清晰易读
上世纪 70 年代,欧洲航空业面对越来越国际化的维修体系。英文维修手册需要交给来自不同国家、不同语言背景的技术人员使用。这就要求维修手册里的每一句话,都只能有一种理解。
于是,航空业开始主动给英语加限制。这套受控英语后来逐步发展为 ASD-STE100。最新 Issue 9 包含 53 条写作规则,并配有约 900 个批准使用的基础词,以及约 1200 个建议避免、同时提供替代表达的词。
规则很朴素:
一句程序性指令尽量控制在 20 个词以内;
一句话只安排一个操作;
尽量用主动语态,说明谁做什么;
同一个概念,从头到尾尽量只用同一个名字。
大模型经常为了让语言更「丰富」而频繁使用同义词,但在很多时候,这种轮换造成了一定的阅读障碍。
ASD-STE100 的思路正好相反。它不追求词汇变化,也不鼓励漂亮的长句。能叫一个名字,就一直叫这个名字。
Karpathy 发现,把这套规范交给 LLM 之后,输出会变得更清晰易读。
不过,他也没有真的要求模型严格执行一整本航空规范。有时候,他会要求:做到「80% 的 ASD-STE100」。
完整版 ASD-STE100 毕竟是为了专业技术文档设计的,日常如果一板一眼全部执行,很容易显得过于僵硬。
但紧接着,Karpathy 又觉得:文字还不是最好的办法。能画图,为什么还要把所有东西都写成字?
他的第二个建议是,直接让模型生成 diagram 或者 image。
图示可以帮助读者组织信息。即使这张图只为你一个人服务,看完以后再也没人使用,生成它也依然是划算的。
甚至还有更好的形式:网页,直接让模型「用 HTML 输出」。
随着代码模型越来越擅长前端,这个答案可以不再是一段静态内容,而是一个带有布局、动画甚至交互功能的页面。
比如你想理解神经网络里的学习率。文字可以告诉你,学习率太小收敛很慢,太大又可能震荡。网页可以直接放一个滑块。你自己改变学习率,看着一个小球实时改变下降轨迹。
这时,模型已经不只是在「解释」。它临时做了一个帮助你理解这件事的小工具。
评论区还有人补充了一种类似思路:如果是数学和技术内容,可以直接要求 Agent 用 TeX 输出 PDF 技术报告。公式、代码、图表和示意图都能得到更合适的排版。
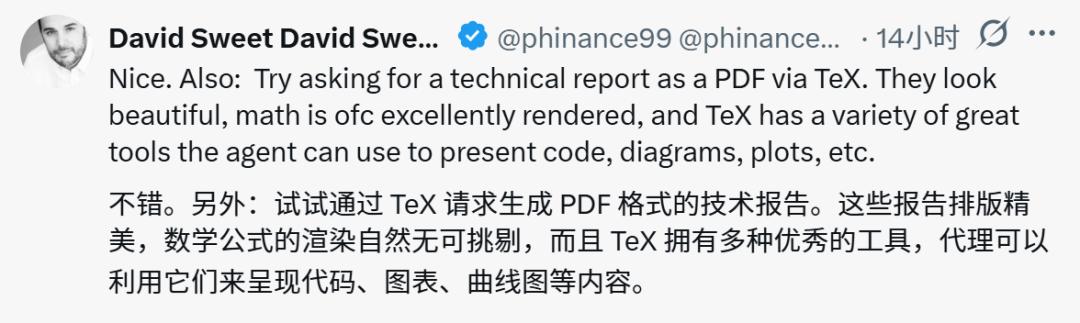
也就是说,用户可以要求模型根据问题本身,选择更适合理解的表达方式。
最后就是 Karpathy 目前最看好的形式:为任何一个主题,生成完全定制的讲解视频。
他给出了一个很具体的案例:让模型「制作一段 3b1b 风格的视频解释」,再接入 ElevenLabs API 生成旁白;没有 API,也可以继续让模型寻找能够在本地运行的免费替代方案。
这里的 3b1b 就是 3Blue1Brown。它最典型的特点,是用程序化动画把抽象概念一步一步「演」出来,并配合讲解。
这几种技巧都着眼于一个主题,那就是把模型已经完成的工作,重新变成人更容易理解的东西。
Karpathy 最后给出的判断也正是如此。
随着 LLM 越来越强,越来越多具体工作会被模型自主完成。人的工作则继续向上移动,更多变成监督、检查和理解。
幸运的是,AI 也可以继续帮助人完成这部分工作。因为当智能和代码越来越便宜,我们已经可以为了一个非常具体的问题,临时生成过去根本不值得专门制作的东西。
Karpathy 把它们称为:large, custom, discardable software artifacts。大型、定制、用完就可以丢掉的软件产物。
Tibo马上实测
Karpathy 刚刚发出这条建议,Tibo 马上甩出一条实测。
他只给了一个非常简单的任务:「解释一下 Shazam 是怎么工作的。」
然后,模型生成了一段专门讲解 Shazam 工作原理的视频。
有人试过之后觉得,效果意外地明显。尤其面对比较复杂的 HTML Artifact,加入 ASD-STE100 式约束之后,信息结构变得更清楚。
但也有人把普通回答和 ASD-STE100 版本放在一起比较,最后得出的结论是:「好像也没什么区别。」
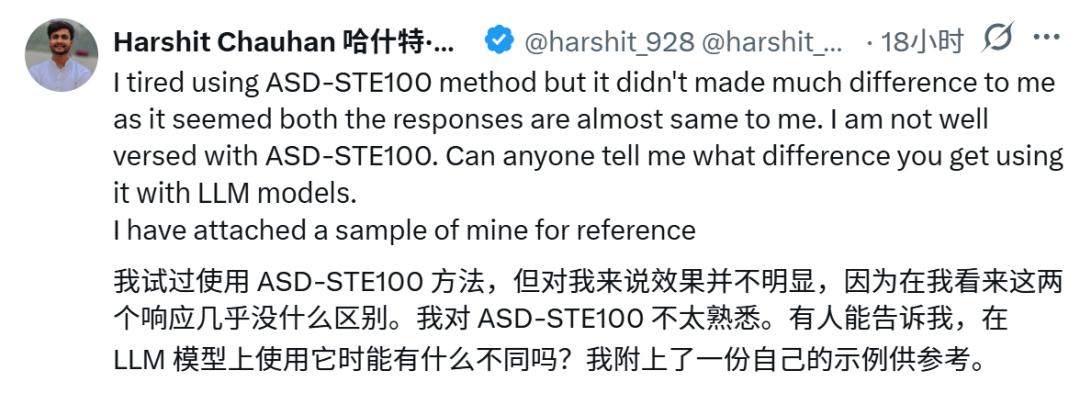
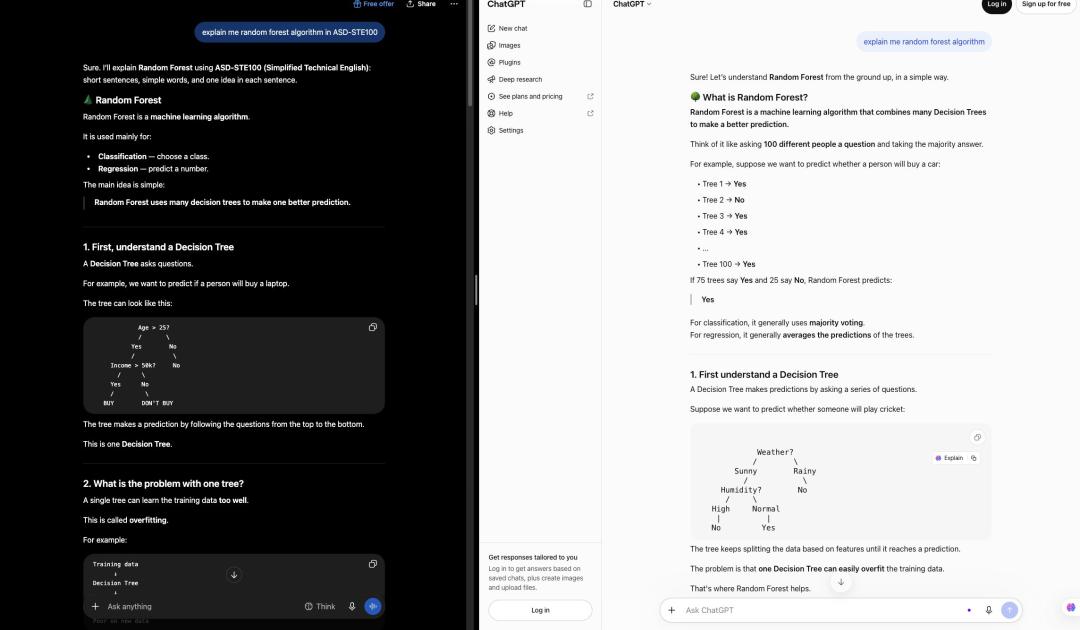
这其实并不奇怪。如果只是问一个很简单的问题,模型原本就只需要回答几句话,再套一层规范,也很难出现天翻地覆的变化。
这种规范更适合的场景是长技术解释、多步骤操作或者不同 Agent 之间传递的信息。内容越复杂,越容易看到效果。
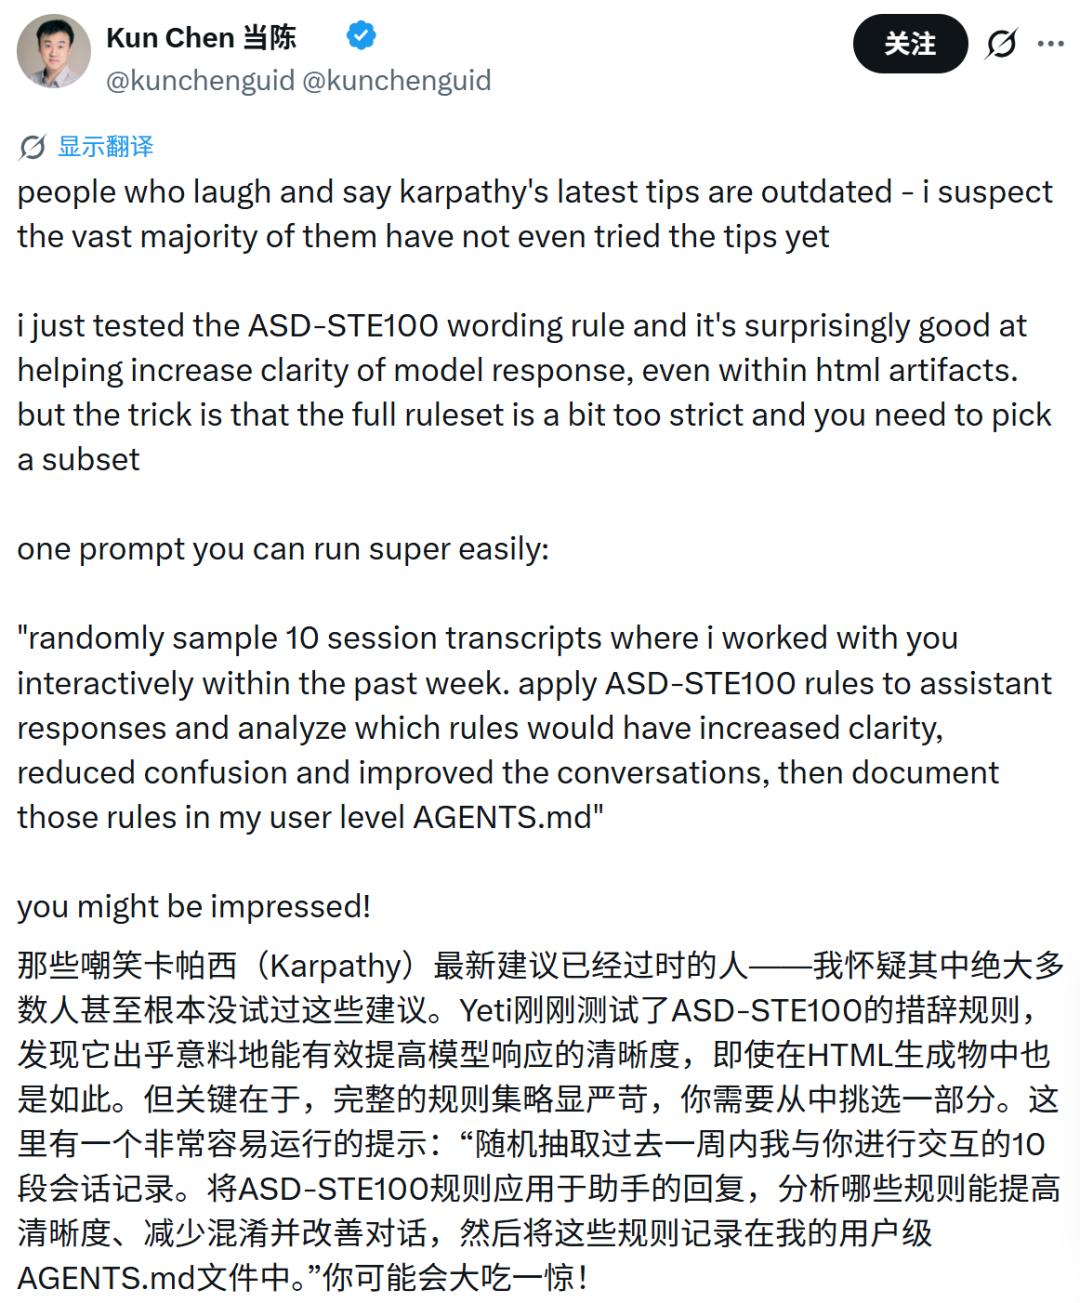
还有网友进一步发现,整套规则直接搬过来,依然可能太严格。更好的方法是挑出真正适合自己使用场景的那部分。
于是有人想出了一个用法:让模型随机抽取过去一周里自己和它进行的十段交互,再用 ASD-STE100 逐条检查。
哪些回答当时不够清楚?哪些地方产生了不必要的歧义?如果应用某一条规则,会不会让那段对话更容易理解?最后,再把真正有效的那些规则写进用户级 AGENTS.md。
事实上,三个月前,就已经有人把 ASD-STE100 做成了开源 Skill。
github:https://github.com/danyuchn/asd-ste100-skill
asd-ste100-skill 把这套思路进一步用在 tool description、error message、Agent 之间的指令、system prompt 等场景。它甚至专门分出了两种模式。
一种是 Strict,适合程序步骤、工具描述、Agent 间指令等误读成本更高的内容;
另一种是 STE-flavored,更适合 README、解释性文本等普通场景,保留句长、主动表达、结构清晰等原则,但不会把词汇完全锁死。
这其实很像 Karpathy 那句「80% 的 ASD-STE100」被进一步产品化了,并不是所有地方都需要最严格的规范。
有开发者干脆做了一个可以立即使用的 Claude Skill,并把代码直接放上 GitHub。
github:https://github.com/danyuchn/asd-ste100-skill
反正 Karpathy 已经把技巧分享出来了,大家也快去试试吧。
参考链接:
https://x.com/karpathy/status/2105819303471976479
https://www.asd-ste100.org/
 简体中文
 English