


一家成立约一年的公司,被放到了25亿美元估值的谈判桌上。
9月,外媒报道称,阿里拟领投AI训练与评测公司UniPat的一轮3亿美元融资,本轮估值约25 亿美元,腾讯、红杉中国等投资者也传出参与意愿。
这个数字,曾经属于前两轮AI创业热潮中的明星项目:
一个造大模型,一个则是过去几年最热的能力方向。而这一次,是一家为模型提供训练数据和评测服务的公司。
此前,UniPat创始人李宽在阿里通义AI实验室从事过后训练分析、数据合成和强化学习工作。
这个组合有意思的地方在于:从模型团队出来的人,开始为模型团队生产训练材料,大厂则出现在投资者名单里。
美国已经出现过一个“逆向”的标志性人物。2016年,Alexandr Wang与Lucy Guo共同创办Scale AI,从自动驾驶数据标注做起,逐步进入大模型训练数据和评测业务。2025年,Meta入股时,Scale的估值超过290亿美元,Wang也加入Meta。他已经展示过,数据供应商能够走到离模型核心多近的位置。
中国当然有数据公司,海天瑞声等企业早已提供采集、标注和大模型数据服务。如今出现的新变化是,直接参与过模型后训练、Agent产品和内部评测的人,开始出来做这门生意。
UniPat之外,前
他们共同看见的机会,是模型越接近真实工作,训练所需的数据就越难从现成的互联网内容里找到。
智能的生产制造,正在向数据公司延伸。大厂带着采购需求而来,投资人热切寻找标的,模型团队里的人则走出来创业。
基座模型内部的“考官”们,陆续创业了
从UniPat团队此前的研究里,可以看见这门生意的来处。
在成为创始人之前,李宽在通义AI实验室从事后训练、数据合成和强化学习工作,已经开始研究怎样给模型出难题。
2025年7月发表的WebSailor论文中,他是列名第一的作者,也是三位项目负责人之一。团队合成复杂搜索任务,让模型学习查找证据、调用工具、连续推理,探索怎样通过强化学习,提高Agent执行任务的能力。
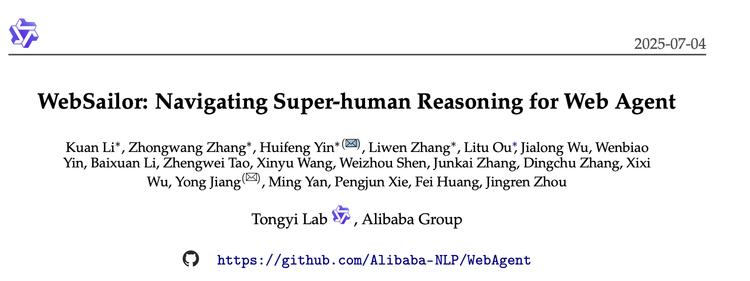
同为WebSailor项目负责人的尹汇锋,后来也成为了UniPat的成员。
联合创始人兼CTO陈亮则曾在Qwen、Moonshot多模态团队从事研究,其个人学术主页在2025年8月就记录了启动Agent数据与强化学习环境公司的消息。
这支团队熟悉的,是怎样围绕模型欠缺的能力设计任务,再用这些任务训练和检验模型。成立公司之后,这些研究经验通过一系列公开评测呈现出来。
今年1月,UniPat发布BabyVision,检验模型的基础视觉推理能力。5月,Terminal-X测试编程Agent解决复杂工程任务、应对多轮需求变化和完成版本升级的能力;ExpertEval评价医疗、金融和法律场景中的专业判断;SaaS-Bench则检验Agent能否跨越多个业务软件,完成一整套工作流程;7月发布的Vibe-Coding Arena进一步引入真人专家,在多轮编程协作中,评价Agent怎样理解需求、接受反馈和修正错误。
考题从“答得对不对”,走向“多元的真实工作任务”。
论文和 benchmark 在很长一段时间是外界认知 UniPat 的唯一路径。
这种低调也是这一波数据创业公司的共同倾向:愿意交流技术,却很少谈及具体业务。毕竟,研究成果可以公开,但为谁补什么能力、怎样生产数据、如何验收,已经涉及客户研发方向与自己的商业壁垒。
一位相关从业者告诉我们,尽管最近才被爆融资消息,但UniPat实际上已融多次,阿里作为此次披露的领投方,同时提供资金与算力支持,后者一年约为数千万元人民币级别。
另一位从业者介绍,UniPat和阿里的合作,以强化学习后训练数据为主,包括不同Agent运行框架下的编程轨迹和多工具任务,先在较小模型上做低成本训练实验,筛选出有效的数据方案,再扩大生产与交付,在大模型上训练验证。
这是一种深度合作定制:客户买的不只是材料,还包括寻找有效材料的实验过程。公开Benchmark只是切口,水面之下,UniPat试图成为模型方的外部数据研发来源。
不同于UniPat,同样面对模型厂的数据需求,智能知识把重心放在了专家知识怎样被组织起来、持续生产上。
创始人兼CEO汪涉洋此前负责字节Seed模型数据工程架构,也做过抖音医疗大模型数据工程;CTO李宽野是前字节跳动基座模型数据工程师,做过强化学习数据合成与环境搭建。
2025年5月,汪涉洋已公开提出,高质量专家数据越来越重要,但好用的生产工具仍集中在大厂内部。智能知识因此用“一面千识”寻找、筛选和组织专家,再用Xpert Studio支持任务生产与质检。今年6月,公司宣布获得锦秋基金、耀途资本投资。
从这两家公司的切入点,可以看到模型内部经验的不同去向:UniPat更靠近模型实验,而智能知识更靠近生产场景。
今年从
一位接近人士提到,创始人梁丽今年上半年离职创业,此前负责
两人的经验连接了产品与模型:一端要判断用户的工作有没有完成,另一端要把这种判断转成训练目标。据我们了解,Copula Lab也已获得投资。
模型背景、后训练场景、融资火爆,构成了当下新型数据公司的三个特点。
它也提供了一种新的行业分工可能:模型厂保留核心训练,把跨场景、需要持续更新的数据生产交给亲手“培养”起来的外部伙伴;创业者则将服务一家Lab的经验,转化为服务多家的产品。
模型开始“买能力”,数据生意变了
这一现象背后,有一个更大的背景,即模型公司购买数据的逻辑正在发生改变:过去主要采购训练材料,现在希望直接买到能力的提升。
一位负责模型评测、也参与后训练的研究员,给我们举了一个例子:如果一批数据不需要改模型架构,拿去做后训练,就能让编程榜单的成绩涨三个点,“你买不买?你肯定买。”
这三个点,既是向外界展示的成绩,也是内部自己衡量研发效果的依据。
举个例子,模型团队会建立一棵“能力树”,把模型需要发展的能力、要打的榜单列出来,再寻找对应的训练材料。公开数据覆盖不了的部分,就购买或自己生产:找出模型失败的任务,围绕欠缺的能力设计新的、更难的题目,再训练、再评测。
榜单因此同时成了成绩单、训练计划和采购指南。
这也是为什么,Benchmark会成为这一波数据公司的重要切口。一项评测揭示出共同短板,一个模型在某类任务上明显进步,都可能让其他团队开始寻找能够带来类似提升的数据。
但要接住这种需求,数据供应商需要做的事情,也变复杂了。
Agent要学的是怎样完成工作。互联网有大量代码,却不会自动附赠一次软件故障的完整处理过程:怎样定位问题、调用工具、修改失败、重新尝试,最后又凭什么确认修好了。
新的数据产品因此开始同时包含任务、操作轨迹、运行环境和评分标准。以智能知识公开的Terminal RL Data为例,它交付的就不仅是题目,还有软件环境、测试脚本与参考解法,让模型能够实际执行任务,并由测试验证结果。
海外公司的动作也已经显示出这种变化。
2026年2月,Scale AI称,接近一半的新数据训练项目涉及强化学习环境;7月,Mercor宣布将收购Deeptune,把自己的专家网络与后者重建企业软件、搭建训练环境的能力结合起来。
这种数据需求,解释了两件事:为什么这一波创业者集中来自模型公司,以及为什么模型厂商会需要一个外部数据供给层。
“UniPat们”的优势不只是认识采购方,而是自己做过需求方:知道模型的短板怎样被发现,一项任务怎样转成训练材料,以及怎样设计实验判断效果。
与此同时,进入的行业越多,各家重复组织专家、搭建系统的成本就越高。相比于模型内部,外部公司则有机会复用工具、专家网络和环境,把一次项目积累的能力带到下一次交付中,并多次售卖分摊。
眼下,各个大厂对后训练数据的需求增长速度,远快于优质供给的生产速度。
多位从业者用“暴利”形容这门生意:预训练语料虽然量大,后训练中能够直接补上模型短板的数据却更加稀缺。在他们的经验中,针对某项能力,一万到十万条高质量数据就可能给后训练带来明显改善。
这也让数据公司的产品定价、公司估值,越来越靠近研发价值。
Alexandr Wang带来的启示,也来自于此。Scale AI已经说明了,组织数据生产本身,可以成为模型公司之外的一项重要能力;而当它足够深入研发,双方的关系也会从采购,走向长期合作与资本绑定。
中国这批创业者走的是另一条起点不同的路。他们先在模型内部学会了怎样发现短板、设计任务、验证效果,再把这些经验变成外部服务。
模型研发越来越需要专业分工,而一家公司即使不拥有基座模型,也有机会成为“让模型变强”这件事的重要参与者。
 简体中文
 English