


GPT-6 Astra 发布还不到一个月,OpenAI 又把 GPT-6 家族往外扩了一圈。
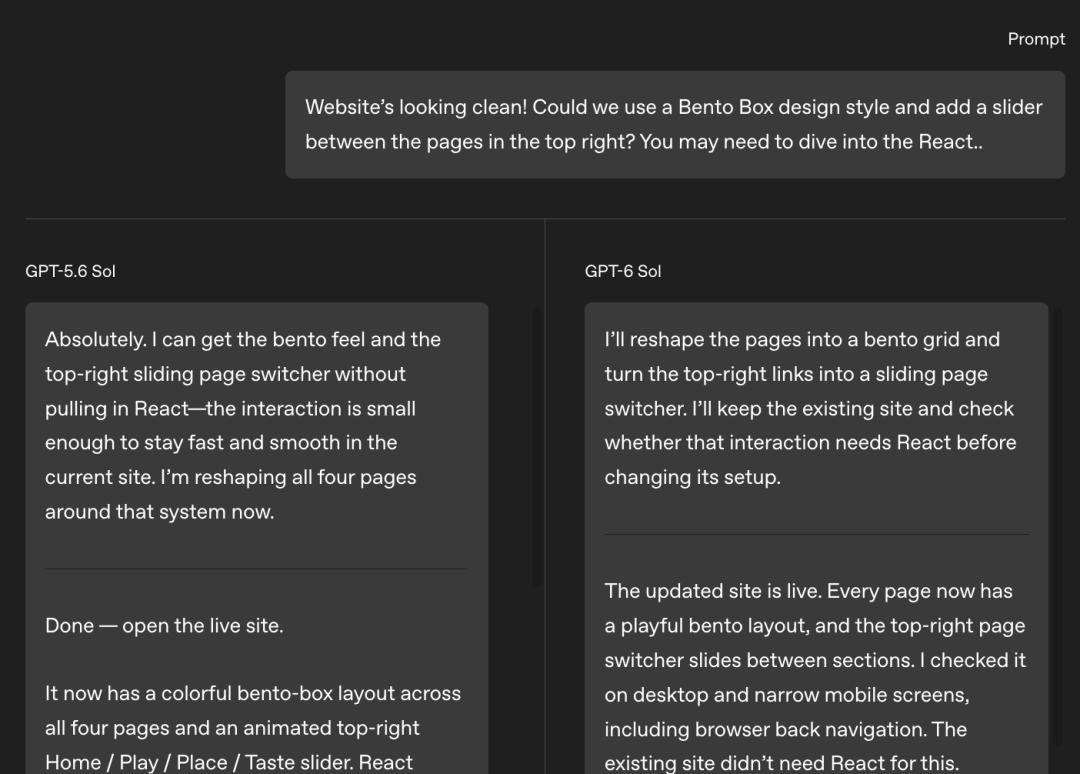
几个小时前,OpenAI 正式发布 GPT-6 Sol 和 GPT-6 Luna 两款新模型。这一次,OpenAI 试图把 GPT-6 Astra 带来的能力,以更低的价格推向更大规模的日常工作。
OpenAI 称,GPT-6 Sol 和 Luna 采用了与 GPT-6 Astra 相似的训练方法,同时通过缓存和推理效率优化降低运行成本。API 价格相比 GPT-5.6 的促销价格直接下降 50%:GPT-6 Sol 每百万输入 Token 从 4 美元降至 2 美元,输出从 20 美元降至 10 美元;GPT-6 Luna 则从每百万输入 Token 收费 0.20 美元、输出 Token 每百万收费 1.20 美元,降至 0.10 美元和 0.50 美元。
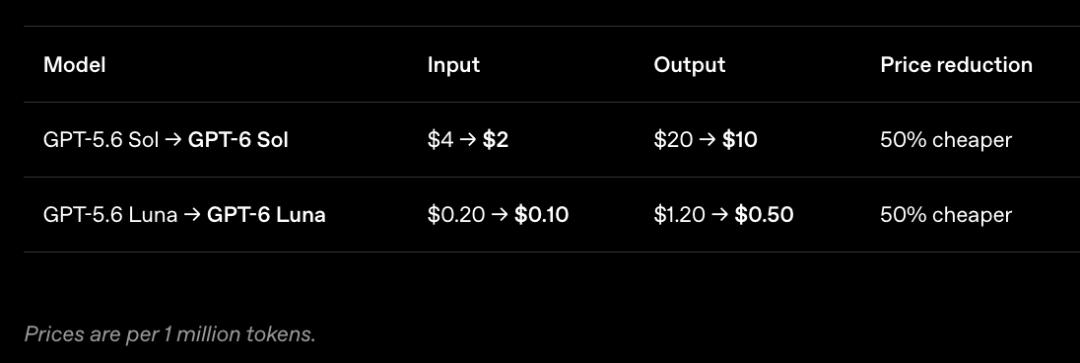
这也是这次发布最值得关注的地方:OpenAI 正在把“模型有多强”的竞争,进一步转向“完成一项真实任务到底要花多少钱”。
Sol 和 Luna 到底升级了什么?
从产品定位来看,Sol 和 Luna 其实并不是两个全新的能力方向,而是在现有模型能力的基础上进一步提升了智能水平。
具体来看,在专业工作场景维度,GPT-6 Sol 能够处理更复杂的工作任务。与价格相近的竞品模型相比,GPT-6 Sol 能够提供更强的智能水平和更好的结果。
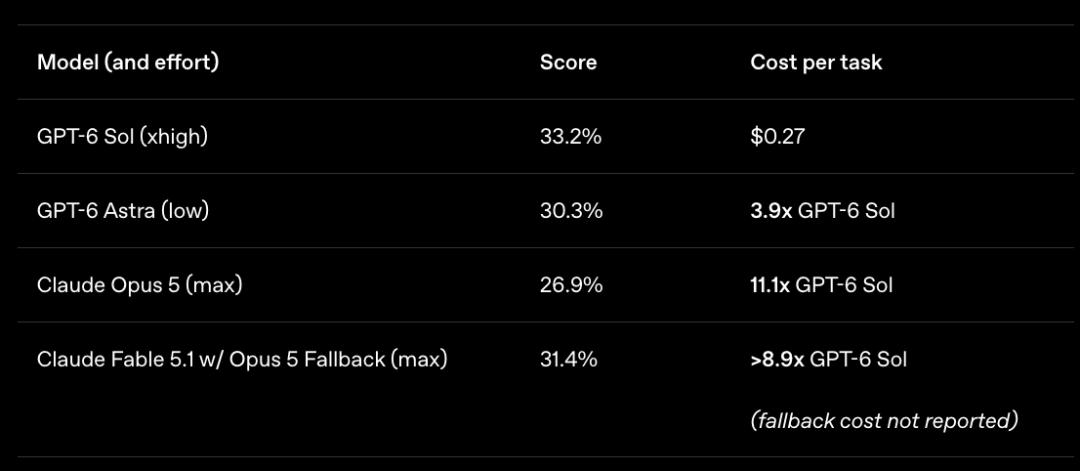
据官方公布的基准测试来看,在 AutomationBench 测试(评估 AI Agent 跨不同应用完成业务工作流的能力)中,GPT-6 Sol 在 xhigh 推理级别下的表现超过了最高推理级别的 Claude Opus 5,但单项任务成本仅为后者的 9%。
在 high 推理级别下,GPT-6 Luna 相比上一代模型提升 5.4%,同时单项任务成本降低 58%。
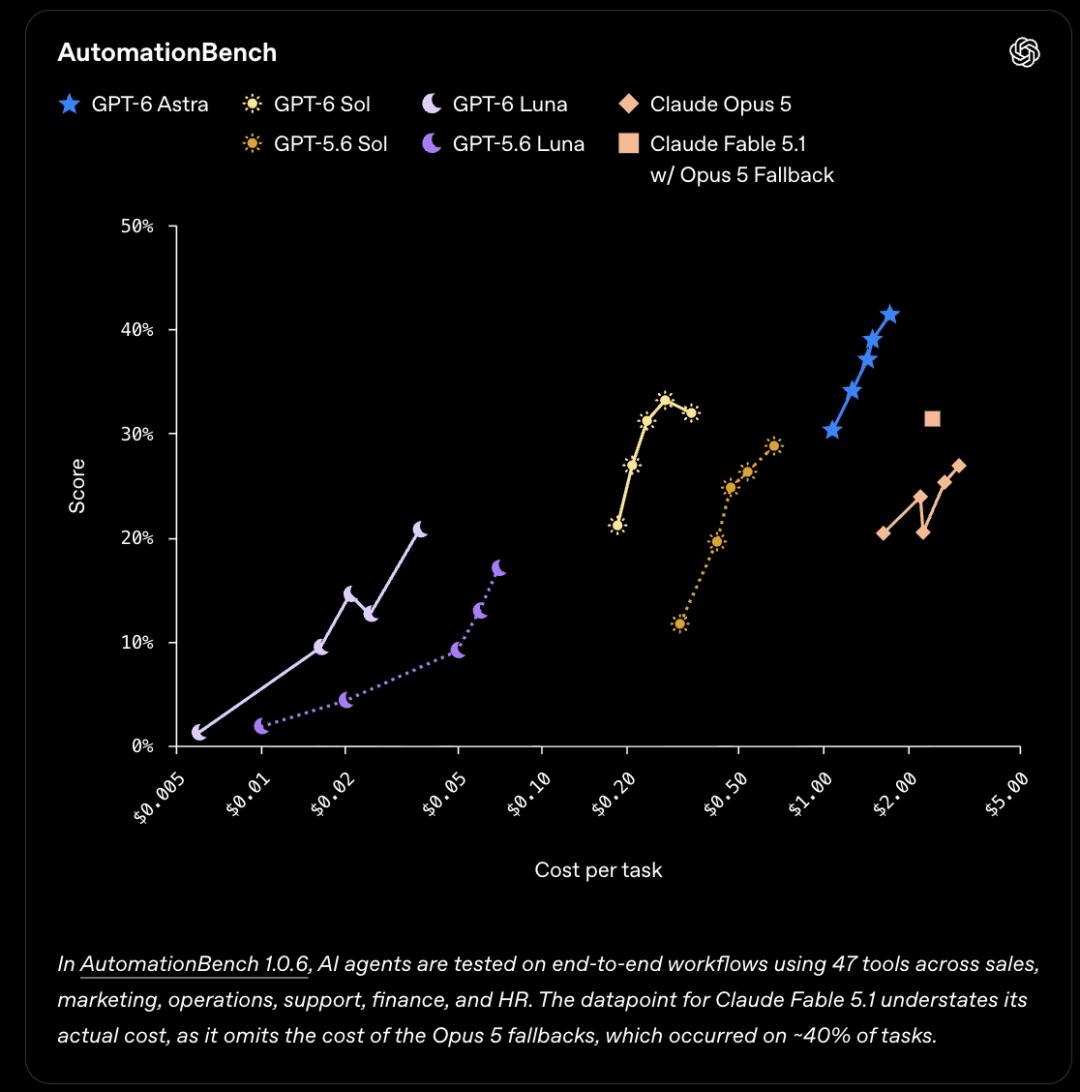
GPT-6 Sol 的表现也超过了 Claude Fable 5.1,同时成本明显更低,甚至超过了低推理级别的 GPT-6 Astra。
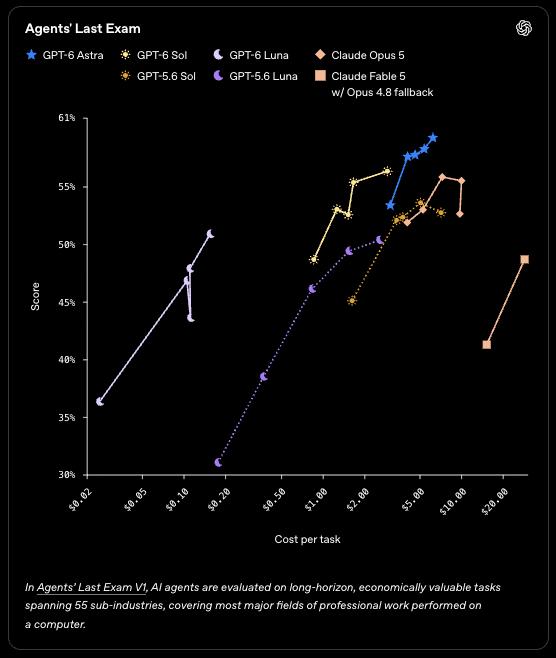
在 Agents’ Last Exam 测试(评估 AI Agent 完成复杂专业工作流的能力)中,GPT-6 Sol 在最高推理级别下取得 56.4% 的成绩,相比 Claude Opus 5 在该测试中的最高成绩,单项任务成本低 60%。
事实准确性
答案是否有用,很大程度上取决于其中的信息是否准确。OpenAI 表示,公司仍在持续提升模型的事实可靠性。
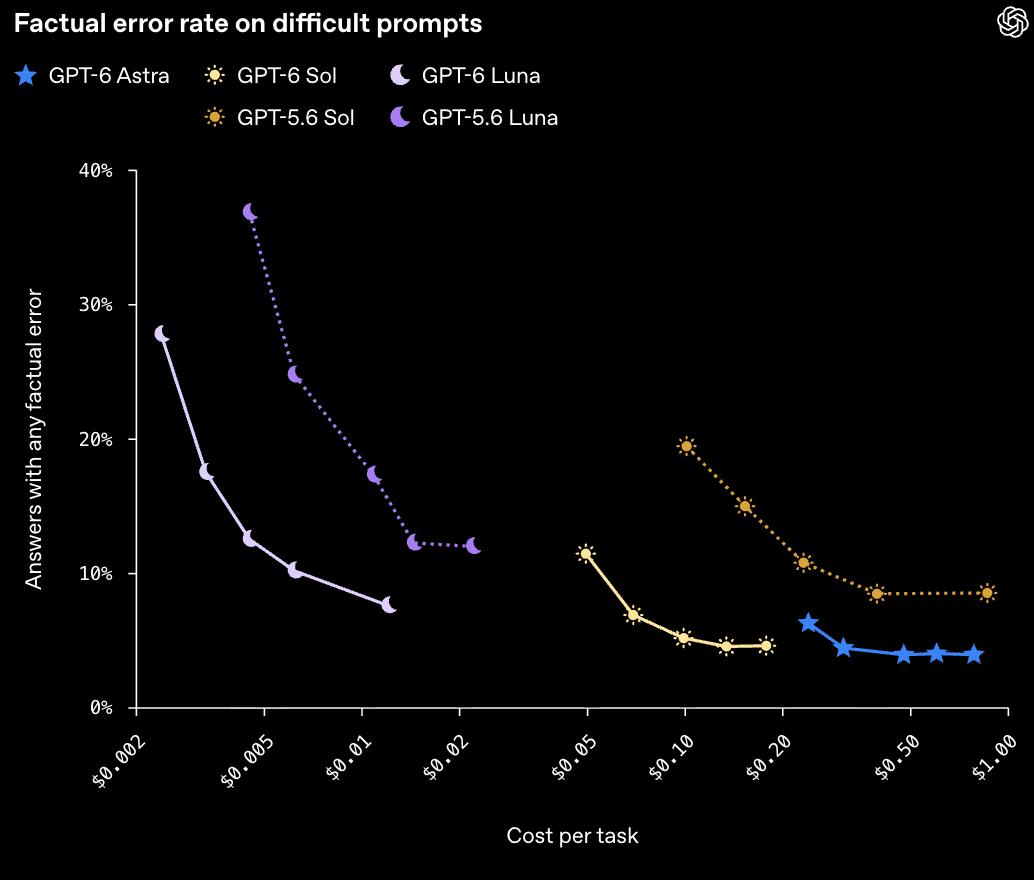
在一项内部事实准确性测试中,OpenAI 使用了经过匿名化处理的真实用户对话,这些对话此前曾被用户指出存在模型事实错误。
测试结果显示,GPT-6 Sol 出现错误的次数约为上一代模型的一半,同时以明显更低的成本接近GPT-6 Astra 的可靠性水平。
GPT-6 Luna 同样取得了明显提升。在更高推理级别下,其表现可以达到 GPT-5.6 Sol 的水平,但单项任务成本约只有后者的百分之一。
编程
今年,编程 Agent 开始处理比以往更加复杂、范围更广、持续时间更长的任务。OpenAI 表示,公司内部对编程 Agent 的使用量也在快速增长。
按照 API 价格计算,目前一名普通研究人员每天使用的 Token 对应价值已经超过 600 美元,使用量排名前 10% 的研究人员每天使用量对应的价值则超过 7000 美元。
随着编程 Agent 承担越来越长、越来越复杂的任务,持续使用的成本也变得更加重要。GPT-6 Sol 和 Luna 希望在保持较强编程能力的同时,通过更低的 API 价格,让开发者拥有更多迭代空间,也让团队更有底气把更复杂的任务交给 Codex。
正因此,代码能力也是这次更新的重点。
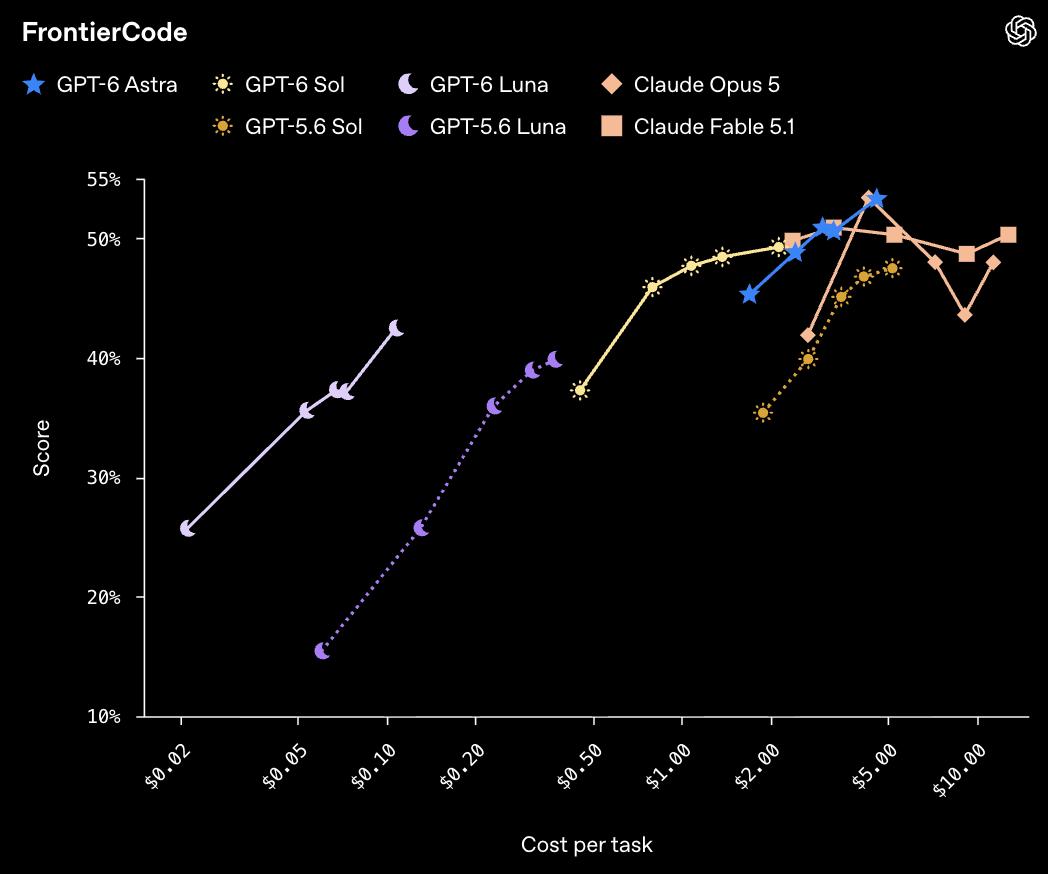
OpenAI 使用 FrontierCode 1.1 Main 测试模型是否能够真正产出可以合并进真实代码库的修改,而不只是回答一道编程题。
测试结果显示,GPT-6 Sol 相比 GPT-5.6 Sol 有明显提升,同时以更低的成本达到与 Claude Fable 5.1 在 xhigh 推理级别下相当的表现。
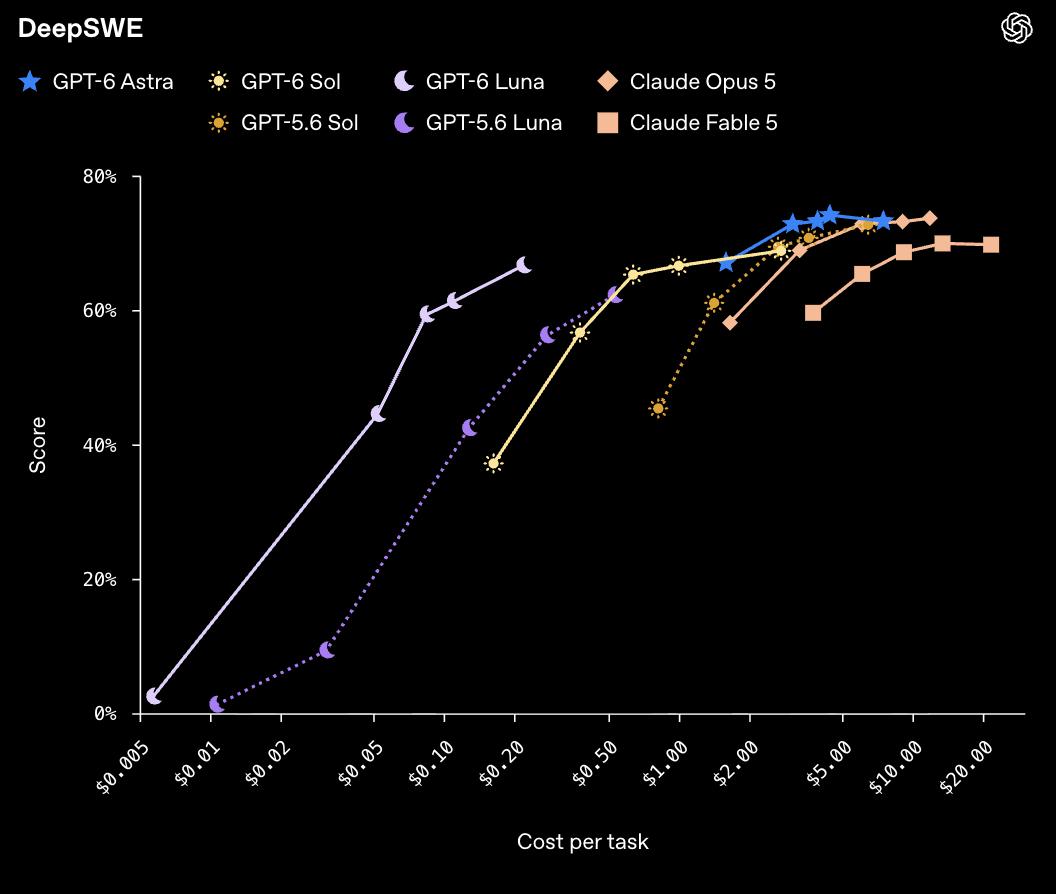
在 DeepSWE v1.1 测试中,GPT-6 Sol 在最高推理级别下取得 68.8% 的成绩,与 Claude Fable 5 在该测试中的最高成绩 69.9% 相差 1.1%,但单项任务成本低约 80%。
GPT-6 Luna 在最高推理级别下取得 66.6% 的成绩,与 Claude Opus 5 和 Fable 5 在中等推理级别下的表现相当。在这些对比中,Luna 的单项任务成本比 Opus 5 低 93%,比 Fable 5 低 96%。
电脑操作
OpenAI 表示,GPT-6 Astra 依然是目前电脑操作能力最强的模型,但 GPT-6 Sol 和 Luna 相比上一代模型,在成本效率方面有明显提升。
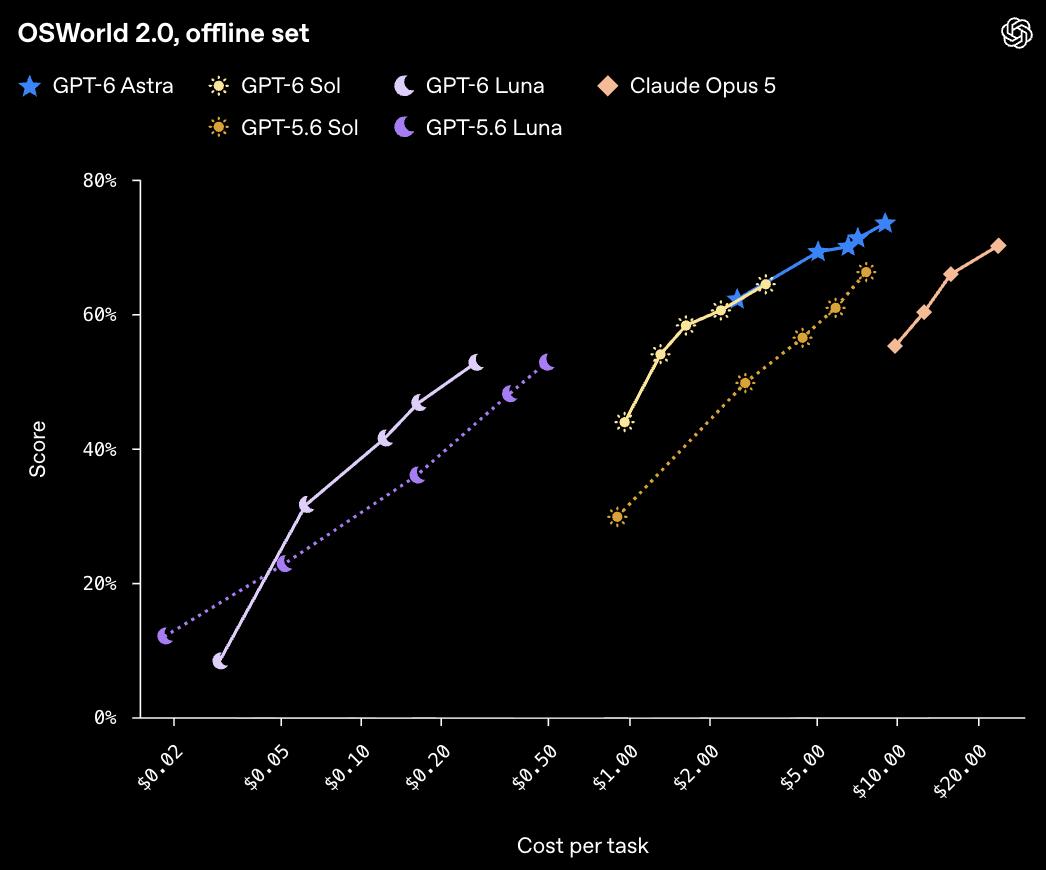
在 OSWorld 2.0 离线测试集中,GPT-6 Sol 在 xhigh 推理档位下达到 60.5%。
这个成绩与 Claude Opus 5 中等推理档位的 60.3% 接近,但 OpenAI 称 Sol 完成单项任务的成本大约低 80%。
Luna 则更加激进。OpenAI 表示,GPT-6 Luna 在最高推理级别下的表现则超过 GPT-5.6 Sol 的中等推理级别,而成本只有后者的十分之一。
这一次更新中还有值得关注的另一个变化是输出风格。
OpenAI 表示,Sol 和 Luna 也继承了 GPT-6 Astra 新的沟通方式,包括表达更清晰、减少术语堆砌、减少奇怪措辞和低价值细节,同时整体回答会略微缩短,但不会刻意牺牲信息量。
对于开发者而言,这个变化可能没有“benchmark 提升”那么容易被注意到,但实际上很重要。因为当模型开始承担代码修改、浏览器操作和长流程 Agent 任务后,一个模型是不是容易控制、是不是会不断输出无关内容,同样会影响实际任务成本。
成本问题
如果说 Benchmark 解释了 GPT-6 Sol 和 Luna “为什么值得关注”,那么价格才是这次发布真正改变开发者计算方式的因素。
API 文档也显示,GPT-6 Sol 和 Luna 目前支持文本和图片输入,并可通过 Responses API 和 Chat Completions API 使用;标准价格适用于最高 272K 输入 Token 的请求。
对于开发者来说,真正值得关注的不是一次请求便宜了几分钱,而是当一次任务的成本下降到原来的几分之一后,开发者可以更大胆地让 Agent 多尝试、多验证、多迭代。
这也是 OpenAI 所说“让用户大量使用 AI”的真正含义。
Benchmark 正在变得越来越难解释
这次发布还有一个值得注意的背景。
GPT-6 Sol 和 Claude Opus 5.5 几乎在同一天发布,双方都把“能力+成本”作为重点。
Anthropic 公布的数据显示,Opus 5.5 在 Terminal-Bench 4.0、FrontierCode 和 CursorBench 等测试上继续保持很强表现;Anthropic 同时强调,与上一代相比,Opus 5.5 在典型任务上的运行成本下降约 40%。
这意味着两家公司实际上正在走向同一个方向:模型能力还在继续提升,但“完成一项真实任务要花多少钱”正在变得越来越重要。
这也意味着,传统的“谁的 Benchmark 最高”,可能越来越难直接对应真实使用体验。一个模型拿到 70 分,如果完成任务需要消耗 10 倍Token;另一个模型拿到 68 分,却只需要十分之一的成本,对开发者来说,两者可能已经是完全不同的产品。
从 OpenAI 自己公布的测试结果也能看出,模型能力并不是一张简单的成绩单。例如,GPT-6 Sol 和 Luna 在 HealthBench 的部分指标上并没有全面超过 GPT-5.6。OpenAI 对此的解释是,新模型的回答明显变短,而部分测试需要覆盖大量细节,因此回答变短反而会影响得分。
在这样的背景下,降本几乎贯穿了 OpenAI 这次发布的全部宣传重点。
对 OpenAI 来说,更低的推理成本意味着同样的基础设施可以支撑更多模型调用。在数据中心硬件和算力需求持续增长的情况下,单位算力能够产生更多实际的推理结果;对开发者来说,则意味着更低的使用门槛,也意味着可以让 Agent 多跑几轮、多做几次验证和迭代。
整体而言,OpenAI 这次强调的不只是“模型变得更强”,还有一个更现实的问题:同样的智能,能不能用更低的成本跑起来。
当 AI Agent 从偶尔调用变成持续运行,模型每一次调用的成本都会被放大。这个时候,Benchmark 上多出来的几个百分点固然重要,但模型能以什么成本把任务真正跑完,同样会决定它最终能被多大规模地使用。
参考:
https://www.zdnet.com/innovation/openai-gpt-6-sol-luna-release/
https://openai.com/index/introducing-gpt-6-sol-and-luna/
 简体中文
 English