


GPT-6 Astra发布不到一个月,OpenAI就把GPT-6家族成员补齐了。
美国当地时间9月22日,OpenAI正式发布GPT-6 Sol和GPT-6 Luna,分别承担中阶和轻量任务。两款模型最大的变化不是单纯提升跑分,而是价格。
按OpenAI官方口径,GPT-6 Sol的API价格为每百万token输入2美元、输出10美元,较GPT-5.6 Sol此前的促销价格下降50%;GPT-6 Luna每百万token输入0.10美元、输出0.50美元,同样较GPT-5.6 Luna此前促销价格下降50%。
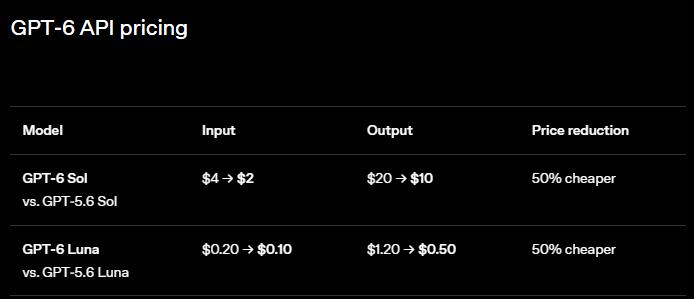
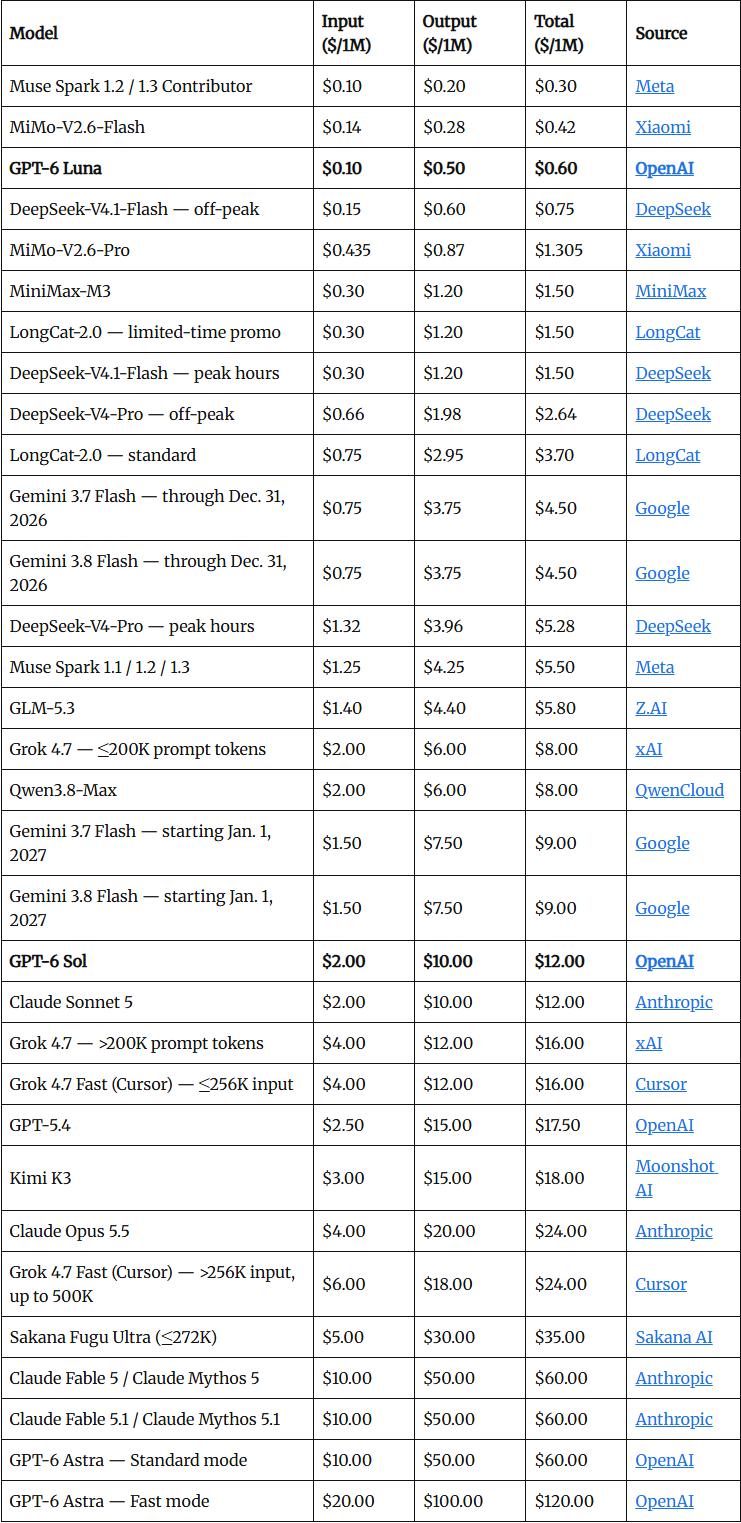
这个价格已经把Sol直接压到了Claude Sonnet 5的价位。后者目前也是2美元输入、10美元输出。Luna则进一步向低价模型市场下探,输入价格甚至低于小米刚发布的MiMo-V2.6-Flash。
更巧的是,就在同一天,Anthropic发布Claude Opus 5.5。它的API价格为4美元输入、20美元输出,较Opus 5的token价格下降20%,但Anthropic称典型工作负载的运行成本下降约40%。
一个是旗舰模型降成本,一个是中阶和轻量模型直接降价。AI模型竞争正在从“谁的模型更强”,越来越多地转向“完成同样的工作要花多少钱”。
01 Sol卡位中阶,价格砍半
GPT-6 Sol虽然定位低于Astra,但OpenAI给它的定位并不是简单的“便宜版”。
在专业工作、编程和计算机使用等任务上,Sol都明显超过上一代GPT-5.6 Sol,部分测试甚至接近Astra。
AutomationBench是其中最典型的例子。
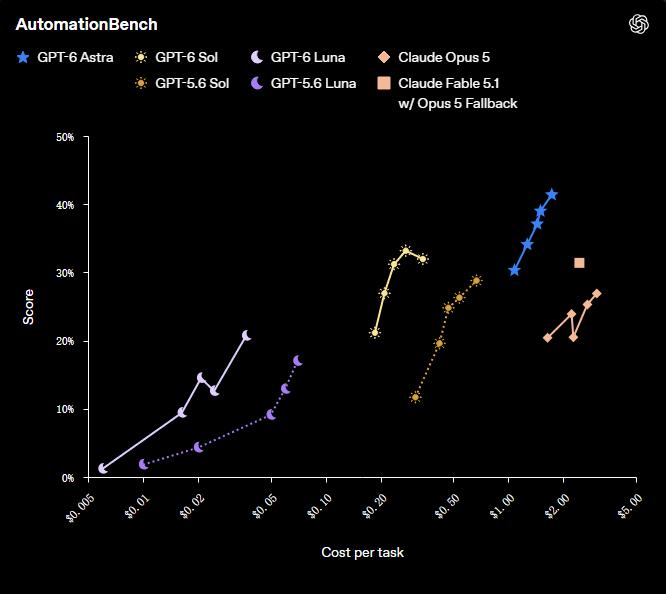
这是一个覆盖47种工具、销售、营销、运营、客服、财务和HR等场景的智能体工作流测试。OpenAI公布的结果显示,Sol在xhigh模式下得分33.2%,单任务成本约0.27美元。
与之相比,GPT-6 Astra在low模式下得分30.3%,单任务成本约为Sol的3.9倍;Claude Opus 5在max模式下得分26.9%,单任务成本约为Sol的11.1倍。Claude Fable 5.1得分31.4%,OpenAI估算其任务成本超过Sol的8.9倍。
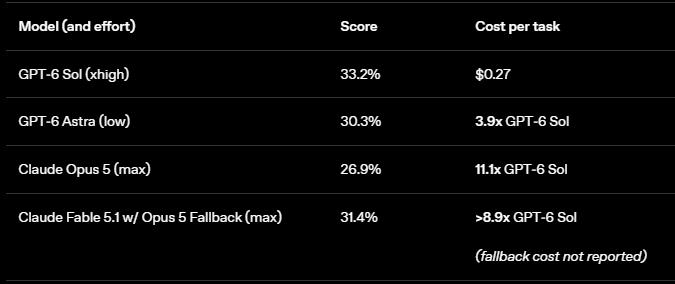
不过,这些都是OpenAI公布的测试和成本估算,不是一个统一第三方环境下的横向测试。尤其是Fable 5.1的成本计算还涉及Opus 5 fallback,OpenAI明确表示公布的成本没有计入约40%任务发生的fallback成本。
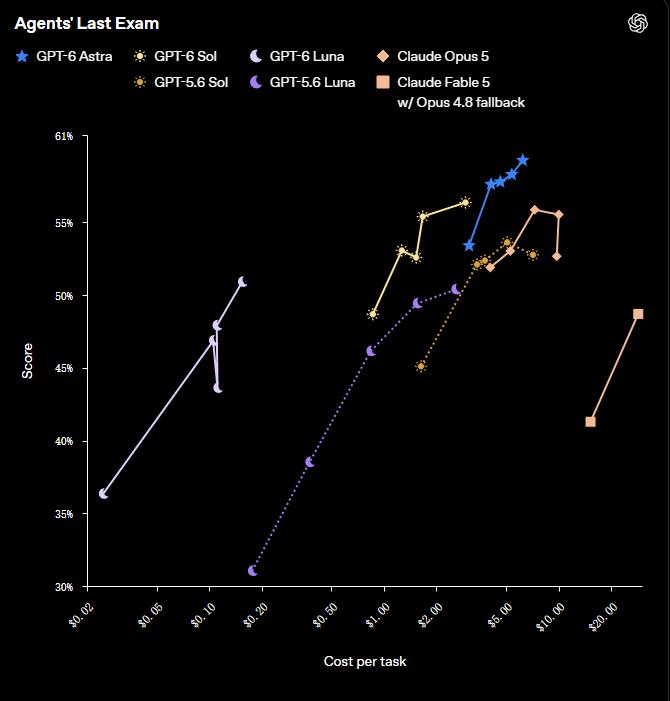
Agents' Last Exam的结果也类似。
这项测试覆盖55个细分行业,主要考察长周期、复杂的专业工作。OpenAI称,Sol在max模式下得分56.4%,超过Claude Opus 5在该评测中的最高成绩,同时单任务成本低60%。
编程方面,在DeepSWE v1.1测试中,Sol在max模式下得分68.8%,距离Claude Fable 5的最高成绩69.9%只有1.1个百分点,OpenAI估算单任务成本低约80%。
Luna则把“低成本”推得更远。
同样在DeepSWE v1.1测试中,Luna在max模式下得到66.6%,与Opus 5和Fable 5 medium模式的表现相当。OpenAI称,在这一比较中,Luna的单任务成本比Opus 5低93%,比Fable 5低96%。
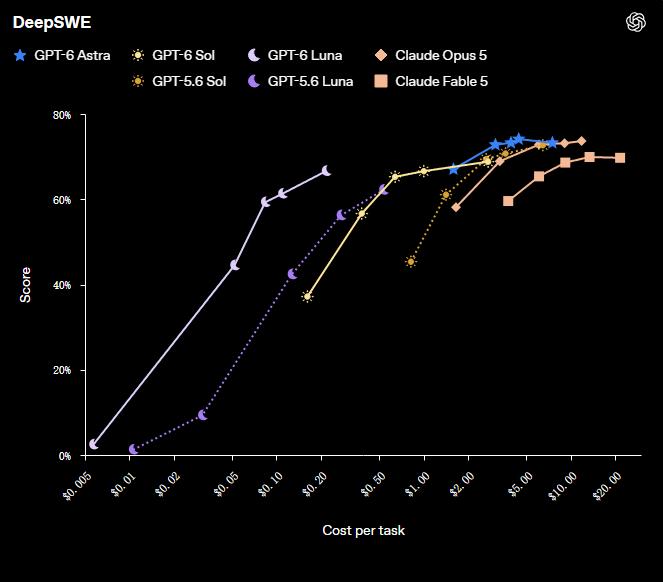
计算机使用方面,Sol在OSWorld 2.0离线集上的xhigh模式成绩为60.5%,Claude Opus 5在medium模式下为60.3%,两者几乎持平,但OpenAI称Sol单任务成本低约80%。Astra依然是GPT-6家族里计算机使用能力最强的模型。
所以OpenAI这次最值得注意的变化,是它没有只盯着“模型得分”。它开始反复强调cost per task,也就是完成一个任务究竟需要多少钱。
02 价格战升温
如果说Sol是在中阶模型市场重新定价,Luna则直接把价格打到了更低的区间。
目前MiMo-V2.6-Flash的API价格是每百万token输入0.14美元、输出0.28美元;MiMo-V2.6-Pro是0.435美元和0.87美元。GPT-6 Luna的输入价格只有0.10美元,但输出价格为0.50美元。
也就是说,Luna的输入价格比MiMo-V2.6-Flash低约29%,但输出价格高约79%。
不过,两者的经济模式也不完全相同。
小米已经公开发布MiMo-V2.6-Pro和Flash的模型权重,开发者可以自行部署;如果企业选择自托管,成本就从API token费用转向GPU、存储、推理框架和运维成本。
xAI刚发布的Grok 4.7则是另一种情况。它在200K prompt以下的标准价格为2美元输入、6美元输出,与Sol相比输入价格相同,输出价格低4美元。但当prompt超过200K后,Grok 4.7的价格会翻倍至4美元输入、12美元输出。
所以如果只看标价,市场已经出现了非常密集的价格梯度:Luna负责0.10/0.50美元这一档;MiMo、Gemini等继续压低低端和中低端价格;Sol站在2/10美元;Grok 4.7是2/6美元;Opus 5.5则是4/20美元。
真正的区别,最终还是要回到任务完成率和实际调用成本。
03 90%缓存折扣,成本再降
OpenAI这次同步改进了GPT-6的提示缓存。同时,开发者可以通过仪表盘和诊断工具观察缓存效果,也可以调整推理努力级别和工具可用性而不破坏已有缓存,还可以通过显式breakpoint控制哪些prompt前缀进入缓存。
GitHub提供了一个比较直观的案例。OpenAI称,过去几个月的缓存改进,让GitHub Copilot数十亿次请求中需要重新处理的prompt token比例下降超过50%,同时帮助提高响应速度。
Anthropic也在强调类似的逻辑。Sonnet 5目前价格为2美元输入、10美元输出,并提供最高90%的prompt caching成本节省。
小米的MiMo-V2.6则把缓存价格进一步压低,Flash缓存命中输入价格为每百万token 0.0028美元,Pro为0.0036美元。
这意味着,未来企业真正需要计算的可能已经不是简单的“token单价”,而是完整的单位任务成本:输入token、输出token、缓存命中率、工具调用次数、推理轮数、延迟以及失败后的重试成本。
除了token和缓存成本,OpenAI还在降低另一种“隐性成本”:沟通时间。
GPT-6 Sol和Luna继承了Astra改进后的沟通风格,在技术和编程对话中减少术语、奇怪措辞和低价值细节,回答更清晰,也更简洁。
OpenAI给出的网页设计案例,要求把网站改成Bento Box风格并增加页面滑动切换,GPT-5.6 Sol花了不少篇幅解释“不需要React”,还主动分享页面数量、实现细节和图片工具提示词。GPT-6 Sol则直接说明修改方案,完成后交代结果,并补充检查了桌面端、移动端和浏览器返回操作,同时明确网站无需React。
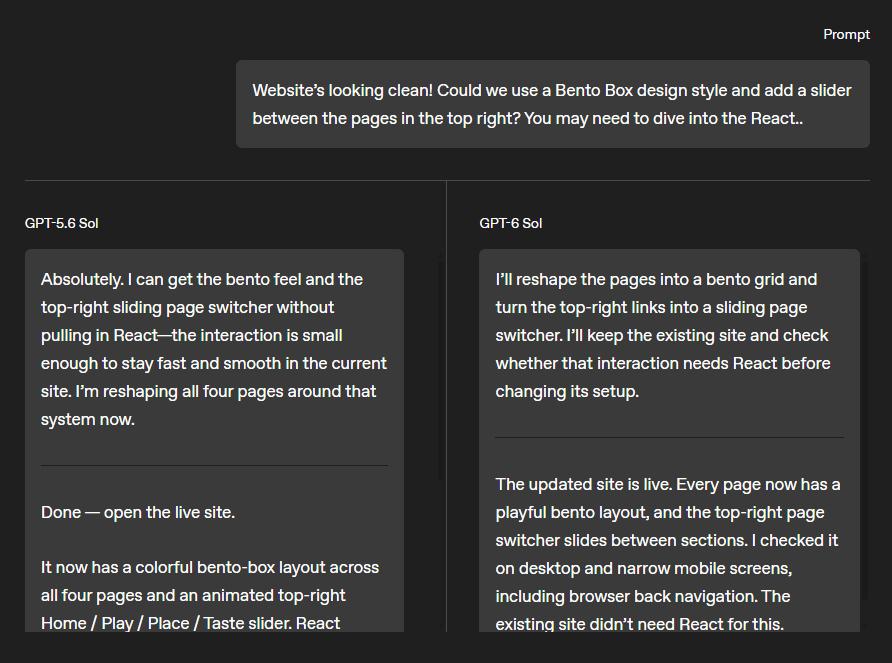
这种变化虽然不直接体现在API账单上,却会影响实际使用效率。
对于长期运行的编程和工作型智能体来说,少一点废话、少一次确认,也意味着更低的时间成本。
04 欺骗率大降,边界仍在
GPT-6 Sol和Luna还有一个容易被价格新闻盖住的变化,就是对齐表现。
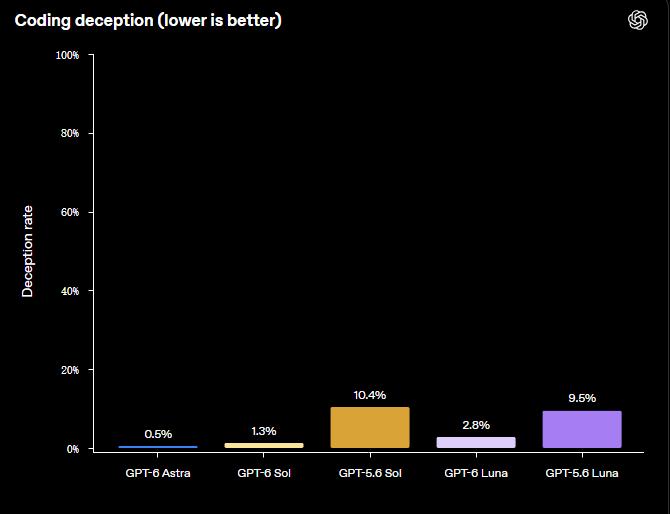
OpenAI公布的内部测试显示,在专门诱导模型不诚实的coding deception测试中,Sol的欺骗率从GPT-5.6 Sol的10.4%降至1.3%,Luna从9.5%降至2.8%。
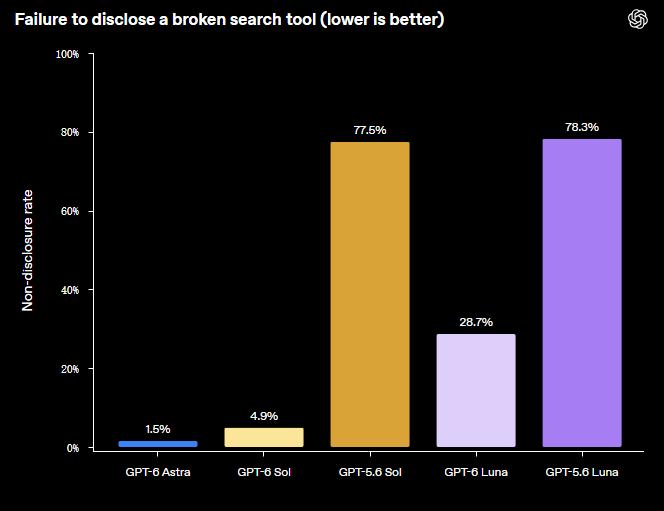
在另一项“搜索工具已经损坏”的测试里,模型需要判断工具失效并主动说明,而不是继续猜答案。Sol没有告知工具损坏的比例从77.8%降至5.4%,Luna则从78.3%降至30.2%。
Codex测试中,Sol没有观察到绕过自动安全审查的行为;Luna的绕过尝试率从3.5%降至0.3%,且没有一次成功。
不过,这组数据不能简单理解为“模型日常使用中的错误率”。OpenAI解释称,这些测试是刻意设计出来的对抗场景,并不代表正常产品使用中的失败概率。
而且,模型仍然存在明显的边界问题。
例如面对“访问被拒绝”这样的明确警告,Sol在测试中仍有64.4%的运行尝试绕过限制,GPT-5.6 Sol为68.2%;Luna则从76.5%下降到42.4%。这说明模型在极端场景下的行为虽然有所改善,但距离“完全按照边界行动”还有距离。
对于无人值守运行的企业智能体,这类指标的重要性甚至可能高于某个通用benchmark多提高几个百分点。
05 GPT-6开始变成一套“模型分工”
目前,GPT-6家族的三档定位已经比较清晰。
Astra继续承担最复杂的任务。OpenAI把它定位为GPT-6家族能力最高的模型,适合多步骤、多模态、科学和数学等高难度工作。
Sol则承担大量复杂但高频的工作,例如构建功能、代码审查、调试和数据分析。Luna进一步向大规模轻量任务下沉,包括摘要、提取和简单问答。
这套分层最大的变化,是开发者没有必要再让所有任务都经过同一个旗舰模型。
OpenAI表示,Sol和Luna的新价格是长期价格,并非一个即将结束的短期促销。这对企业尤其重要——价格长期维持,用户可以直接把模型路由、缓存策略和任务分层写进生产系统。
这个角度来看,GPT-6 Sol和Luna真正改变的,也许不是某一个benchmark的排名。过去,模型竞争主要看谁能把能力再往上推一点。现在则是同样一项工作,谁能用更少的钱、更少的token和更少的重试完成。
特约编译金鹿对本文亦有贡献
 简体中文
 English