


罗福莉从未遮掩对“天才少女”这四个字的嫌弃。
去年,她公开吐槽那些写自己的文章:事实错误一堆,如果自己是一个不认识罗福莉的人,看完也会默默给“买热搜”的评论点个赞。
一年多后,罗福莉又成了话题人物。这回模型还没练完,小米就把训练进度挂到了网上“直播”。外界围观了几天,终于在9月22日等来了MiMo-V2.6正式发布。
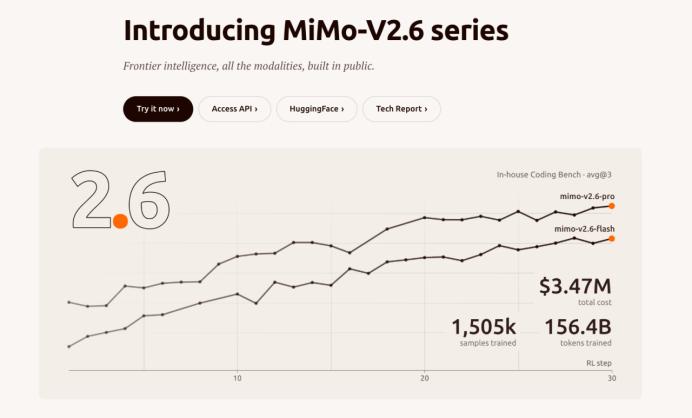
其中,Pro登上了Artificial Analysis综合智能指数的开放权重模型榜首。
小米还把技术报告、模型的RL版权重,以及约7000个训练任务环境和配套框架一并开放。同行看完热闹,可以直接拿回去研究。面向普通用户的桌面客户端,也随着新模型上线了。
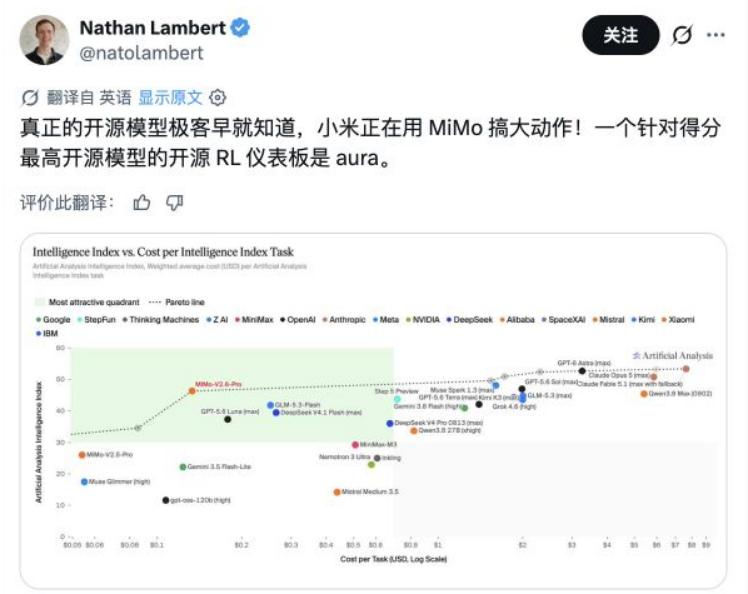
强化学习研究者Nathan Lambert直呼“有气势”。
做到这一步,当初那些围绕罗福莉的讨论,也该往前走走了。
从她去年11月公开宣布加入小米算起,到现在不过十个月。大公司重金请来的年轻AI负责人,这两年大家见了不少。能在这么短的时间里,让原本在头部竞争中存在感不强的公司拿到这样的成绩,还带出一条清楚的研究路线,放眼海内外,确实没几个人做到了。
小米如今对强化学习的投入、对Agent的押注,已经有了相当鲜明的辨识度。
1
围观了几天小米烧钱,这么快就可以验收成果了。
北京时间9月22日,小米正式发布MiMo-V2.6系列,之前在“直播间”里埋头训练的Pro和Flash,一起交了卷。两款都是原生全模态模型,文字、图片、音频、视频都能处理,模型权重也同步开放了。
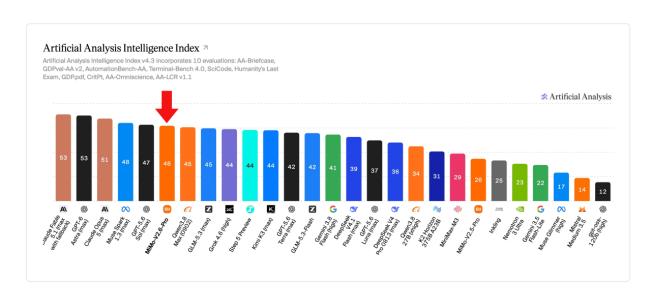
成绩确实拿得出手。
在第三方评测机构Artificial Analysis的综合智能指数中,MiMo-V2.6-Pro拿到46分,登上当时的开放权重模型榜首。作为参照,上一代V2.5-Pro的成绩是26分。从26到46,这次更新的动静,显然比版本号里那个小数点看着大多了。
这张成绩单之外,价格也很难让开发者忽略。
MiMo-V2.6沿用了上一代的API价格。按每百万Token计算,Pro的常规输入价格为3元,输出6元。更便宜的Flash,输入1元,输出2元。
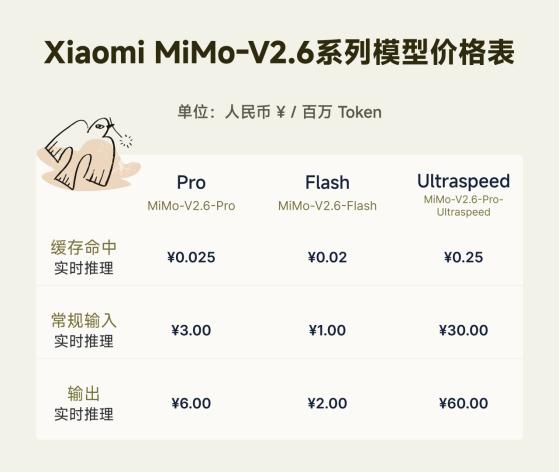
也就是说,能力往上涨了一截,收费还是原来的收费。
把罗福莉老东家的价格表拿来并排看看,就更有意思了。
截至发稿,
至少从价目表上看,开发者已经多了一个值得试试的选择。
老东家还出现在了罗福莉自己的发布感言里。
她在X上写道:“在我看来,它背后的研究创新和工程挑战超过了
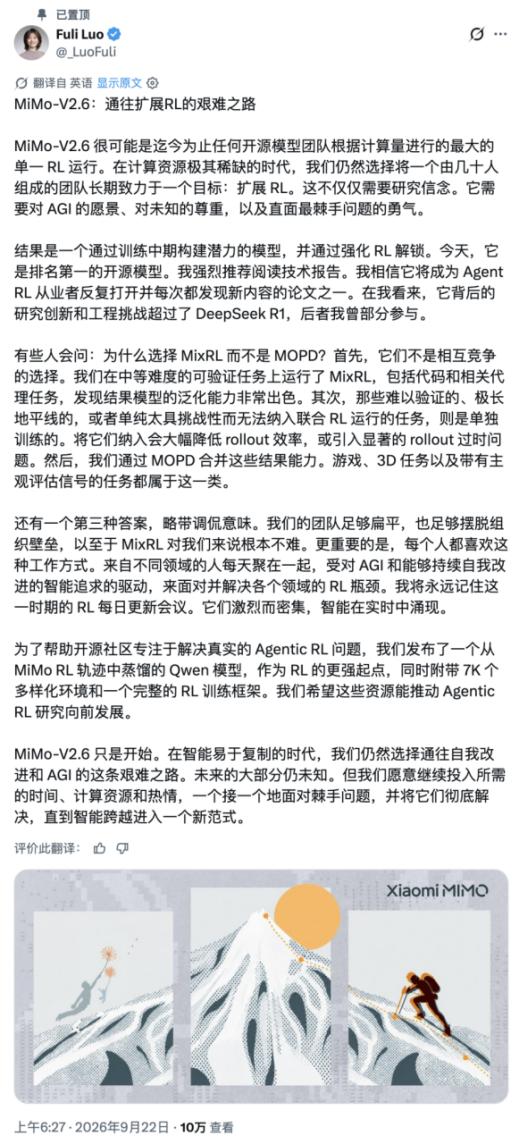
这话说得很有锐气。
这次交出来的东西,够同行研究一阵子了。模型上线只是其中一环。罗福莉和MiMo团队这次打的,是一套组合拳。
2
罗福莉给那条长帖起的标题,直译过来是《MiMo-V2.6:扩展RL的艰难之路》。
她说,按计算投入衡量,这很可能是迄今为止,开源模型团队进行过的最大规模单次RL训练。
同时,罗福莉专门“推销”了团队发在HuggingFace上的研究报告,预言“我相信它将成为智能体强化学习实践者不断重新审视并每次都有新发现的经典论文之一”。
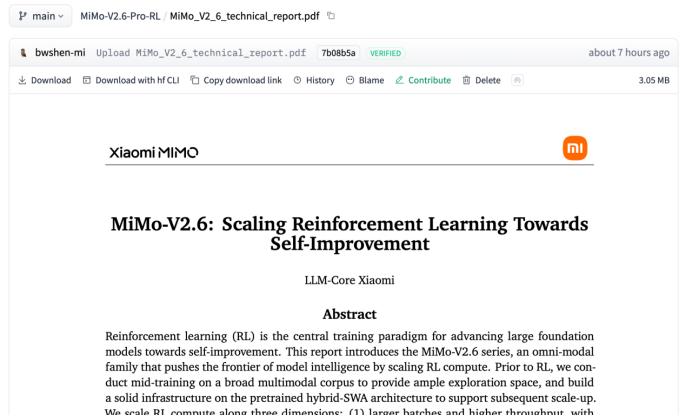
RL即强化学习。拿写代码来说,就是给模型一个任务,让它自己尝试,再根据结果打分,用反馈调整模型,让有效的做法更容易在下一次出现。
小米这次想摸清的是增加尝试、扩充任务,再花更多算力检查结果,最终能让模型再进步多少。按照技术报告,一次训练更新会安排1568条任务提示,每条尝试16次,合计约2.5万次完整尝试。一次尝试里,又可能包含很多轮查文件、改代码和检查结果。
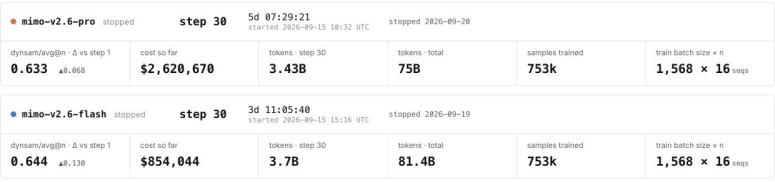
这些任务的耗时差别很大,有的很快就能做完,有的却要反复尝试很久,没法等所有任务都结束了再一起评分、训练。团队得把整个流程衔接好,尽量减少机器闲着等结果的时间,这本身就是一道工程难题。
直播页面上一个不起眼的“训练步骤”,里面其实忙得很。
而且,忙活半天,模型还可能把聪明才智用错地方。
报告写道,团队在早期实验中发现,MiMo会去找现成答案。让它修复某个软件历史版本的问题,它会下载更新的软件包,查上游补丁,寻找已经修好的代码。
这类训练要求模型根据指定版本完成修复,直接去网上翻答案说白了无异于某种“作弊”,是达不到测试MiMo解决问题能力的目的的。
于是,团队得清理可能泄露答案的文件和缓存,限制相关网络访问,还专门安排一个Agent去找剩下的漏洞。
即便代码通过了测试,也还要比较解决方案的质量。比如如果一种修法只改了必要的几行,另一种却加了一堆多余的东西,后面维护起来可能让人头大。团队为此让评分Agent检查多次尝试,区分方案的质量,把训练反馈做得更细。
哪些任务放在一起练,同样需要取舍。
罗福莉解释,游戏、3D等任务,有的执行过程太长,有的难以判断好坏,混进同一次训练,容易拖慢效率。团队会把这些任务单独训练,再通过“蒸馏”,让最终模型学习不同专项模型的长处。
小米在这次发布中也提到了RSI,也就是“递归自我改进”。这是当下AI行业最受关注的研究方向之一,Anthropic等公司都在探索其中的可能:让AI参与研发更强的模型,再由更强的模型接着推动下一轮研发。
罗福莉和团队也在往这条路上走。MiMo这次让模型参与出题和评分,就是在尝试把训练中的一部分工作交给AI,为进一步的自我改进打基础。
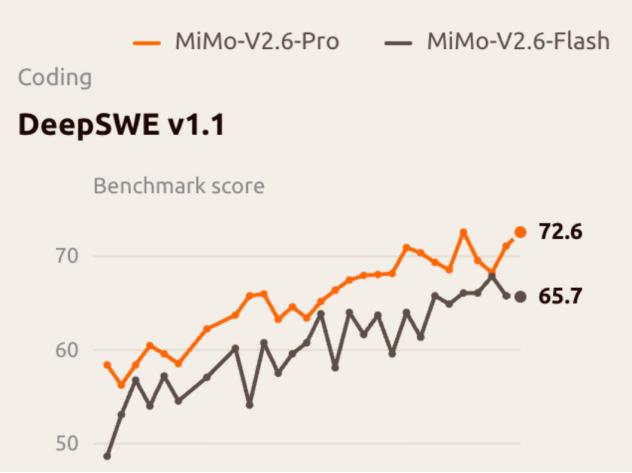
正如前文提到的,罗福莉的团队在正式发布新模型之前,就已经搞起了“直播”,外界可以清晰看到这轮历时不到6天的RL训练对模型能力有明显助益。在样本外的DeepSWE软件工程评测中,Pro从58.4升到72.6,Flash从约48.8升到65.7。小米同时强调,这6天背后,还有近半年的基础研究和工程试错。
更让同行兴奋的,是罗福莉与团队这次大方的“分享”。
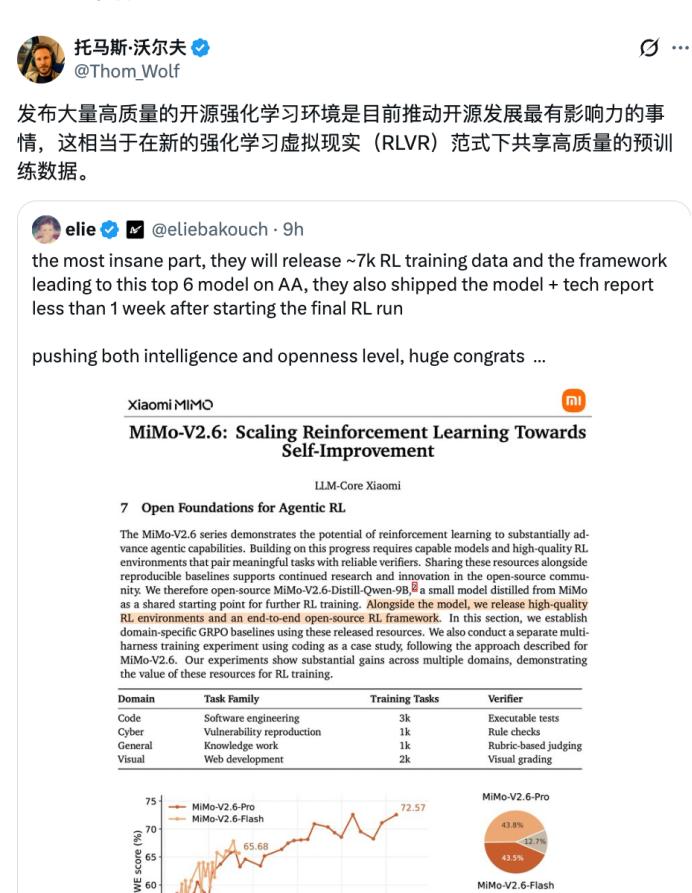
除了Pro和Flash的RL版本权重、技术报告,小米还宣布开放约7000个训练任务及配套环境、训练框架,以及一个学过MiMo解题经验的90亿参数模型,供研究者继续开展RL实验。
这里面既有练习题,也有能让模型动手的环境和检查结果的机制。
这有点像一家餐厅刚端出招牌菜,把菜谱和同款厨具也交给了同行。同行拿回去就能试,照着做也行,换换配料、改改做法,看看能不能做得更好吃也行。
也就不难理解,为什么曾在开源AI平台 Hugging Face 参与模型研发的研究员 Elie Bakouch,把这批训练资源的分享称为此次发布中“最疯狂的部分”。
对于同行来说,读完小米的技术报告,还能拿着它开放的模型、训练环境和框架,动手做自己的实验,省下不少从头摸索的功夫。
普通用户也有入口。此前开放邀测的MiMo桌面客户端,随着新模型发布接入Pro和Flash,让人可以拿自己的文档、表格和实际任务试试效果。
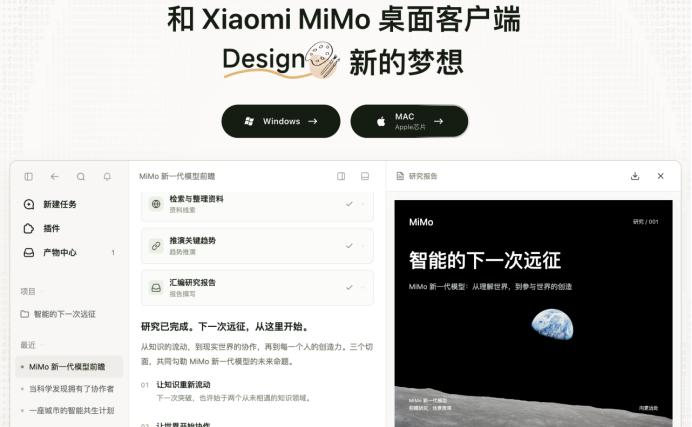
“直播”训练过程,“分享”研究资源,配合普通用户可以上手的产品。这套组合拳下来,罗福莉和小米这次总算不再受“善于玩弄营销手段”的质疑。
3
如果要给罗福莉加入小米之后的工作标出一个重要拐点,我会选这次。
2025年11月,罗福莉公开确认加入小米MiMo团队。此前,她在阿里达摩院、
这些故事太好传播了。一个年轻研究员,被大老板慧眼识珠,请去带队攻坚,三言两语勾勒热血漫,读起来也痛快。至于她到了新公司怎么做事,大家倒未必有同样的耐心。
今年3月,MiMo以Hunter Alpha的代号匿名上线,被不少人猜成尚未发布的
但在当时的开发者讨论里,仍然能看到“小米的营销一流的”这样的回复。
到了这次,小米给外界留下的判断材料充足多了。
这也是一种“发布的艺术”。一场发布的热闹,有机会延续成更长时间的使用和讨论。
罗福莉作为团队负责人的风格也逐渐清晰了。
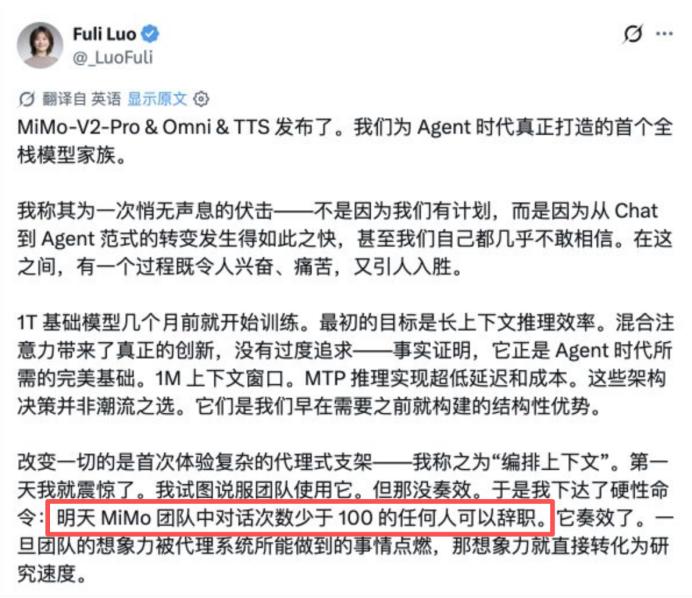
今年3月,她在X上讲过自己推动团队使用Agent的经历,其中一句“次日对话少于100次可以辞职”,很容易让人联想到熟悉的狼性管理。她后来在访谈里解释,自己并没有按次数考核,目的就是让大家真正用起来。为了推动这件事,她还提前买好设备、部署环境,让成员在群里一起尝试。
同一场访谈里,她谈到,MiMo团队不按预训练、后训练划成固定的小组,因为有人对两个方向都感兴趣,分得太死,会限制他们的成长。项目有实际推动的人,但这个人并不因此拥有对其他成员的绝对控制权。
她甚至提醒,负责人不要有太强的掌控感,觉得“没了我就不行”。
这次发布时,她又谈到了这套组织方式,而且把它和具体的技术选择联系了起来。
这次谈到把不同任务放在一起训练的MixRL,罗福莉讲完技术理由,还半开玩笑地提到了团队。她的意思是,模型要“混着练”,做不同研究的人也得能凑在一起干活,否则光是协调各个团队,就够费劲了。MiMo团队足够扁平,不同领域的人每天坐在一起讨论RL瓶颈,少了各管一摊的壁垒,合作做混合训练也就容易些。
带团队做出一个好模型,需要负责人在合作方式上花心思。罗福莉谈到的这些细节,让人看到了她在这方面的努力,而这次的成果,也说明她带团队有自己的本事。
把这份工作简单归结为“天才”,实在省略了太多东西。
做出成绩,是天赋过人。进展稍慢,又怀疑当初是不是吹过了头。在这种讲法里,研究仿佛总该随着某个人的到来立刻发生突破,其他人的工作也很容易被略过去。
当然,小米和罗福莉接下来还有不少硬仗。一次发布的掌声终有归寂时,模型能否持续进步,开发者试用后是否愿意留下,桌面端的演示能否变成每天都好用的工具,都要靠后续表现来回答。
但罗福莉已经交出了一份不赖的阶段性成果。
 简体中文
 English