


两百多年前,12 篇匿名政论的作者悬案,最后靠统计每个人用「小词」的习惯破了案。今天,越来越多的文字先过一遍大模型再发出去。改完的稿子更通顺了,可它们彼此之间,是不是也更像了?
1787 年到 1788 年,汉密尔顿、麦迪逊和杰伊用同一个笔名「普布利乌斯」,发表了 85 篇为美国宪法辩护的文章,后来结集成《联邦党人文集》。
麻烦留给了后世。其中 12 篇究竟出自汉密尔顿还是麦迪逊,长期没有定论,一悬就是一百多年。
1964 年,统计学家莫斯特勒(Frederick Mosteller)与华莱士(David Wallace)用统计给这桩悬案下了判断。他们不看观点,不看立场,只统计那些不起眼的高频小词。
比如「upon」和「while」,几乎不承载内容,两位作者用起来的频率却差得稳定。对功能词的频率做多变量建模之后,证据强烈支持 12 篇争议文章出自麦迪逊之手。
判归的依据不是立场,是习惯。
二十多年后,心理语言学的研究者把这条线索推得更远。心理学家彭尼贝克(James Pennebaker)与金(Laura King)1999 年报告,代词、冠词、介词这些功能词的使用模式,与人格存在统计关联。他们的材料是 2,348 篇意识流作文,写的人多是心理学导论课上的大学生,写完再填一份 44 题的大五人格量表。
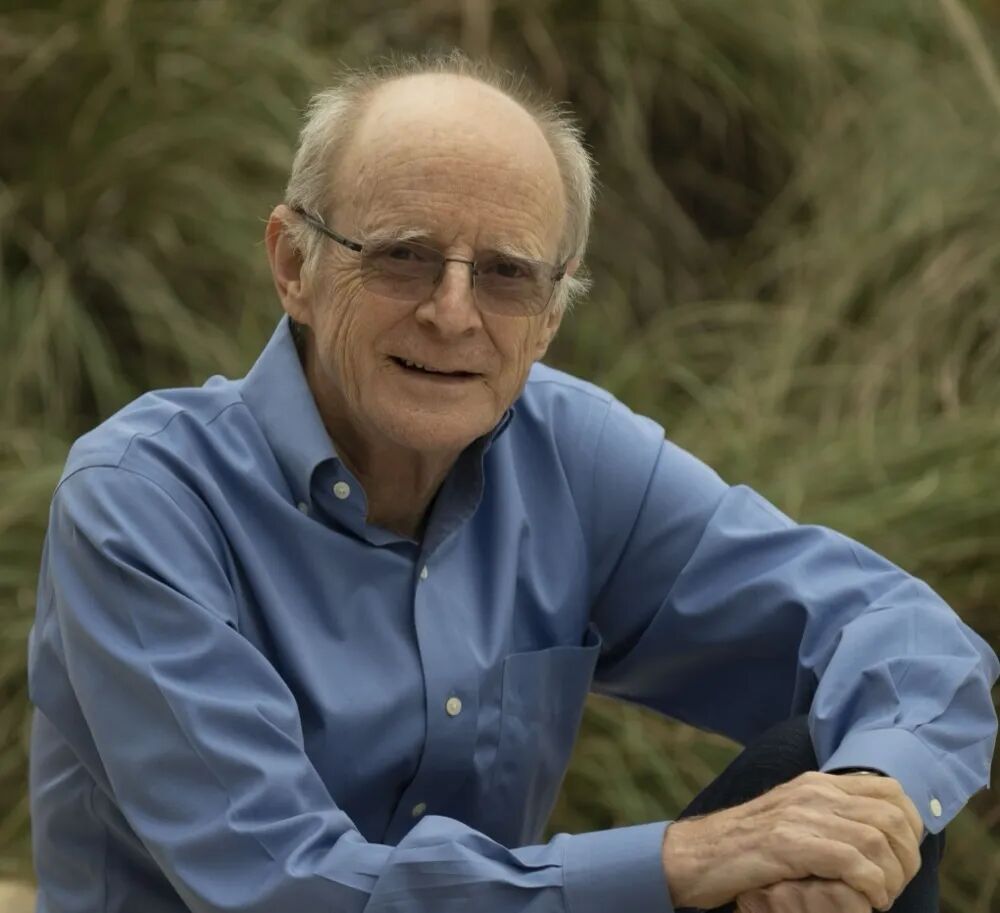
心理学家彭尼贝克(James Pennebaker),得州大学奥斯汀分校荣休教授,1999 年那项功能词与人格研究的第一作者。摄影 Daniyal Sheikh,CC BY 4.0
此后一批研究者把关联扩展到注意焦点与部分心理状态。单看,每个效应都不大,聚起足够多的文本才读得出信息。彭尼贝克在《代词的秘密生活》里整理过同类证据,常被引用的一条是,大量文本里「我」用得更频繁,与抑郁的相关指标同向变化。读的是群体规律,不能拿来给哪一个人下诊断。
两条线索指向同一处,一个人的用词习惯里留着统计上可辨识的痕迹,算不上唯一不变的指纹。莫斯特勒判的只是两位作者之间的差别,彭尼贝克一脉测到的效应也普遍偏小。但文本足够多时,痕迹确实把人和人分得开。
如果越来越多的人,把自己的文字先交给大模型润色呢?
你可能已经有过这种阅读感受:一些文章句句通顺、结构完整,却越来越难看出是谁写的。感受本身不是证据,却引出一个可以检验的问题。
南加州大学「道德与语言实验室」负责人德加尼(Morteza Dehghani)是心理学与计算机科学双聘教授,长期用计算方法研究语言里的道德与身份。他的团队在《自然·人类行为》(Nature Human Behaviour)2026 年刊出的论文里,先追踪了三个平台 2018 年以来的 78 万篇线上文本,又用三款模型做受控重写实验,还拿六类带标签的语料检验身份线索。三项研究前后分析了 88 万多篇文本。
论文作者版首页。来源 arXiv:2502.11266;正式版刊于 Nature Human Behaviour(DOI 10.1038/s41562-026-02550-0)
三个平台的近七年曲线
团队从真实世界入手,收集了三处的长期语料,都以英语为主。学术预印本网站 arXiv 的论文 80,238 篇,美国地方新闻网 Patch 的报道 379,583 篇,Reddit 上「写作接龙」版块(r/WritingPrompts)的故事帖 318,490 篇。三处各自按月合成一条时间序列,arXiv 与 Reddit 覆盖 2018 年 1 月至 2024 年 11 月,共 83 个月,Patch 的序列短一些,止于 2023 年 11 月。每个月统计的是同一时期各篇文章写作复杂度的方差。
方差就是大家写得有多不一样。方差持续变小,就是彼此趋同。
「复杂度」由五项特征合成,四项看用词,一项看句子。看用词的四项分别统计,一篇文章的词汇有多丰富、分布有多均匀、有多少只出现一次的罕用词、有多少种不同词形。
看句子的那一项统计的是,句子里互相搭配的两个词平均隔多远,比如一个动词和它的宾语中间隔了几个字。隔得越远,句子铺得越开。粗略地说,前四项看你的用词有多不容易被猜到,最后一项看你的句子有多舒展。
以 ChatGPT 公开发布的 2022 年 11 月为断点做统计检验,三个平台的方差在断点之后都持续下降,且都通过了检验。
但三地的形态并不一样。只有地方新闻网 Patch 在发布当月就出现显著的下落,arXiv 与 Reddit 是此后逐月缓慢而持续地减小。
团队还做了一步时间顺序上的检验。他们用检测器算出每个月有多大比例的文本被归因为 AI 参与,再看能不能用这个比例前几个月的走势,提前说出方差后几个月的走势。在 arXiv 和 Reddit 上说得出,在 Patch 上说不出。说得出的那两处,说明的也只是 AI 占比先动、方差后动,两条曲线在时间上前后相随,谈不上谁造成了谁。
Patch 上为什么预测不成立,作者在讨论里给了一个解释。新闻编辑部本来就有稿件规范,未必允许记者直接把稿子交给模型,所以 AI 占比预测不动方差。
可方差还是降了。作者的推测是,即便不直接使用,长期读到、模仿 AI 写出来的文字,也可能慢慢改变一个行业对「好文章」的默认想象。作者明说是推测,论文没有检验。
时间序列检验加强了关联证据,却不是随机实验,排除不了同期平台规则变化、作者构成变化等混杂因素,AI 占比也只是检测器的估计,不是真实使用日志。要把「是不是 AI 造成的」再往前推一步,需要什么样的证据也是清楚的,同一作者使用 AI 前后的配对文本,或者带真实编辑记录的语料。
仅凭平台断点,分不开 AI 使用、用户更替与平台规范变化。
同一批文章的重写版
时间曲线断不了因果,于是团队直接做实验。
他们从 Reddit 和 arXiv 各随机抽 1,000 篇人写的文本,都发表在 ChatGPT 面世之前,交给 GPT-3.5、Llama 3 70B、Gemini Pro 三款模型,用 12 种提示词各改一遍。
12 条提示词的原话都列在论文里,其中几句你多半也打过。最温和的一条是「用最好的句法和语法重写下面这段文字,以及其他必要的修改」,最常见的一条是「润色下面这段文字,提高整体质量,不要改变它的意思」。其余十条要的是更清晰、更简洁、更自然、更学术、更正式一类,其中四条明写了不许改动原意或增删内容,另外几条只提通顺和可读性。
改完之后,团队把原文和改稿都换算成一串数字,代表各自的意思,再比两串数字有多接近。87% 的文本,接近程度高于 0.95(满分 1)。
团队还做了一次手工核对。四位作者各自独立看 20 对文本,按三档打分,1 分是意思基本变了,2 分是有明显出入,3 分是只有细微差别。平均 2.97 分,四个人之间高度一致。核对由作者自己做,不是外部评委,样本也只有 20 对。
两项衡量的都是意思有没有走样,答案是大体没有。
写法却变得更相似。在通过检验的结果里,写作复杂度方差缩小了约 21% 到 50%,降幅最大的一格来自「换个说法」类提示。
哪怕提示主要要求改善语法,多数模型与数据集组合的方差仍在收缩。那句提示的原话里也允许「其他必要的修改」,要求改善语法本来就不是纯粹的挑错。例外也有,Llama 3 改写 arXiv 论文时方差反而略升,未达显著。
重写全程由研究者让模型批量完成,模拟的是常见的润色场景,不是真实用户的编辑记录。现实里,人会拒绝 AI 的建议,也会在模型改过之后再改一遍。
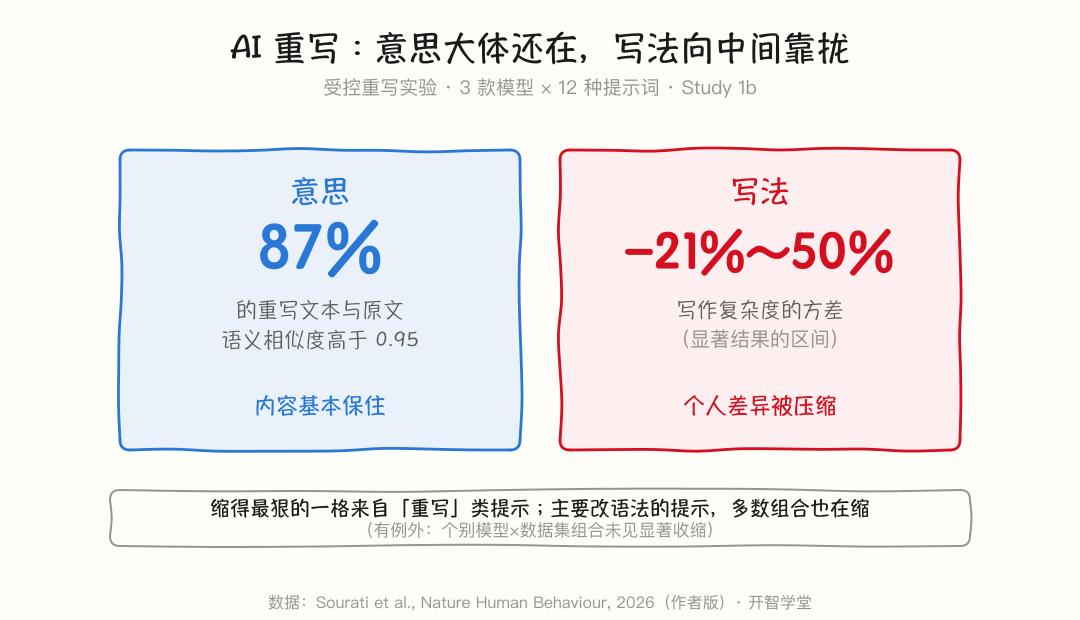
概念示意。比例出自论文 Study 1b 显著结果区间,语义保留率为嵌入相似度口径
变淡的作者线索
变淡的究竟是哪些线索?
计算语言学有一类成熟做法,拿标注好的语料训练分类器,让它从文字去猜写作者身上的标签,年龄段、性别、政治党派、大五人格、共情水平、道德倾向。
训练材料是现成的,有美国国会八千多名议员的演讲,带党派标注;也有附共情测评的对话记录。猜人格用的语料,正是彭尼贝克与金 1999 年那 2,348 篇意识流作文。当年用来建立「功能词与人格有关联」的那批作文,二十多年后成了检验「AI 改写会不会把这层关联磨掉」的材料。
团队先在人写的原文上把分类器训好,再放到 AI 重写后的文本上。
六类标签的预测成绩全面下滑,六次下滑都大到不可能由抽样误差造成(p<.001)。落差最大的是年龄,F1 分数(一个同时考虑「猜中的里有多少是对的」与「该猜中的有多少猜到了」的准确率指标)从 0.351 降到 0.260;猜性别从 0.694 降到 0.623,猜政治党派从 0.664 降到 0.591。
平均降幅是 6 个百分点,六类标签重写后仍然全都明显高于随机猜测的水平。线索是变淡了,不是消失了。
团队接着去看,究竟是哪些线索不管用了。结果不是一起消失。
性别与负面情绪词的关联在原文里成立,重写后基本消失;外向与代词、忠诚与「朋友」类词、年龄与指向未来的词,这几对都减弱了。但神经质与负面情绪词、纯洁与宗教类词、性别与社交类词,重写之后仍然成立。
更值得留意的是方向。模型改过之后,分类器更多地把文章判成出自年长、男性、道德关切更高、共情更低、更不外向的人。政治党派偏得最厉害,真作者是共和党人时,改完的文章也常被判成民主党人写的。偏移是分类器感知到的方向,不等于作者真的变成了这些人。
也就是说,重写不只是把线索整体削弱,还让误判集中到几个固定的类型上。
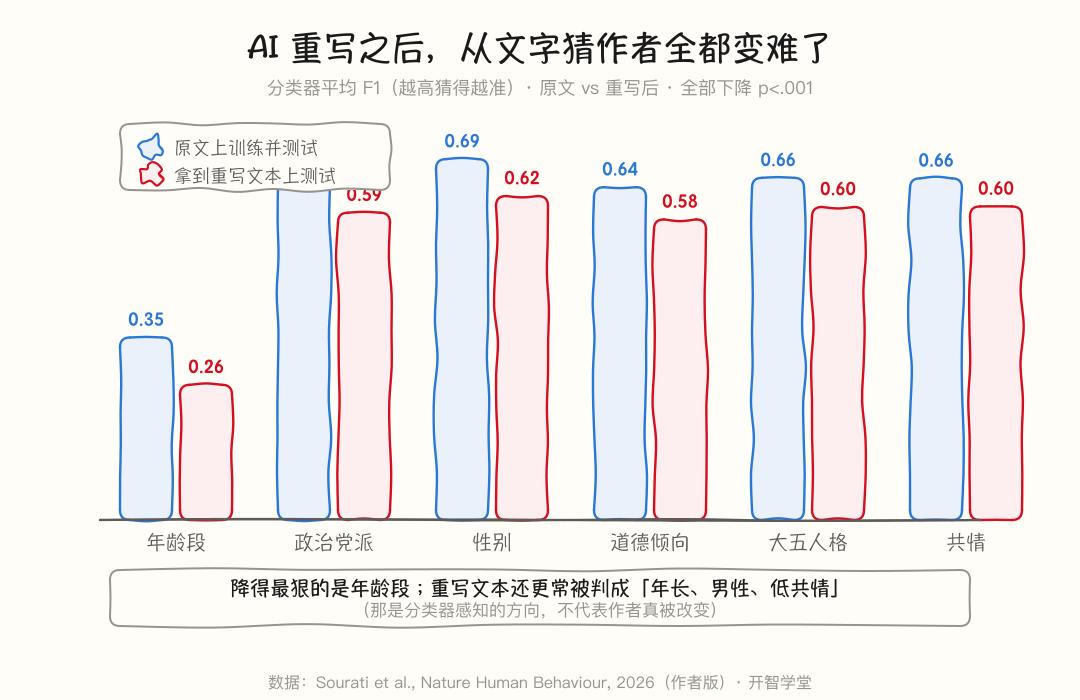
数据出自论文 Study 2,柱为平均 F1(兼顾查准与查全的准确率指标),全部下降 p<.001
线索变淡不全是坏消息,论文自己也说了。学界和业界一直用同一批线索从公开文字里推断陌生人的属性,线索变得不可靠,监控与歧视的门槛也跟着抬高了一点。
代价则在相反的方向。论文列出的几个下游场景,心理状态筛查、共情研究、客户服务里的情绪判读,恰恰都建立在「文字能读出人」的前提上。前提一旦松动,几项做法的地基跟着松动,也正是论文作者担心的现实风险。
今年 3 月,团队的三位成员又在《认知科学趋势》(Trends in Cognitive Sciences)上发表观点文章,把讨论从文风扩展到表达与思维。他们的理由是,训练过程天然更容易让那些出现得频繁、放到哪儿都说得通的表达胜出,少数派的说法淹没其中。
那篇是理论综合,不是新实证。它提出的是一个更远、尚未证实的问题,被压平的会不会不只是写法,还包括看问题的方式?
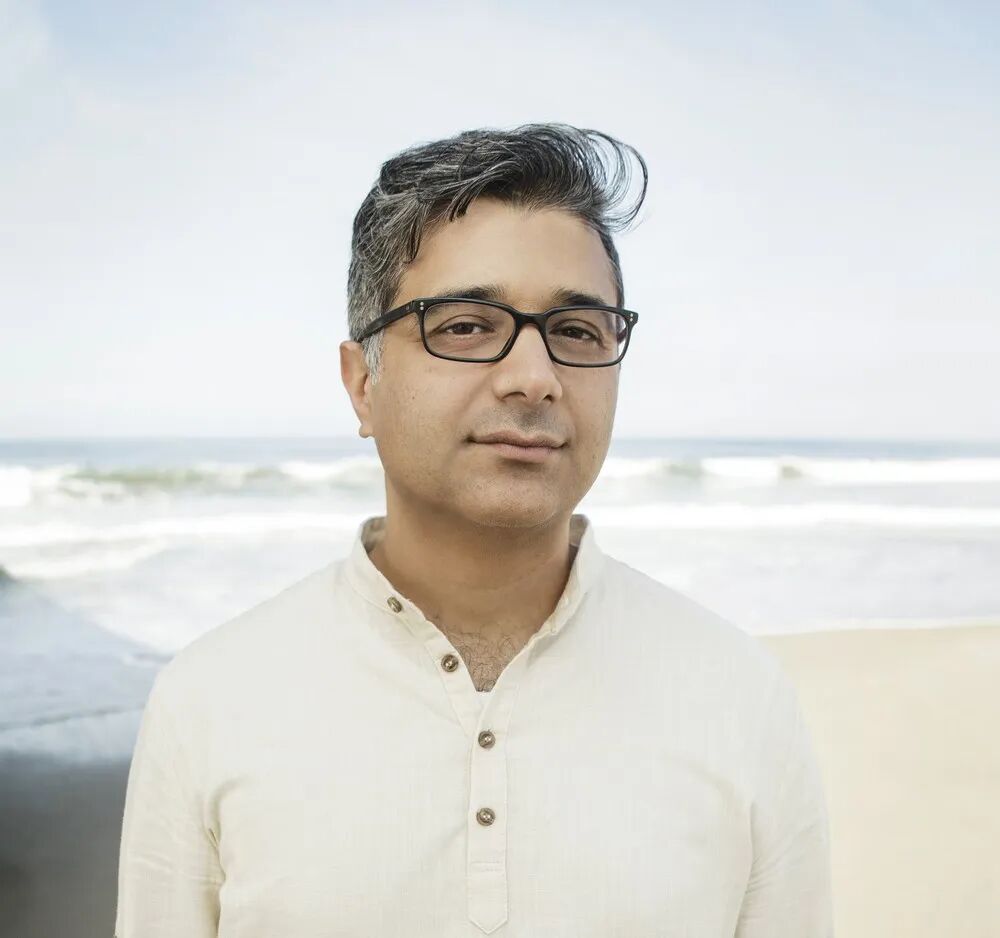
论文资深作者、心理学与计算机科学双聘教授 Morteza Dehghani。图源 mola-lab.org
小词的分量
回到那 12 篇悬案。把这批文章判给麦迪逊的,是麦迪逊自己都未必留意过的那些小词。一个人文字里最像本人的部分,常藏在习惯里。
德加尼团队测到的,是模型批量重写之后,文本之间的差异在缩小,靠文字猜作者身上那几类标签也变得更难。按下「润色」时,模型改动的可能不只是病句,还有一些原本属于你的措辞习惯。
哪种用法能保住它,研究没有测,只知道不同提示的收缩程度不一样,收缩得最厉害的是「换个说法」那一类。语料也以英语为主,中文互联网是不是同样、程度如何,论文没有检验。
研究没有证明「流畅」必然以个性为代价,只是提醒,整段重写不只是改错,也可能改掉那些用于辨认作者的统计线索。按下按钮之前,值得先分清哪些地方可以交给统一,哪些习惯该由你自己保留。
参考文献
Sourati, Z., Karimi-Malekabadi, F., Ozcan, M., McDaniel, C., Ziabari, A., Trager, J., Tak, A. N., Chen, M., Morstatter, F., & Dehghani, M. (2026). The shrinking landscape of linguistic diversity in the age of large language models. Nature Human Behaviour. https://doi.org/10.1038/s41562-026-02550-0
Sourati, Z., Ziabari, A. S., & Dehghani, M. (2026). The homogenizing effect of large language models on human expression and thought. Trends in Cognitive Sciences. Advance online publication.(预印本:arXiv:2508.01491)
Mosteller, F., & Wallace, D. L. (1964). Inference and disputed authorship: The Federalist. Addison-Wesley.
Pennebaker, J. W., & King, L. A. (1999). Linguistic styles: Language use as an individual difference. Journal of Personality and Social Psychology, 77(6), 1296–1312. https://doi.org/10.1037/0022-3514.77.6.1296
Pennebaker, J. W. (2011). The secret life of pronouns: What our words say about us. Bloomsbury Press.
 简体中文
 English