


最近,华为给自己定了个目标:成为英伟达。
华为的监事会主席郭平说:“对于 ICT 业务及计算领域,华为的目标是成为英伟达。”让全球各种大模型,都能在华为的芯片、超节点和集群上高效运行。
我的第一反应是:原来华为主业不是做手机吗?
我的印象里,华为是因为禁令导致手机卖不出去,所以才开始做鸿蒙系统、自己研发芯片的,他凭什么能和英伟达比?
不过郭平这句话里面的 ICT 业务引起了我的注意……
原来,它收入最大的业务,其实是 ICT(Information and Communications Technology,信息与通信技术)基础设施,手机所在的终端业务还要排在后面。而 ICT 正是华为最大的优势。
华为凭什么能和英伟达比
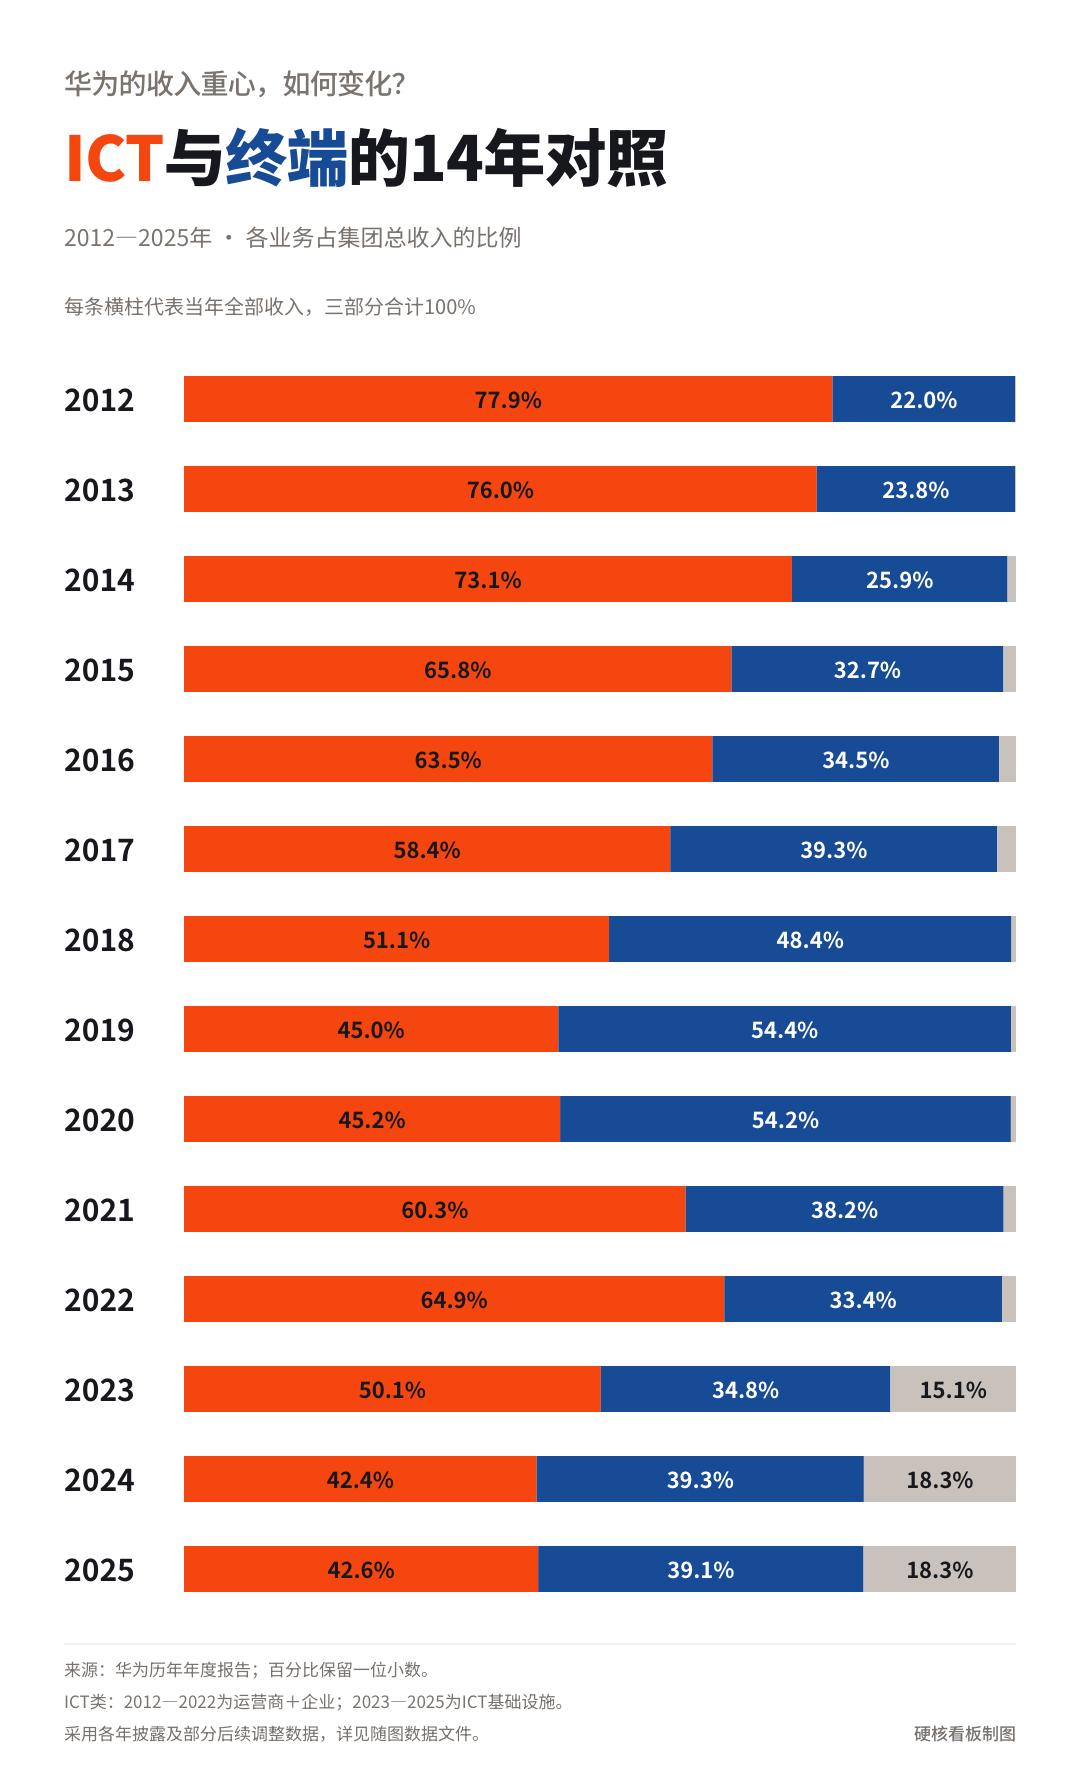
华为 2025 年年报显示,ICT 是华为最核心的业务,超过终端。
华为 2025 年 ICT 业务收入 3750.14 亿元,占总收入的 42.6%,超过终端业务的 3444.73 亿元。
纵观华为的历史,其实手机等终端业务能超过 ICT 收入的只有华为系手机最爆的 2019 和 2020 年。
那为啥华为的「ICT」这么牛逼?
因为华为就是干这个的,华为从一开始就是一家「通信」公司,ICT是他起家的业务。
1987年华为成立的时候,是干代理销售的。卖的是「电话交换机」。这东西一般出现在酒店或者企业内部,用来把电话信息连起来,让每台电话能打内线、也能打外线。
到了1990年,它开始自己搞交换机技术。然后越做越大,连接设备的也从一栋楼里的电话,变成了一个乡镇、一座城市的电话。
再往后,华为开始做无线通信、基站和传输设备,5G 标准里最拿得出手的一批专利,围绕的是一种叫「极化码」的编码方法,管的是手机和基站之间怎么把信息传得又快又不出错。
而且华为做 AI 芯片并不是被禁令逼出来的,昇腾 310 发布于 2018 年,比华为被列入美国实体清单还早了大半年。
郭平的原话限定得很清楚,说的是「ICT业务及计算领域」,手机、汽车、光伏都不在里面;华为的优势在于能让全世界的大模型在华为的硬件上跑起来,对标的正是英伟达那块占总收入九成的数据中心生意。
这生意有多大?
英国《金融时报》2026 年 5 月报道,华为 AI 芯片收入 2025 年约 75 亿美元、2026 年预期约 120 亿美元(路透社说无法独立核实);英伟达 2026 财年的数据中心收入是 1937 亿美元,差了大约 16 倍。
不过华为和国内比就不一样了。IDC 统计 2025 年中国卖出约 400 万张 AI 加速卡,其中有 81.2 万张华为的卡,接近所有国产厂商加起来的一半。英伟达的 H20 被禁之后,中国又要求拿国家资金新建的数据中心只能用国产 AI 芯片,黄仁勋说英伟达在中国的份额「从 95% 变成了 0」。
利用通信优势站上AI赛道
这样再看华为今天要做的事,就容易理解了。它过去几十年积累的一项本事,就是让大量设备之间的数据传得更快、更稳定。到了AI时代,成百上千颗芯片要一起干活,同样得不停地交换数据。单颗芯片的能力之外,怎么让这些芯片高效协作,正好给了华为发挥老本行的空间。
所以华为在AI芯片领域的策略很明白:力大砖飞。
单颗芯片的计算能力比起英伟达差远了,所以华为在 910C 这一代的办法是把两块裸片封在一起,用「双拼」凑出更强的计算能力。
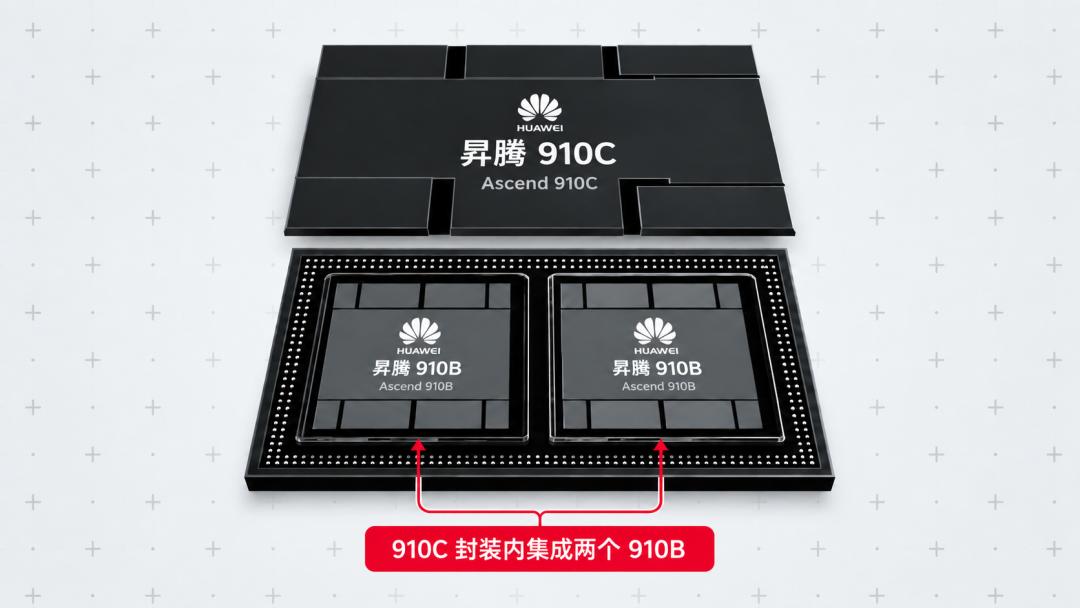
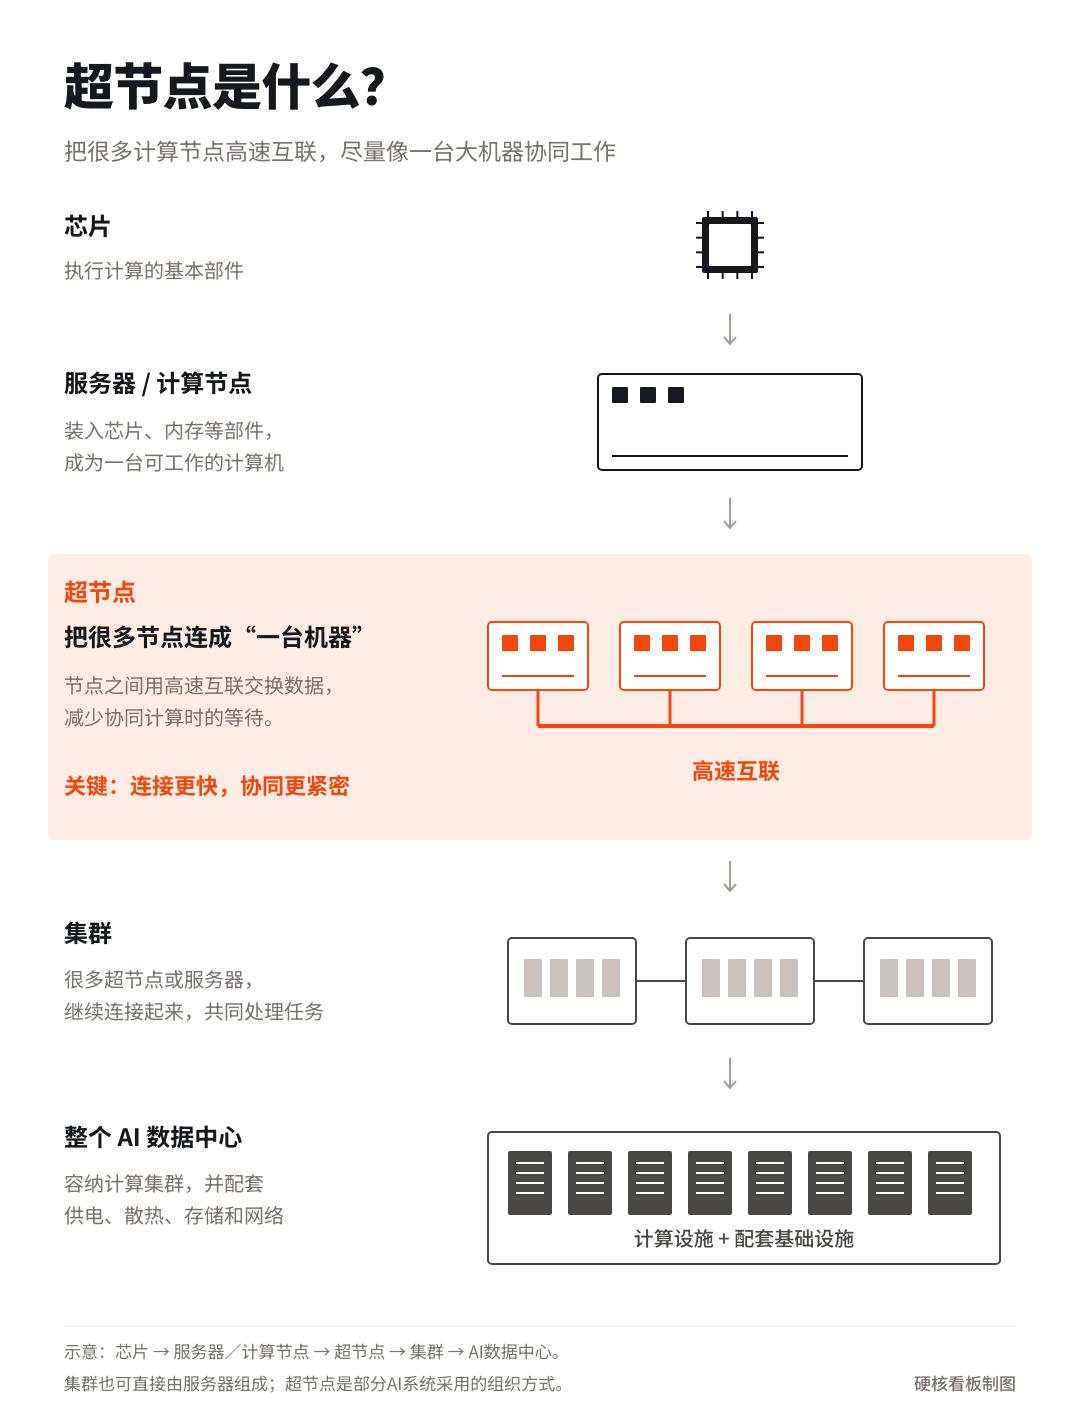
然后再把很多很多这个「双拼芯片」连起来组成更大的「超节点」。
这个「超节点」其实就是很多服务器节点集合。这么多芯片能成功高速互联,靠的就是华为在通信技术的数十年沉淀。
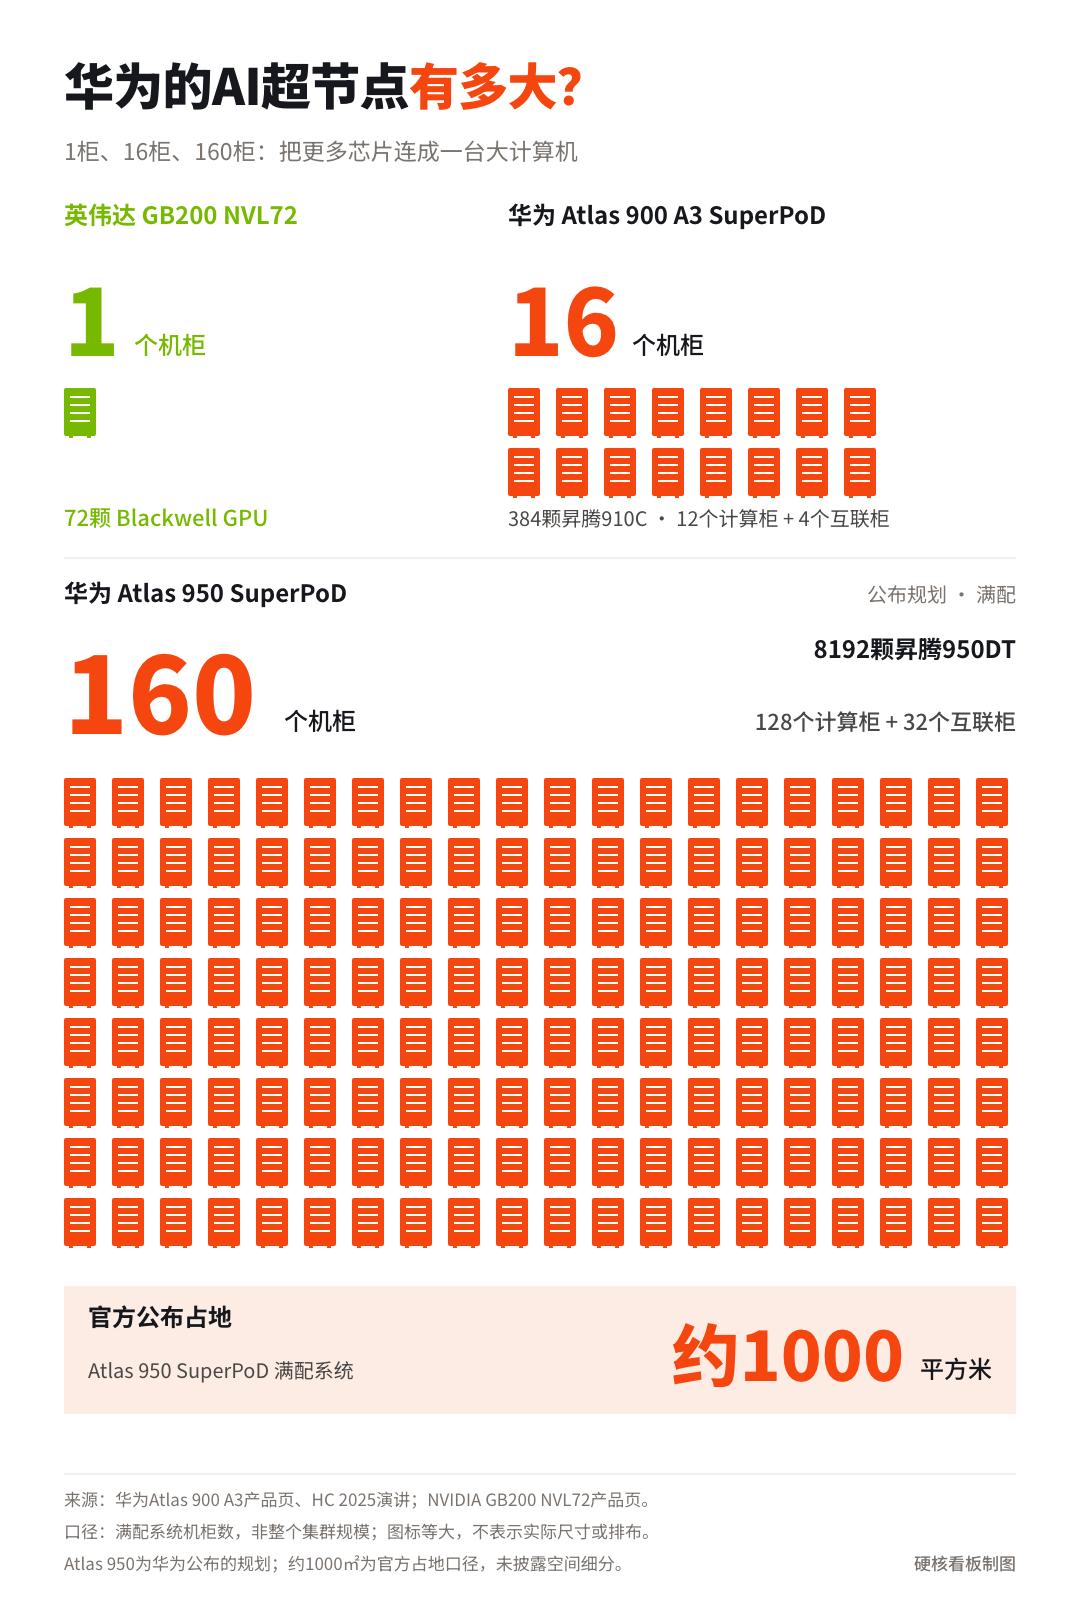
搭载910C的华为 Atlas 900 A3 SuperPoD 有16 个机柜,而英伟达的 NVIDIA GB200 NVL72 集群只有一个机柜。
华为宣传的下一代 Atlas 950 SuperPoD 有160个机柜,设备占地有将近1000平方米。
但这会带来巨大的问题。
第一是耗电量巨大。
SemiAnalysis 对华为的 CloudMatrix 384 的测算显示,整套系统功耗约为559 千瓦,是英伟达 GB200 NVL72 超节点的 4.1 倍。
第二,这么大规模的集群、信息传输是也是一个很大的问题。
因为把更多芯片连起来,可不只是多插几根线那么简单。连接距离拉长,就需要用到「光互联」技术;而训练任务持续运行,光链路的短暂故障也可能造成整个节点通信中断。
开源模型 Llama 3 在技术报告中披露,使用16384张H100的训练集群,在54天观察期里出现了466次中断,其中419次是意外中断。而训练又必须同步,坏一张卡整个集群就得从存档点重来。也就是说,能不能连得稳、断了能不能立刻切回来,和单颗芯片跑多快一样要紧。
但华为作为一个老本行是搞通信技术的公司,这东西正好撞枪口上了,通信技术是华为绝对的强项。
华为的解法是重新设计光器件和互联芯片,在光路上做百纳秒级的故障切换,把光互联的可靠性提高 100 倍、距离做到 200 米。
而且华为原来做传统通信、云服务的时候已经在国内造了很多机房,电力规划也不是难事。华为云在芜湖、贵安、乌兰察布布局了自建自营的数据中心,这些积累为超节点的供电、散热和部署提供了基础。
就这样,华为依靠自己通信技术的优势来弥补计算能力的短板,研发出了昇腾系列芯片、Atlas系列服务器节点。
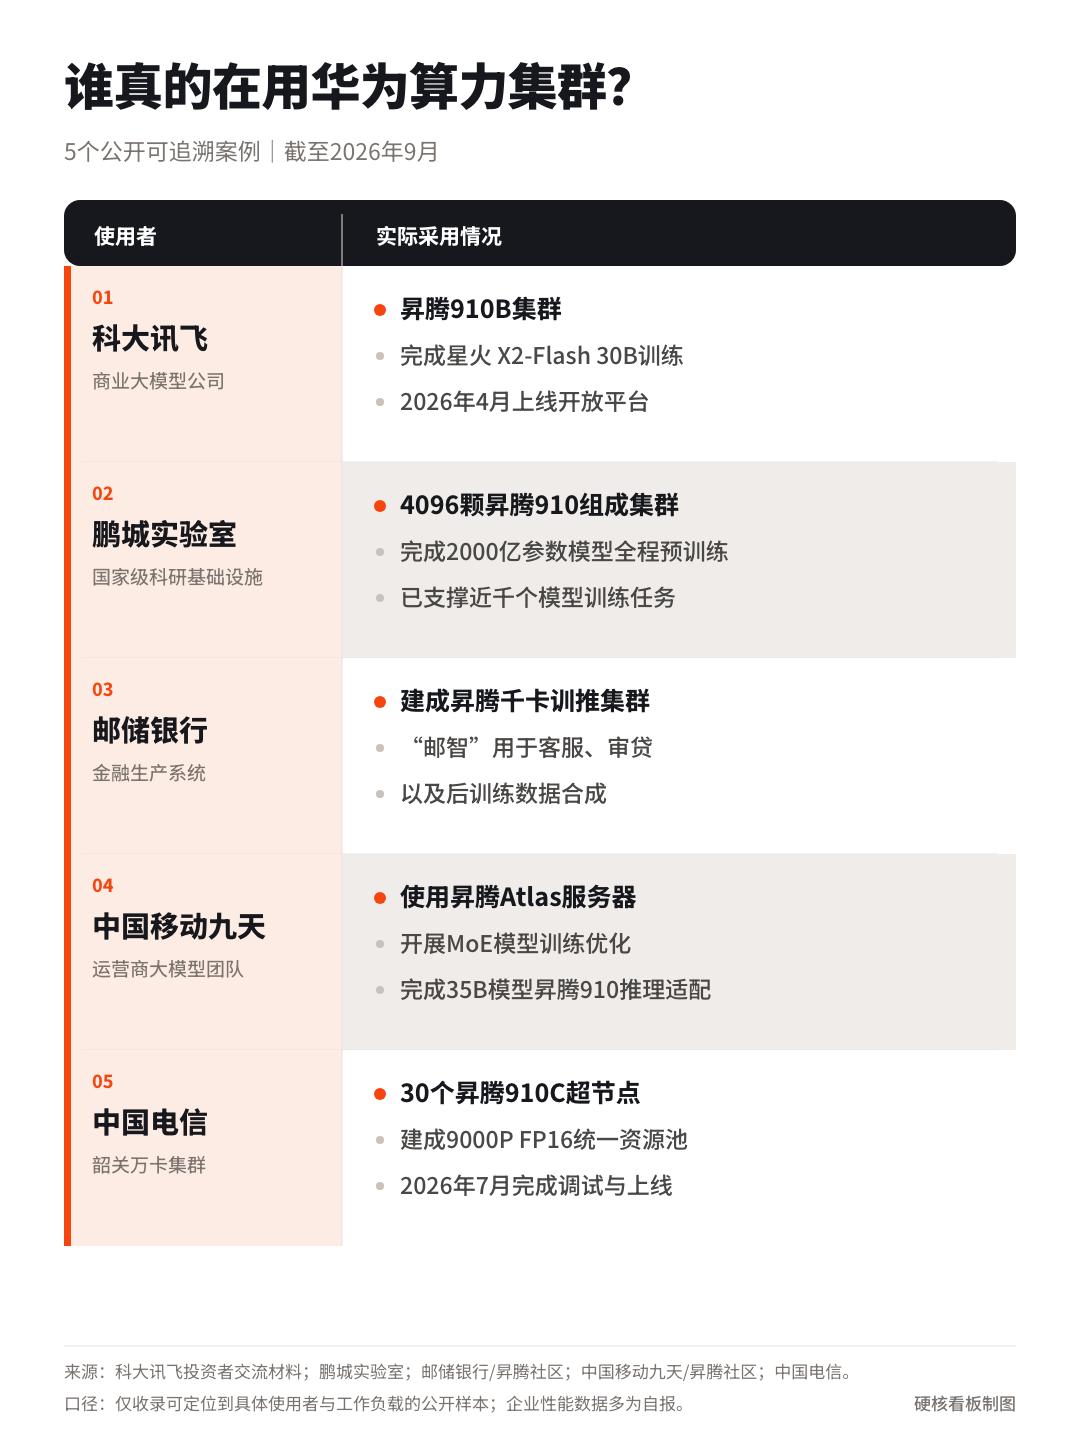
华为目前成熟的的 910C(就是前面提到的「双拼芯片」)超节点已经累计部署了超过1000套,而一年前这个部署量还是 300 多套。950 超节点在 9 月 17 日的全联接大会上宣布已规模商用,下一代 960 芯片里的 960DT 比原计划提前三个季度,2027 年一季度就绪。
那照这个势头,华为真的能成中国英伟达吗?现在的距离还有多远?
距离「中国英伟达」还有多远
首先,还差HBM(High Bandwidth Memory,高带宽内存)。
我们平时说的「卡」、也就是「计算模块」上除了AI 芯片以外,还需要内存。
AI 芯片运算时需要不断读取海量数据,内存的速度跟不上,芯片算得再快也没用。所以为了能尽可能增加内存数据的传输速度,HBM把内存的带宽拉到非常高。
我们常说的「5090显卡」上面的 GDDR7 内存单颗粒位宽有 32 比特、266 根导线,而 1024 比特的 HBM3e 有足足 3982 根导线。
而要造出 HBM,除了把这么多导线排进去,还要解决芯片减薄、硅通孔、精密堆叠和散热一连串工艺难题。
现在全世界能量产 HBM 的只有三星、SK 海力士和美光三家。2024 年 12 月,美国商务部把高带宽密度的 HBM 全部纳入管制,华为根本没法从海外采购这三家成熟量产的 HBM。
华为手上还有管制前囤的 HBM2E 库存,自研的 HiZQ 2.0 也做到了 144GB、4TB/s,和 H200 一个档位。
8 月 31 日,The Information 报道称国内内存厂长鑫,已经开始小批量生产 HBM。但 HBM3 初期良率只有25%左右,而业界量产的标准在 80%左右。产能严重不足、明年才能扩大生产。
但相对技术本身来说,良率的提升相对会轻松一点。三星的 HBM4 良率今年2月还不到60%,半年就拉到了80%。
静候长鑫佳音,长按屏幕为他加速助力。
反观英伟达,背后是 SK 海力士和美光大规模量产的供货。所以华为即便有了 AI 芯片,高速内存这一环还没补齐,整个计算模块的能力和英伟达还是有一定距离。
另外,对于前沿模型公司来说,主要有两件事有巨大的算力需求:「训练」和「推理」。
简单来说,训练就是公司内部开发新模型的过程,这部分对计算能力和稳定性的要求都更高;
而推理则是面向用户的服务,也就是用户对话过程中模型思考的过程占用的算力,对计算能力上限的要求就没有那么高了。
训练需要几千张卡连轴转几十天,掉一点链子都要回退重来。所以,国产芯片从推理入手是自然的选择。
但是在中国市场,英伟达能对标的产品现在合法买不进来。所以作为能「买得到」的芯片,昇腾已经成了一些国产AI公司的选择。
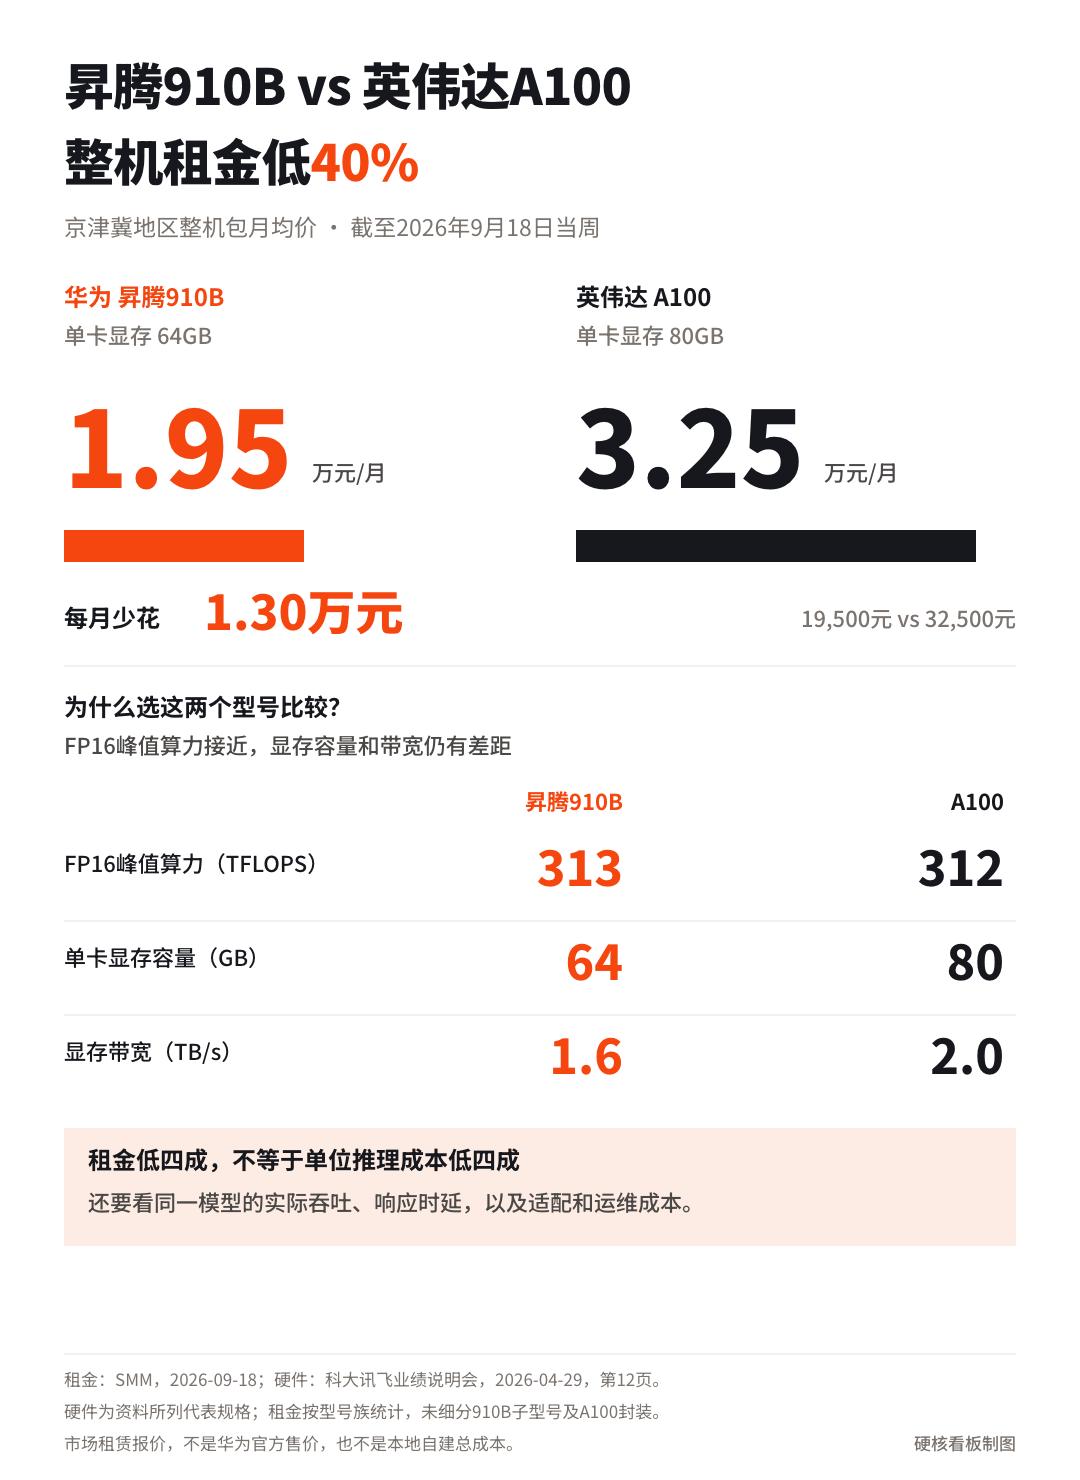
另外,便宜也是加分项,性能相近的华为 910B 比英伟达 A100 整机租金低 40%。
毕竟和训练相比,只是做推理的话对芯片能力的要求并没有那么高,还是便宜更重要。
但最重要的问题是软件生态。
CUDA 是建立在英伟达 GPU 之上的一整套软件系统。这其实才是英伟达最深的护城河,现在几乎所有的AI训练都是在英伟达的CUDA架构下完成的。
华为虽然也搞了自己的对标 CUDA 的软件系统「CANN」,但是比起已经发布近20年的 CUDA 来说还有不小距离。
CUDA 里的工具、模型和教程大多是现成的,出了问题也容易在文档和社区里找到答案。但 CANN 不仅社区文档不成熟,而且稳定性还远不如 CUDA,要经常重新适配、反复测试,甚至为一个模型单独优化,对用华为系统的开发者能力要求很高。
而且 CUDA 生态里最好用的那些东西都不是英伟达写的。大模型相关的各种研究在开源时默认只出 CUDA 版本,英伟达一行代码没写,护城河却在自己变深。相比之下 CANN 社区的月活开发者今年才刚超华为内部的开发者数量。
而且就算解决了软件稳定性、软件栈薄弱的问题,用户选择软件系统的惯性对于 CANN 的大范围应用也有很大影响。
我连从Windows换成苹果的操作系统都要适应好久,对于习惯了 CUDA 的工程师来说,从一个在训练里已经垄断了整个体系的生态,短时间内换到华为的新生态代价是巨大的。
虽然道阻且长,最近也算是看到了华为昇腾和CANN体系在AI领域应用的第一道曙光。
Deepseek V4-Flash 的训练就有昇腾的参与。华为也通过 CANN 开源了V4-Flash和V4-Pro的续训练方案。
而且有第三方团队在千卡级的昇腾910C集群上,完成了V4-Pro的后训练。
根据 AI 研究机构 Epoch AI 的分析,虽然华为在芯片技术比英伟达落后 3 到 4 年,国产 HBM 产能也远远落后 SK 海力士、三星和美光。
但华为确实可以拿来作为中国的代表和英伟达好好比一比,CANN 在未来也有越过英伟达护城河的可能:
“尽管 CANN 目前不如 CUDA 成熟,但它具备成为竞争者的可行性……鉴于中国实验室的开源倾向以及它们对加强中国国内计算能力的关注,它们可能比闭源的西方实验室更愿意与华为分享架构细节,并为生态系统做出贡献。”
从 1987 年代理别人的电话交换机,到今天把上万张华为自己的卡连成一台逻辑计算机,华为走了快四十年。「成为英伟达」眼下还是个目标,但华为已经用能力证明了自己能做出昇腾芯片、能做出 CANN 系统。接下来就是沿着这条路继续努力了。
郭平说过一句,「真正阻碍华为发展的并非外部环境,而是内部能力」。这种难度的事,华为过去也不是没做成过。
 简体中文
 English