


11 月 19 日,Anthropic 登陆纳斯达克,IPO 发行规模达到 813.4 亿美元,创下全球 IPO 融资纪录。
它的招股书里,有一组值得创业者关注的数字,超过一半的财富 500 强企业,过去一年在 Anthropic 上花费至少10万美元,但这个数字,还不到他们总开支的0.1%。
企业已经开始付钱。接下来,AI 能进入多少真实工作、承担多复杂的任务,还需要解决一连串具体问题,这些问题,正在成为新公司的起点。
Anthropic 的上市,让人们看到一家 AI 巨头走到哪里。沿着这些初创公司往下看,则能发现整个行业还有哪些环节等待补齐。
我们研究了 26 年 YC 孵化的 842 家公司,发现 AI 创业趋势正在变化。这篇复盘,我们梳理出四条创业主线,看看技术突破、客户需求和资本投入,如何变成一家家新公司的生意。
AI 创业的风,往哪边吹?
应用不再是主线。
垂直行业 Vertical AI 和跨行业的 Horizontal AI,占比自 25 年以来,出现下降的大趋势,从 25 年七成多到今年仅剩三成。
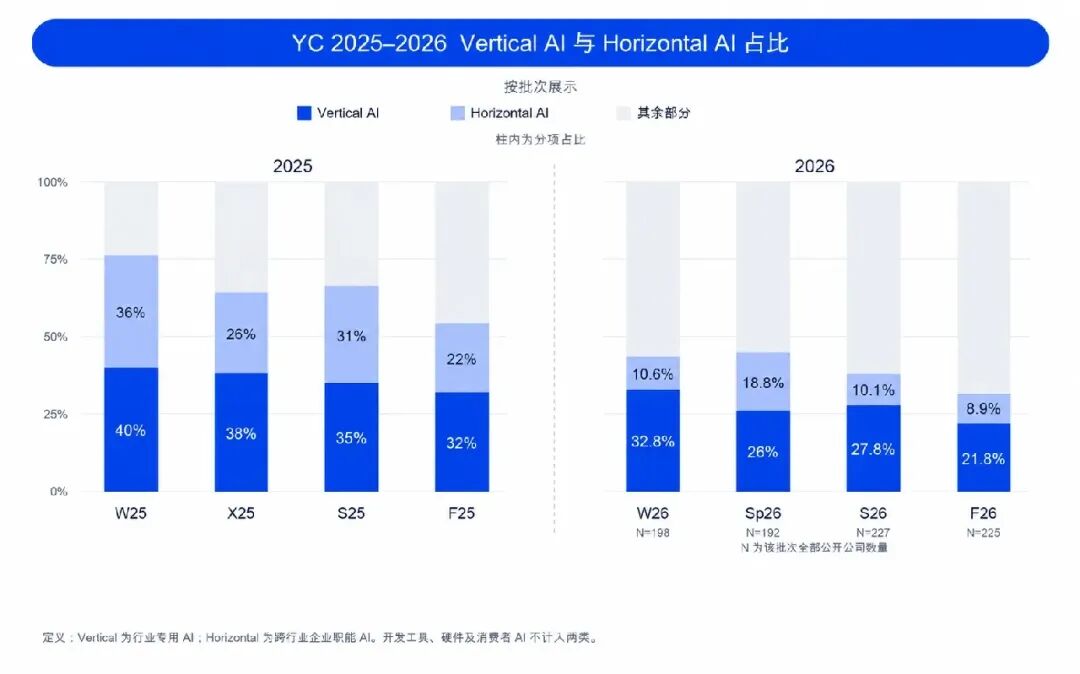
数据来源:YC;YC 一年 4 期孵化,分为冬季(W)、春季(X/ Sp)、夏季(S)、秋季(F)
哪些赛道增长?
最明显的赛道是 硬科技, 包含机器人、航空航天和新能源在内,相关公司数量涨了10%。主要受这几方面刺激:AI 降低硬件公司的软件开发成本,同时加快科研和工程验证;SpaceX上市利好;AI 算力投入拉动实体建设。
其次是消费者 AI,显然 Personal Agent 公司 Instinct 13.5 亿美元融资制造了新的 fomo 情绪。
开发者工具与 AI 基础设施、模型推理服务小幅上扬。
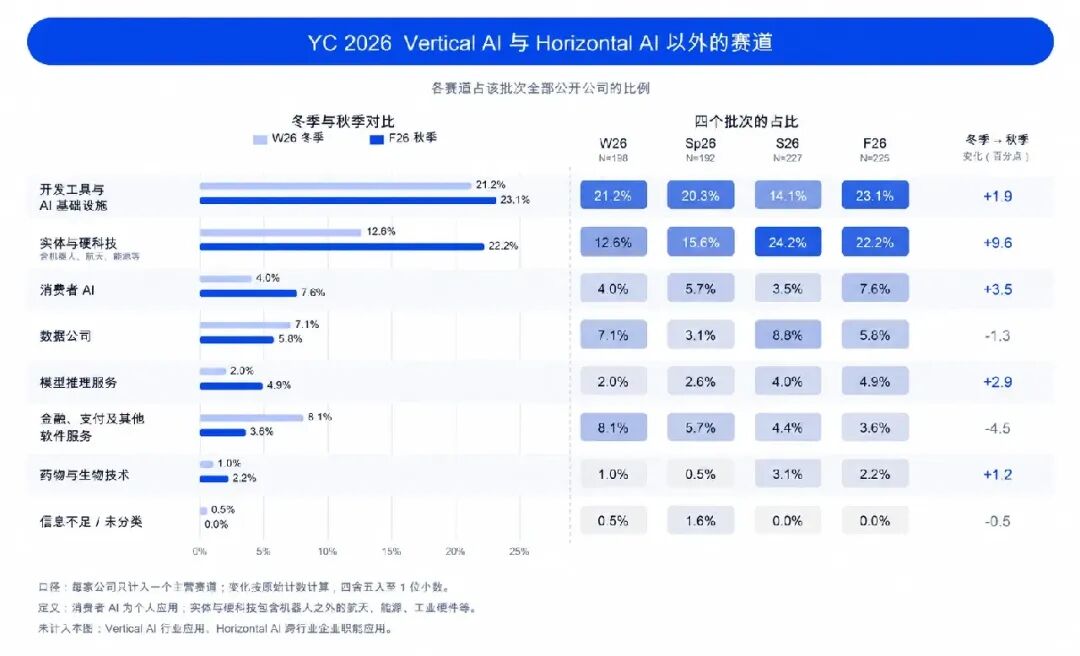
数据来源:YC
赛道变化,背后逻辑是什么?据我们观察,本质是从模型的智能到真实的业务收益,还有很多中间环节、落地问题需要解决。
Anthropic 的招股书中也揭示了这一问题—— 企业部署的瓶颈,不只是模型能力,还有没有完善的系统连接、没有充分的治理规则,还需要重新设计的工作流程。
如果我们看 Anthropic 的客户数据,会发现 AI 在实际工作中的渗透很浅,虽然超过一半的财富 500 强企业都是 Anthropic 的客户,且他们年消费超过 $100k,但平均来看,这个数字甚至不到他们总开支的 0.1%,哪怕用量最多的 10 家,他们在 Anthropic 花的钱也不到他们开支的 1%。
因此,为真实商业场景嫁接模型智能的工具、服务、平台,拿到不错的融资结果。举两个例子:
AI 安全就是一个典型的赛道,Tolmo 获得 Accel 领投的 $22M,主要功能是检查客户的生产环境中存在的漏洞并帮助修复,例如客户新上线了一个接口,安全团队需要知道这个接口是否对外开放、能接触哪些数据、假如受到攻击能否出问题,以及修改后会影响哪些服务,这一连串的问题就是 Tolmo 要用 Agent 帮客户解决的。
另外一个有意思的案例是 Paradev,这是一个管理 Coding Agent 的工作台,用户可以同时安排多个 AI 写代码,互不干扰,最后统一检查结果。产品需求可以从1.63 万颗 Github Stars 看出,USV 领投他们 $11.5M 的融资。他们押注的是 AI 大量写代码之后产生的瓶颈,用户需要新的工具来组织、检查这些 AI 的工作。
什么样的应用,能拿到千万美元种子轮?
YC 应用卷团队、卷业绩。
根据公开资料,26 年 YC 种子轮融资“大结果”的标准提升到 1000 万美元,符合此标准的 AI 应用公司有:General Legal(法律)、Clara(医疗)、Complir(电商)、Tasklet(Work Agent)、Ploy(GTM Agent)、Vorflux(Coding Agent)。
我们粗浅的分析一下,为什么是他们拿到“大结果”。
第一个显而易见的因素是,大牛创业团队。
General Legal CEO 此前是 Casetext CTO,Casetext 是一家 AI 法律公司,23 年被 Thomson Reuters $650M 全现金收购,这意味着,创始人已在法律 AI 应用领域有过成功经验,二次创业再战法律行业的成功率提升。
Clara 的团队也在医疗领域取得一定成果,他们此前都在 Circle Medical 工作,其中 CEO 曾带领这家互联网医疗平台创造 $100M ARR 并实现盈利。新公司 Clara 讲 AI 叙事,但底层逻辑仍是降低医疗服务的获取门槛。
Tasklet CEO 同样有成功退出履历,此前创办的 Firebase 被谷歌收购,提供 APP 开发工具。并且 Tasklet 两位创始人共事多年,从 Firebase 到谷歌,再一起创业。
Poly CEO 也是大牛,只是选择了跨行创业。CEO 此前是网站开发工具 Webflow 的联创兼 CTO,目前转向构建 GTM Agent,Poly 帮公司做网页、写文案,并宣传推广,吸引访客变成客户。
Rippling 联创兼 CTO 也选择了跨行创业,且选择了竞争白热化的 AI Coding 赛道,Vorflux 自动写代码、做测试,直接交付任务结果。
第二个便于识别的因素是,早期亮眼的 ARR 数据等增长验证。
$1M ARR 是一个重要里程碑。General Legal ARR 从 0 到 $1M 花了 84 天,$1M 到 $2M ARR 只用了 41 天;Poly YC 期间 ARR 接近 $1M。
增长率也是一项可观测的指标。AI 商品合规“专员” Complir 在 YC 期间收入增长 4 倍,月环比增速 40%。Complir 帮商家检查商品是否符合各国规定,并准备所需的标签和资料,目前管理 100k+ 商品信息。
目前看到 ARR 数据和增长率最高的是 Tasklet,据其团队称,仅半年时间 ARR 突破 $5M,增速 1200%。
以上是个例,这组数据则更能说明整体情况—— YC 官方数据显示,入营企业在孵化期间实现的 ARR 中位数从 $80k 增长到 $200k,提高了 2.5 倍。很明显,YC 公司要想拿到好的融资结果,必须卷 ARR。
接下来,四类生意值得看
1. 数据生意“吸金”能力强
在我们的数据统计中,AI 数据公司 Luel 以 $31.2M 种子轮融资额一骑绝尘。 数据公司吸引风险投资的能力很强,AfterQuery 号称 YC 史上增长最快的公司,根据其 $3.2B 估值推算,它两年时间可能融了 $300M+。
YC 数据公司的赚钱能力也很强,YC 数据显示,其过去两年投资的公司中,有十几家,靠向模型实验室卖数据或者强化学习环境,每家年收入超过千万美元。我们之前接触过的 Ooak Data,主攻真实工作流数据,仅半年时间已拿到头部 AI 实验室价值千万美元的合同。
回归 Luel 这家公司,为什么它的种子轮融资规模这么大?
Luel 以重运营的模式,组织世界各地的人力按照客户需求采集真实长尾数据,主要采集音频、视频和用于具身训练的动作记录,再完成质量检查和授权交付。除此以外,Luel 也接受第三方上架数据集,平台参与分成。
把 Mercor、AfterQuery 和 Luel 放在一起看,AI 数据需求正在变得越来越细、越来越具体。从金融、法律等专业工作的判断过程,到家务操作、小语种对话等长尾真实场景,模型公司都在寻找能补足能力缺口的数据,并愿意付钱组织人去生产。
而数据这门生意,也在变得没那么好做,Luel 的运营非常重,需要管理分布在 96 个国家的 50 多万数据贡献者,为每笔订单找到符合要求的人,还需要对最终的交付结果负责。客户对语言、设备、场景和动作的要求越具体,交付就越难标准化。数据能否重复出售,又取决于授权范围和其他买家的需求。订单增长的同时,人员、采集成本和资金投入也可能一起增加,收入跑得快,利润未必跟得上。这些,都是 Luel 这类数据公司需要面对的实际问题。
与数据相关的公司,我们在 YC 26 中识别出了 37 家,可以分成以下几类。
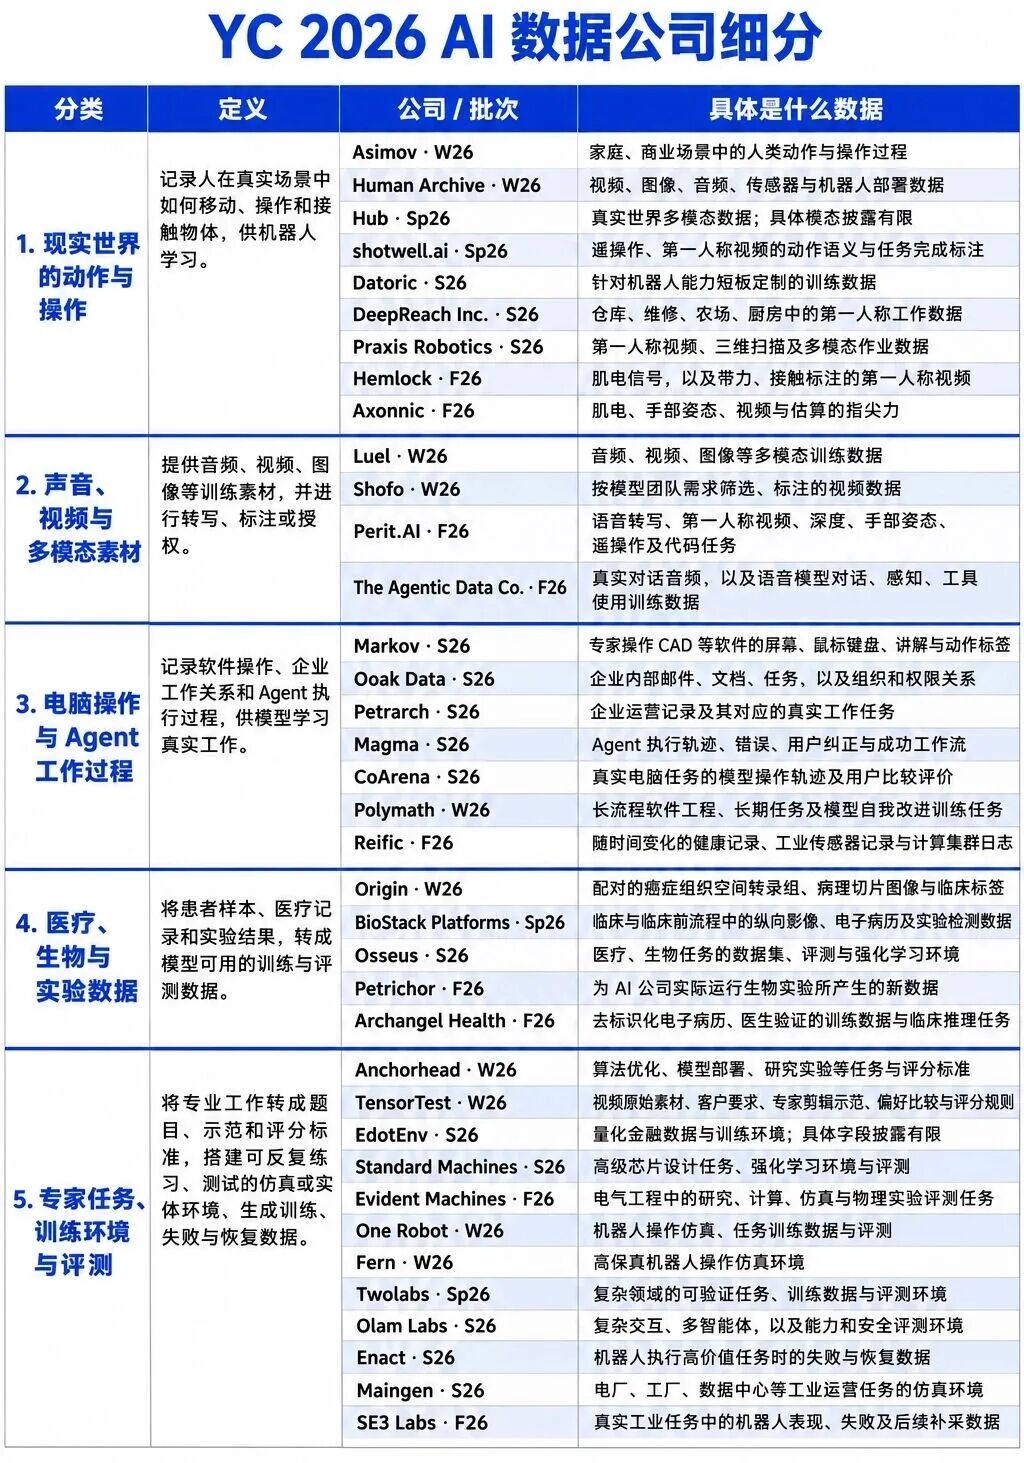
数据来源:YC
2. 企业专有智能,后训练是新的基础设施
25 年春天,Deepseek R1 进入大家的视线,如何用好开源模型是创业者和投资人关注的焦点。
企业逐渐拥有很多开源模型选择,但需要稳定可靠的运行模型,这催生了 Together AI、Baseten、Fireworks AI 这些 AI Inference 基础设施的快速增长。
Wafer 是这一阶段成长起来的公司,从 GPU Kernel 优化切入,利用 AI Agent 自动改写和优化底层计算代码,后来进一步提供完整的模型推理服务。2026 年,他们的 ARR 超过了 $40M。
时间来到 26 年,企业从使用开源模型,到需要更加贴合自身业务的专属模型,模型后训练顺势成为新的创业机会。问题是,大部分企业没有 Frontier Labs 那样的训练团队。因此,降低模型训练门槛的基础设施公司出现了机会。
YC 中出现了不少做模型训练 infra 的公司,相关公司的数量占比从 2% 到 4.9%,但到现在并没有跑出来的明星案例。
YC 以外,我们也看到从不同角度切入的初创,例如:
专注 AI 推理基础设施的 NeuroSpark,通过异构算力整合、全栈推理优化与智能资源调度,提高 GPU 利用率、降低单位 Token 推理成本,为企业提供高性能、低成本的模型推理服务。
专注边缘计算与 Physical AI 场景的智能体推理系统 Fluxion ,通过弹性内存管理、异构芯片优化及端云协同调度,让多模型在有限硬件资源下高效运行,降低推理成本并保护数据隐私。
同样专注 AI 推理基础设施的 MarsCompute,通过 AI 驱动的自动化算子优化、显存管理及异构芯片适配,提升 GPU/TPU 推理效率并降低 Token 成本。
展望 27 年,新的关键词可能会是 “Own your intelligence”。
在大模型“吞噬”一切的阴云之下,如果仅仅调用相同的模型 API,难以建立长期差异化。
企业真正独特的能力,还是对特定任务的理解、对高质量结果的判断,以及持续积累的客户反馈。如果能将这些转化为高质量训练数据、Eval 和 Reward,再通过 Post-training 固化到模型中,就有机会形成更深层次的差异化。
因此,将企业工作流程变成评测,将专家经验变成训练数据,将失败变成模型改进,人们开始寻找点亮这些技能点的公司。
Agnost AI 从生产日志分析切入,帮助企业识别 Agent 在实际使用中出现的失败、错误和重复任务。它发现企业在大量简单、重复的工作上,仍然使用昂贵的通用前沿模型。于是公司开始利用这些生产日志构建评测集和训练数据,为客户训练针对特定工作流的小模型。
既然要构建属于自己的智能,自然而然垂直模型重回谈判桌。
毕竟,并不是所有行业都需要以 LLM 为基础。比如一些预测类的任务,需要处理结构化数据、事件序列、时间关系和概率,而不一定需要一个擅长对话的通用 LLM。
例如金融垂直模型,Lyon 利用金融机构的交易记录、贷款历史和客户行为,构建专门面向金融的基础模型。同一套模型可以应用到欺诈识别、信贷违约预测、客户流失和产品推荐等多个任务。
在这条主线下,我们整理了以下公司。
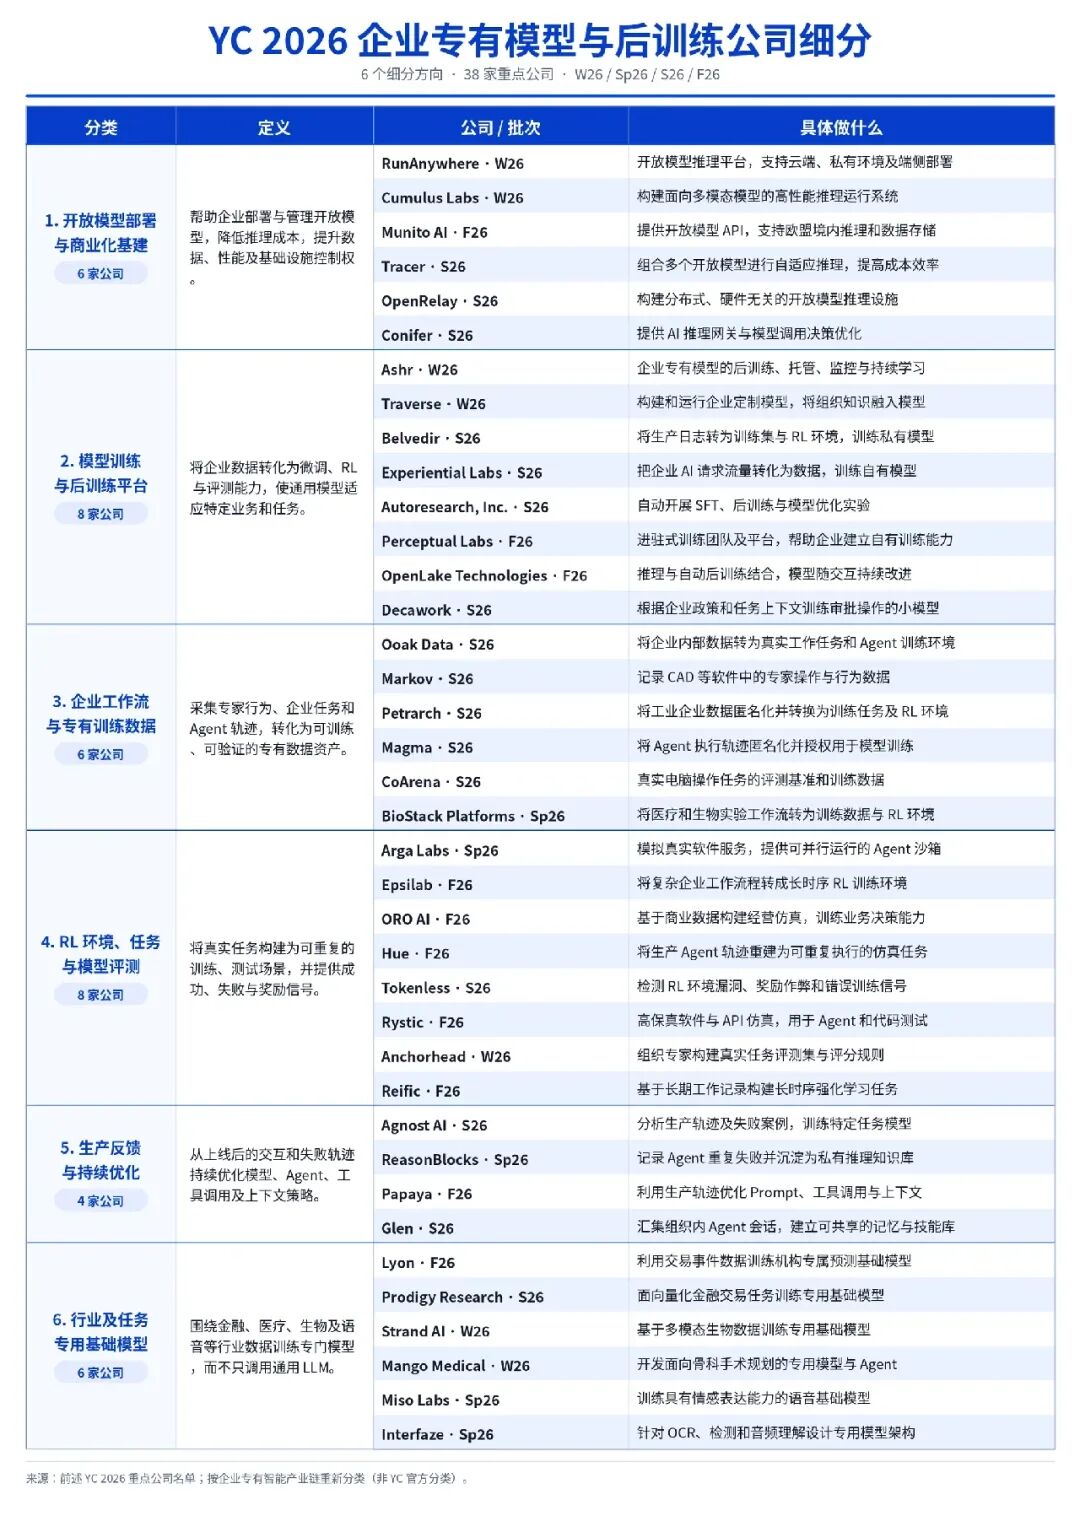
数据来源:YC
3. 解决具身瓶颈,回应热潮的理性声音
我们发现,早期对具身的关注,早已从模型本身,扩展到 3 个更基础的问题: 真实世界的数据从哪里来、机器人如何在部署中持续学习,以及硬件和资本如何支撑规模化。
机器人数据采集经历了几轮的迭代,先是 在真实机器人上进行遥操作,由操作员远程控制机械臂,反复完成抓取、放置和装配任务。
这种方式能够直接生成适配机器人本体的动作数据,但成本非常高,采集规模受制于机器人数量、场地、操作人员和设备维护能力。
第一轮迭代—— 第一视角视频 + 可穿戴设备,采集人类完成任务的真实过程,再将这些经验转化为机器人可以学习的数据。
Human Archive 通过可穿戴采集设备,记录人类在家庭、餐饮、酒店和工业等场景中的操作。数据不仅包括第一视角视频,也可以包括手部姿态、深度以及触觉等信息。公司披露采集系统具备最高每天 8,000 小时的数据生产能力,已经向前沿模型研究团队交付数据,并签署扩大贡献者网络的合作安排。
DeepReach 采用分布式采集网络。把自研设备交给不同国家的本地合作伙伴,让这些合作伙伴进入仓库、维修店、农场等场景采集数据。已部署 475 台设备、超过 100 个合作伙伴、覆盖 7 个国家;过去三个月采集近 15 万条视频片段。
第二轮迭代—— 视频的维度太单一,还需要触觉、力觉、接触状态等多模态信息。
YC 最新一期,集中出现了多家以力觉传感数据为核心的公司,尝试通过触觉传感器、肌电信号等手段,补充视觉无法直接提供的物理信息。
Axonnic 开发可穿戴前臂 EMG 袖套(优势在于不需要覆盖使用者的手掌),可以同步采集肌电、视频与手部姿态,即使手部被遮挡也能追踪动作。最适用于对缝纫、工具操作、精细装配等任务。
Hemlock 自研 EMG 和第一视角采集设备。有测试案例证明,在某些力敏感任务中,增加物理接触信息会比单纯增加更多同类视觉数据有效。
Preload 尝试将多种感知信号整合为完整数据产品,将第一视角视频、触觉手套和 EMG 组合为统一的采集系统。
有生产能力,只讲了机器人数据故事的一半,因为,解决具身的瓶颈,还要回应如何让机器人在真实任务中持续学习。
因此,机器人数据故事的另一半,是训练反馈和评测。
Enact 直接围绕机器人模型持续学习建立产品,并不简单地出售大量机器人示范数据。
先让模型在真实机器人上运行,找出反复发生的失败状态,再针对这些问题采集恢复动作,重新训练,并在真实环境中评测。
该公司公开了一项发现:200 条普通示范数据可以实现 90% 成功率;数据增加到 250 条后,成功率不变。但如果改为 200 条普通示范,加上 50 条针对失败场景的恢复示范,成功率就提高到了 99%。
这揭示了一个可能性,数据采集数量只解决一部分问题,模型能力进步更取决于能否针对其薄弱环节,给出有效的训练反馈。
YC 以外,我们观察到World Engine,同样试图向市场讲述机器人数据的完整故事。规模化数据采集叠加模型后训练反馈,迅速切入头部实验室供应链。公开数据显示,该公司已服务 8 家前沿机器人实验室,月处理数据达 25 万小时,年化收入突破 1 亿美元。
最后,决定具身落地的第三个瓶颈是硬件和供应链。
比如,电机、减速器、力传感器、夹爪、电池等等,都决定了机器人能否稳定、低成本地执行任务。尤其在灵巧操作中,即使模型能够预测正确动作,如果传感器无法感知接触、执行器无法精确控制力量,最终的操作能力仍然受到限制。这意味着机器人产业可能需要一批专门的硬件和零部件公司,而不只是更多基础模型公司。
围绕 3 个基础问题,我们观察到如下公司。
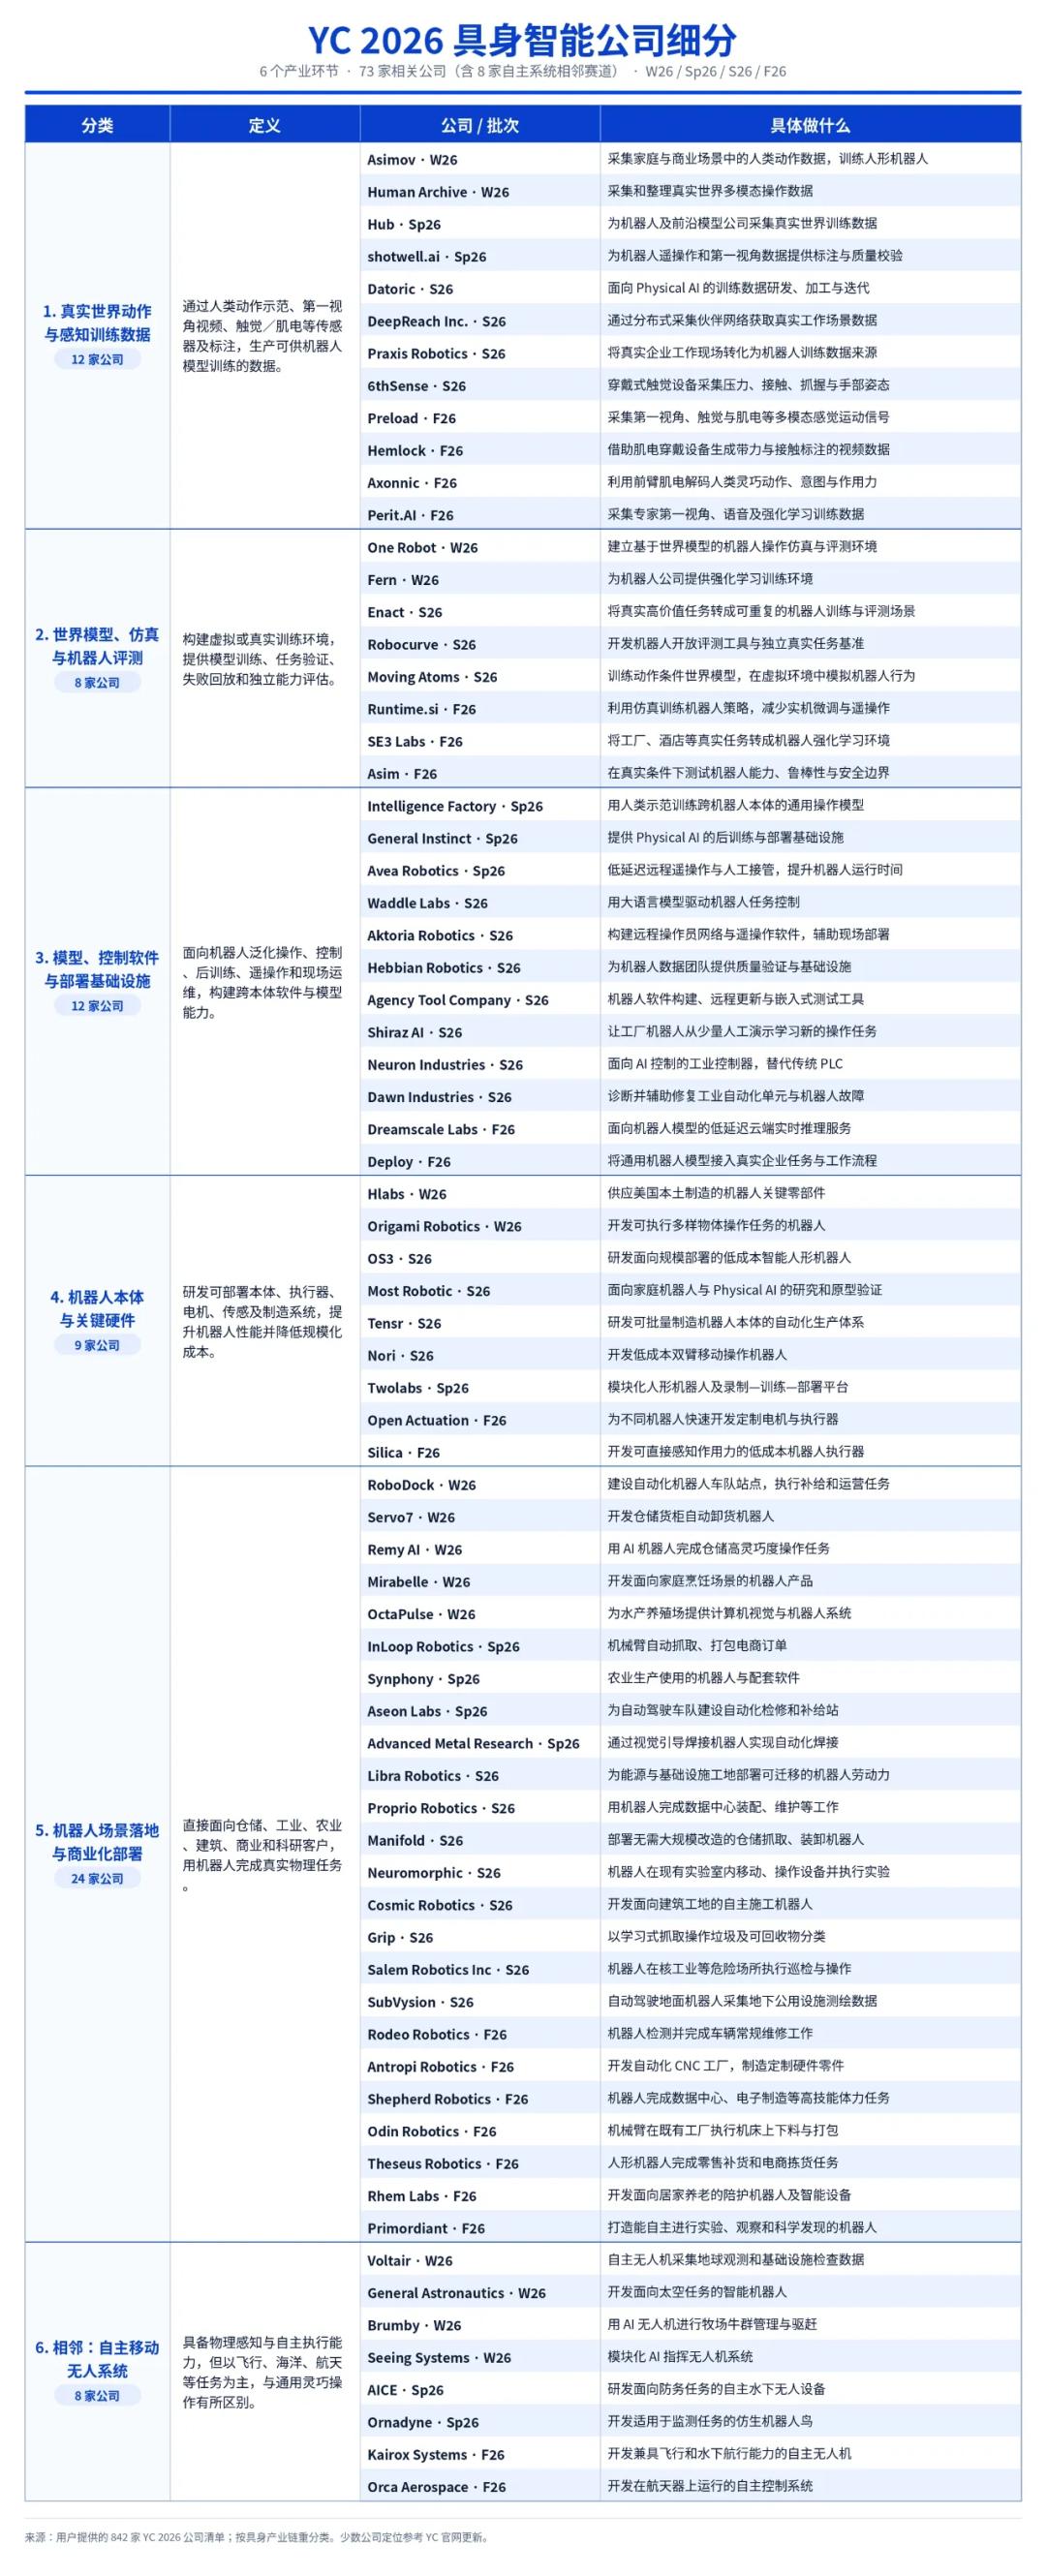
数据来源:YC
4. 万亿美元投资,算力基建逐渐兑现
美国市场对数据中心的饥渴,令 YC 这样的早期孵化器也 fomo,从另辟蹊径建造新数据中心,到软件加速数据中心建设,再到数据中心产业链,YC 均有所布局。
Compute at Sea 是一个比较激进但也非常能反映产业变化的方向。
数据中心的扩张正在受到电力、土地、审批和散热条件的限制。在一些地区,算力需求虽然存在,但电网接入和建设许可需要等待多年。
海上算力是近期集中出现的一个路径,海上可以提供独立的供电和散热,也可能通过标准化平台实现批量建设。
Atomarine 建立海上浮动数据中心,并通过船舶搭载的能源系统独立供电。长期路线是小型模块化核反应堆,但早期计划先采用天然气发电验证部署模式。11 月完成 $19M 种子轮。
Aikido Technologies 则是将海上风力发电、储能和模块化数据中心结合,计划在一个海上平台上集成超过 10MW 的计算负载。
另一个路径是太空算力,背后的逻辑是类似的。
Starcloud 专门开发轨道数据中心。25 年 11 月,它成功将搭载 NVIDIA H100 的卫星送入太空,并完成早期模型训练与推理验证。该公司一共融了 $420M,估值达到了 $2.3B。
Google 也在 10 月完成首颗 TPU 实验卫星的发射,并实现了早期在轨模型推理。
不过,太空算力短期的商业模式并不是把 AI 任务搬到轨道上,而是优先为卫星提供在轨计算能力。例如,遥感卫星可以直接在轨道上处理影像,只把分析结果传回地球,减少数据传输和等待时间。
无论是海上还是太空,这些仍然需要经过时间检验,回归到最落地的方案,传统数据中心扩展的瓶颈,还有大型电力变压器、断路器和液冷系统等。
Madrone 开发更高效的数据中心冷却系统,尝试降低冷却环节消耗的电力和水资源,并通过模块化设计缩短安装时间。
Talos 从关键电力设备的可靠性切入,为变压器等设备安装监测传感器,通过机器学习识别潜在故障,试图减少意外停机。
能很好解决电力瓶颈的公司,甚至可以反向切入数据中心业务,YC 22 年孵化的 Posh,由华裔教授创建,从智能储能与能源管理起步,抓住了 AI 数据中心快速扩张带来的电力需求,将业务拓展至分布式数据中心开发,通过整合现有电力设施、现场发电与储能系统,加速算力基础设施落地。
在数据中心供应链这个环节,很多关键的供应商都在国内,因此这里也有美国的高端制造业回流、供应链安全的推动力在里面。
总的来说,如果将算力定义为AI时代的石油,那在长期的竞争中,除了核心的 GPU 以外,还取决于能以多低的成本完成有效推理、以多快的速度交付可用算力,以及能否掌握支撑持续扩张的关键基础设施。
以下公司,可以关注。
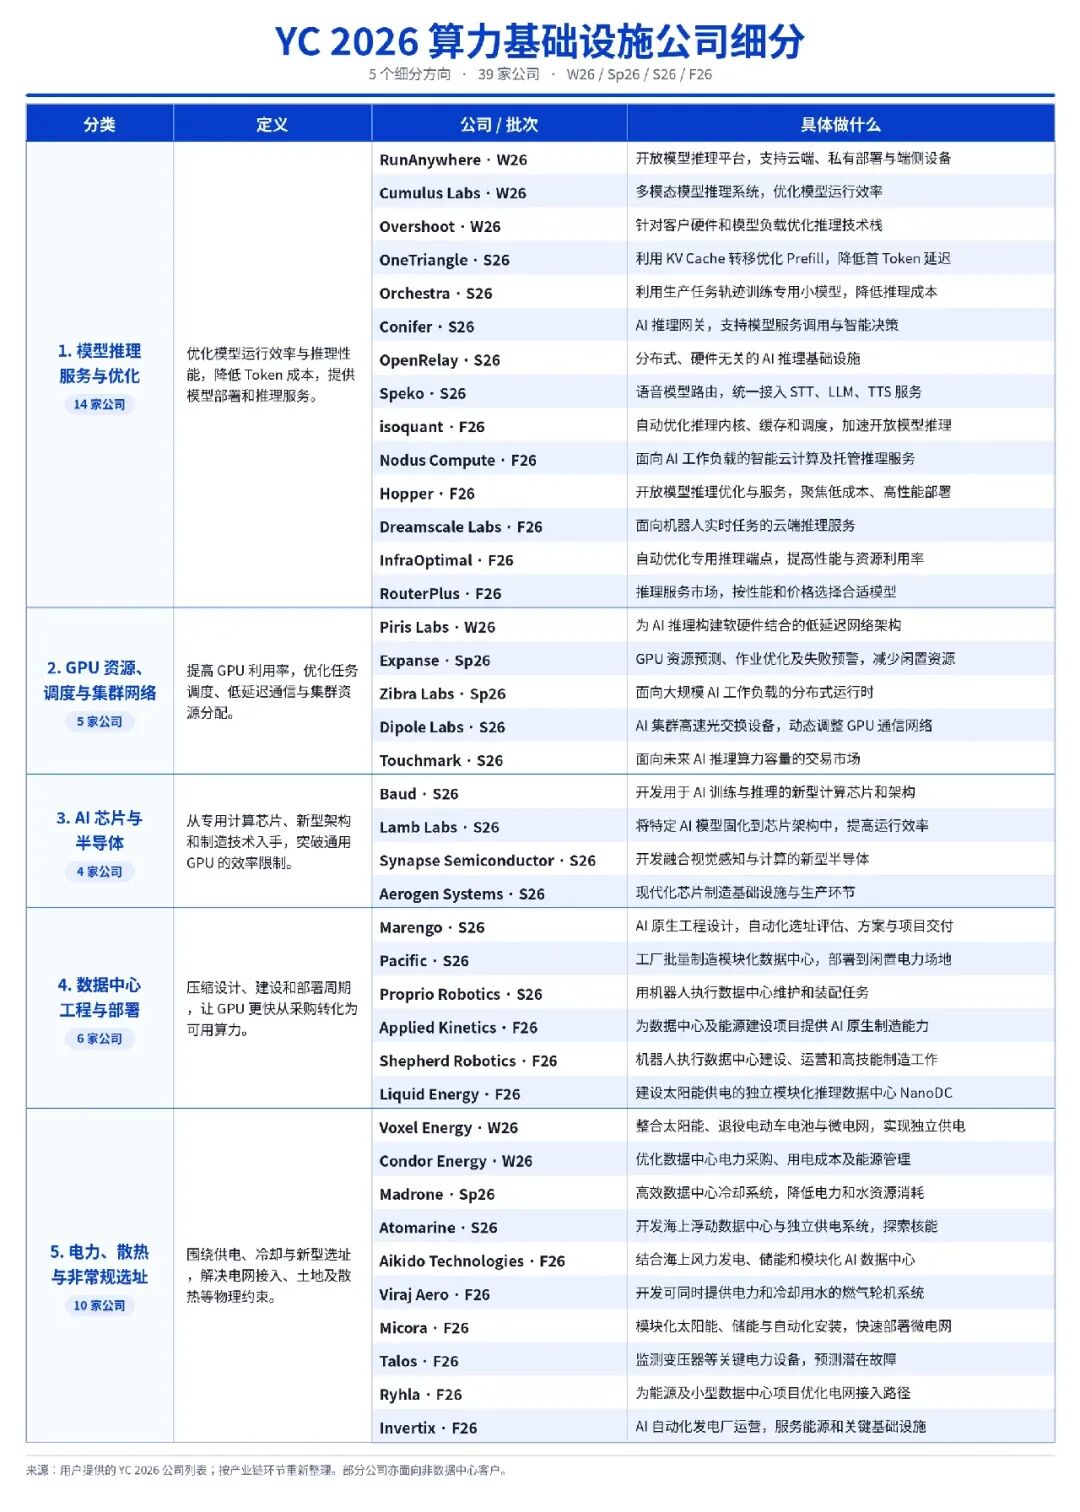
数据来源:YC
梳理完以上公司,我们明显感觉到 AI 创业正在变得更具体。模型能力提升之后,机会出现在连接业务系统、交付专业数据、稳定可靠执行和实体建设等环节。
拿到大额融资的案例,也让行业经验、团队积累和收入验证的价值更加清楚。
四条主线仍会随着技术发展继续变化,但对创业者而言,一个值得持续追问的问题是,AI 已经能做到的事情,距离客户愿意长期付钱使用,还差哪一步?这一步,可能就是下一家公司的起点。
 简体中文
 English