


在道格拉斯·亚当斯的科幻小说《银河系漫游指南》中,超级计算机“深思”耗费 750万年,终于算出了“生命、宇宙以及一切的终极答案”:42。这是人类对机器解答能力的一种浪漫想象。
近期,前沿 AI 开始在一些定义明确、长期未解决的开放问题上取得突破。在数学领域,有研究报告称解决了纳维尔斯托克斯千禧年难题和准黎曼猜想;在计算机科学领域,有研究反驳了指数时间假设;在物理学领域,则有研究给出了量子色动力学存在性的证明,并在宇宙弦引力辐射方面取得了新成果。
这些进展引发了学术界的担忧。正如陶哲轩所说,一些“优质且富有成果潜力的开放问题”正在以一种“不可再生的方式被不断挖掘”。当 AI 加速推进既定问题的求解,如何发现新的研究问题、判断哪些方向值得投入,便显得愈发重要。毕竟,能够提出的问题很多,真正值得深入探索的却少得多。
那么,AI 能否进一步参与发现问题,甚至提出人类专家认为值得研究的新方向?
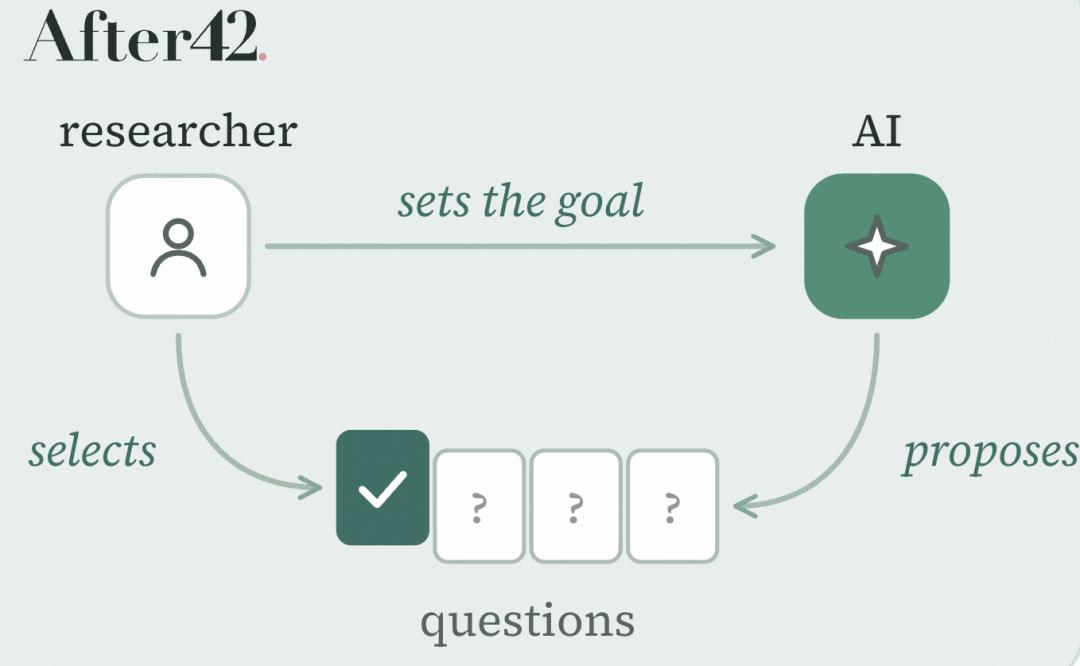
在这项工作中,斯坦福大学 Percy Liang 教授团队及其合作者推出了 After42,尝试让 AI 提出人类专家认为值得研究的研究问题。
他们没有让模型一次性生成所谓值得研究的问题,而是让它从研究人员给出的相对宽泛的目标出发,阅读相关文献,提出大量候选问题,再通过检索、尝试求解、批评和改写,逐步筛选出更成熟的方向。
论文链接:https://after42.org/research/can-ai-propose-interesting-research-questions/
After42 的核心思路是,好的研究问题往往需要在探索过程中逐步形成。研究人员会在证明、计算或实验过程中发现原先的问题不够准确,甚至意识到真正值得研究的现象存在于另一个方向。因此,After42 将尝试求解纳入问题生成流程,让模型在探索问题的过程中不断检验和修正最初的设想。
具体而言,系统首先建立研究资料包,涵盖文献综述、相关论文、已有研究成果和开放问题。在此基础上,多个 Agent 协同提出候选问题,系统再检查问题是否与已有研究重复、是否已经得到解决,以及是否存在难以修复的表述缺陷。
通过初步筛选的问题将进入多轮迭代。 Solver Agent 尝试寻找证明思路、构造反例或发现可计算的结构,其他Agent则根据求解过程中获得的反馈修改问题。模型评审器负责初步比较修改前后的版本,另一个检查 Agent 则进一步核实问题是否已有答案、定义是否清晰,以及相关判断是否缺乏依据。
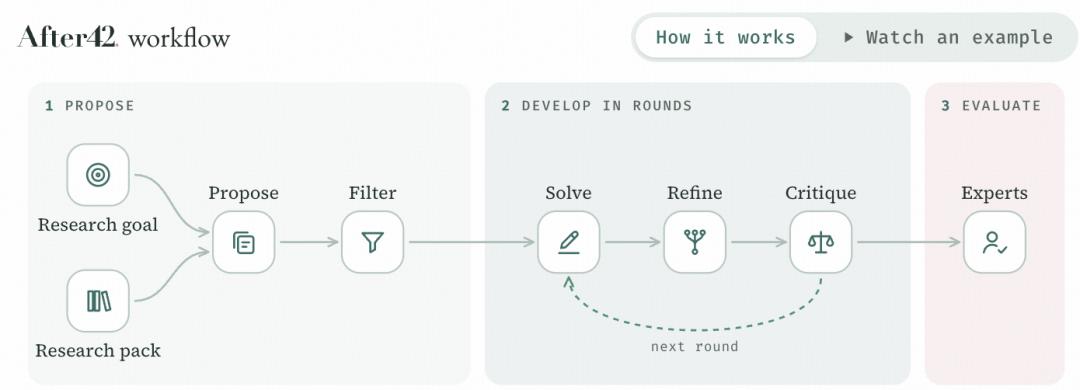
图|After42 的工作流
在构建模型前,大多数提案都通过了新颖性和难度检查,但专家认为只有 3% 的提案是值得研究的。
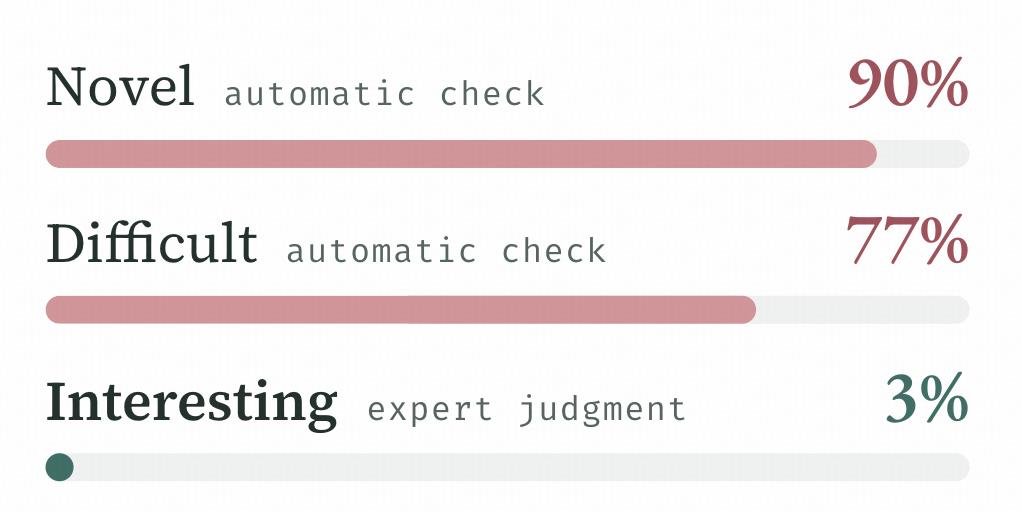
图|构建模型前的提案专家评价
在数学、统计学、理论计算机科学和物理学的五个子领域中,29 名专家对系统生成的 135 个最终问题进行了评估。其中,45 个问题被认为有趣且值得继续研究,占比约 33%,较初始提案阶段的 3% 有明显提升。
不过,不同领域的评估结果差异明显。随机结构相变方向有 33 个问题获认可,占比 47%;在线算法方向有 4 个问题获认可,占 12 个问题的 33%;黑洞振铃方向有 3 个问题获认可,占 8 个问题的 38%;统计学方向则有 5 个问题获认可,占 35 个问题的 14%。等离子体物理方向没有问题获得专家认可。
在随机结构相变方向,研究团队还进一步比较了初始提案与经过多轮开发后的最终问题。结果显示,初始提案中仅约 3% 获得专家认可,经过迭代开发后,这一比例提高至约 33%。
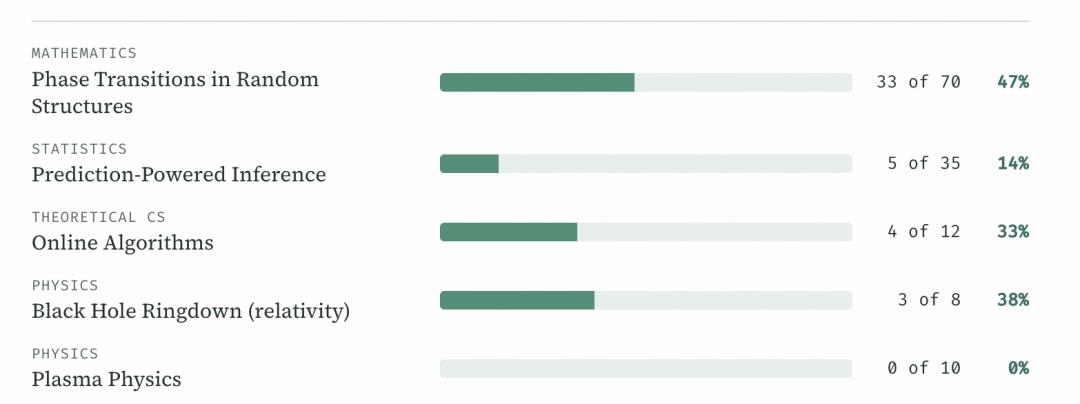
图|各子领域专家评估表现
但是,大多数问题都建立在已有研究之上。研究团队将简单组合定义为,直接基于已有工作提出问题,例如重新组合或修改既有研究中的元素,或在已知对象上向前推进一步。在数学领域,70个最终问题里有61个都属于这一类。当然,组合已有成果也能产生有价值的问题,其中一些现有研究的延伸还获得了专家认可。
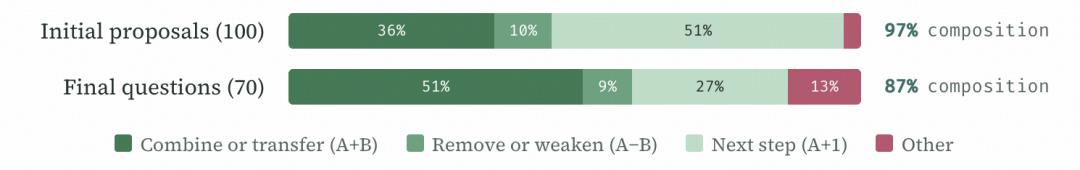
图|数学领域,AI 提出的最终问题仍然高度依赖已有研究
研究团队还发现,模型的作用并不只是润色文字。某个问题最初研究近似最优路径的配分函数,模型在尝试求解后发现,关键结构可能来自最优路径附近的一组低成本绕行。问题随后被改写为,研究这些局部结构是否构成泊松过程,以及所有近似最优路径是否能够由它们组合而成。也就是说,模型没有停留在原问题的表面形式,而是通过求解过程定位了可能真正控制系统行为的局部结构。
在另一个案例中,模型最初试图从大型连通分量中寻找几何随机图与 Erdős–Rényi 随机图之间的差异。进一步分析后,系统发现三角形等局部结构可能更关键,于是把问题改写为,加入少量随机三角形后能否用 Erdős–Rényi 图近似几何随机图。这一步把问题从“比较两类图的整体差异”,收缩成了“少量局部结构是否足以解释差异”,研究对象因此更具体,也更容易验证。
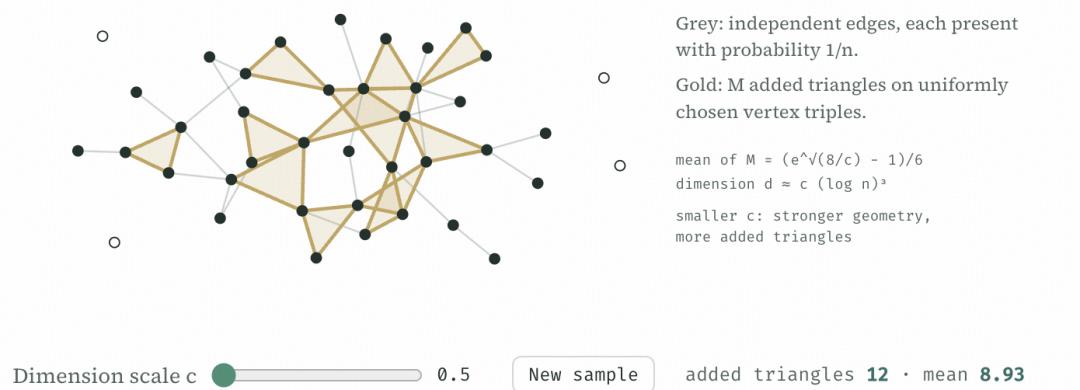
图|几何随机图与 Erdős–Rényi 随机图的比较示意
研究人员还测试了AI 是否能判断哪些问题最值得关注。四个模型与九名专家分别对一批问题进行排序。模型选出的名单与专家共识具有一定一致性,但很难选出只受到个别专家重视的问题。即使提供某位研究者的背景信息,模型的排序也只能有限地接近个人偏好。这说明,AI 可以帮助研究人员扩大搜索范围、筛选候选方向,并在尝试求解的过程中暴露问题的薄弱之处。但它还不能替代研究者对问题价值的判断。
当然,这项研究仍存在一些局限性。首先,After42 展示的能力反映了截至 2026 年 9 月的模型水平,随着模型迭代,相关结果可能很快发生变化。其次,目前缺乏可靠的自动化工具来评估研究问题是否值得研究,因此研究主要依赖有限数量的专家进行判断,评估范围也相对有限。
此外,专家认为一个问题有趣且值得研究,只能作为判断其潜在价值的早期参考,尚不足以证明它最终能够产生重要成果。过度依赖现有专家的判断和研究共识,也可能使一些尚未受到广泛关注的重要方向被忽略。
在研究方法上,After42 目前主要依赖已有文献和研究人员设定的目标,尚未将新的数据、模拟或实验结果纳入问题开发流程,现阶段的试点也仅覆盖理论研究领域。未来,研究团队还需要引入更多经验证据,并将这一方法拓展至实验科学,以进一步检验其适用范围和实际价值。
目前,研究团队已将 After42 中经过专家评估的问题公开发布,并将持续维护这一开放资源,供科研社区讨论、完善和深入探索这些问题,从而推动 AI 逐步融入科研实践。




 简体中文
 English