


训练一个5000亿参数的大模型,需要多少人?
AI行业的经验是,至少几十人,大厂动辄投入数百人。
但硅谷一家叫Mirendil的初创公司,把这个数字压缩到了极致——只要一个人。
就在刚刚,Mirendil在官网发了一篇文章,标题非常耸人听闻:《无需预训练团队的大规模预训练》。
文章标题下面列着三个数字:
1名研究员、三个半月、成本不到1000万美元。
这些钱涵盖了Agent的token消耗、数据处理和全部研究实验成本。只靠这些投入,他们真的把千亿参数的模型训出来了:Mirendil-Base,一个1000亿到 5000亿参数区间的编码专用基座模型。
Mirendil在文章中称,新模型超过99%的代码不是人写的,而是Agent写的。
人类研究员只需要负责确定方向、下判断,在关键节点踩刹车。写代码、跑实验、错误排查之类的活儿,全交给了Agent。
在Mirendil的测试中,新模型的部分指标已经逼近了
“单人手搓基模”的时代,真的要到来了……吗?
01
按照官方说法,Mirendil-Base是Mirendil系列模型的首发产品,定位是编码专用基座模型,目标用户是前沿AI实验室内部的研究员和工程师。
为了验证一个人究竟能不能把模型做出来,Mirendil设置了许多苛刻条件。比如,不能用现成的预训练框架,也不能继承代码。
研究员和Agent从零起步,在100多天里搭建了一切——训练基础设施、模型架构、训练算法、数据管道,全是自己写的,只是在PyTorch、JAX这几个通用库上,参考了一些热门开源项目当样板。
当然,这里的“自己”,通常指的是Agent。
研究员主要负责决定尝试什么、信任什么,并在需要时干预。写代码、跑实验、诊断报错这些具体的动作,基本都是Agent自己跑。
数据方面,Mirendil全部使用公开数据,比如GitHub开源代码、公开网页、公开数据集之类。公司强调,训练过程中没买过一行数据,没做过蒸馏,也没用合成数据。
此外,Mirendil希望通过改进设计提升效率。“我们通过改进的架构、数据混合的高级调优,以及其他数据层面的改进,还有kernel优化,获得了显著的效率提升。”公告称。
最终成品是Mirendil-Base,参数为1000 亿~5000 亿。
一个人做出来的千亿参数模型,到底是个什么水平?
Mirendil拿了五款模型做对比,分别是
在新代码仓库的交叉熵测试(模型猜测代码怎么写的,分数越低、猜得越准)中,几款模型的比拼结果如下:
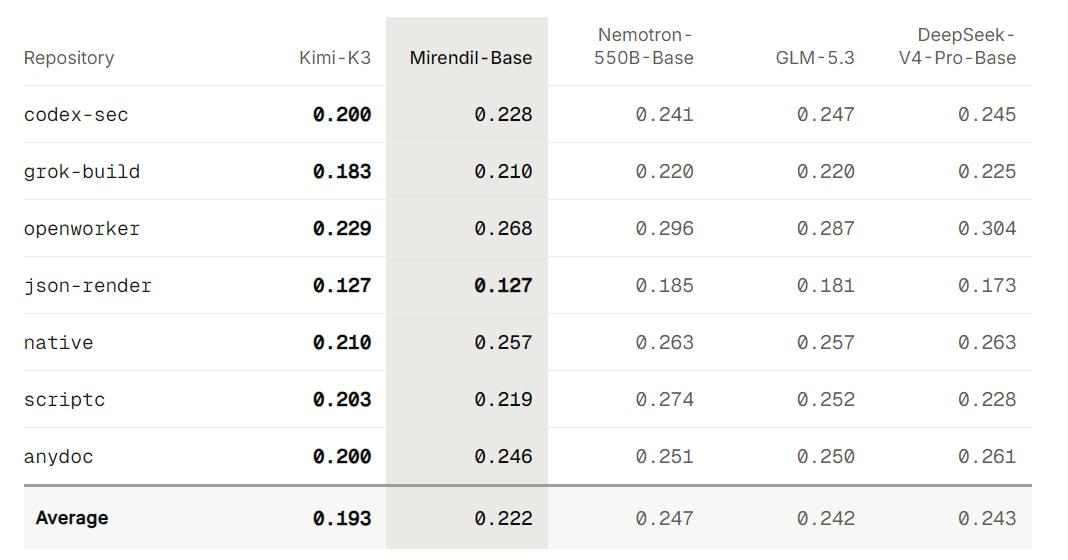
换句话说,在部分编码维度上,一个人和Agent组队训练出来的预训练模型,已经能跟头部大厂的成品模型掰手腕了。
不过,必须指出的是,通常情况下,基座模型在交叉熵测试中比后训练模型表现更好。Mirendil-Base作为基座模型,分数反而比后训练过的
根据官方介绍,Mirendil-Base往上还有两档:Large在5000亿到2万亿,XL直接冲到2万亿到10万亿。
目前,Large训练了80%,XL刚开了个头,才19%,却已经快追上Large现在的分数了。
也就是说,在钞能力和Agent的加持下,一个人训练万亿模型不是梦——这是许多AI大厂都还没摸到的门槛。
02
千亿乃至万亿参数大模型的预训练,极为耗钱、费时,还必须大量堆人。
几百位研究员里面,一部分研究模型该长什么样、怎么做scaling;一部分人管数万亿token 的清洗和配比;还有一部分人守着几千张,甚至几十万张算力卡,保证训练不停机。
AI大厂可以聚拢足够多的人才,但资金和算力成本压力依然很大。
整个行业一直在尝试降本,核心思路就是一条:让AI来训练AI。
比如,Anthropic已经沿着这条路走了很远。
它此前披露,今年5月,其代码库里超过80%的合并代码是Claude写的。
谷歌也在做类似的事情:AI编程智能体AlphaEvolve,已经被用来优化数据中心调度、芯片设计和AI训练流程。
但“AI训练AI”这条路,目前只有大厂才能玩得转。
科学家、研究员、小团队等,想自己训练一个模型,以前几乎不可能。
Mirendil-Base却证明了,在一定条件下,一个人也可以“手搓”模型。
Mirendil在官网文章中称,直到不久前,预训练一个有竞争力模型的瓶颈还是人:一支需要多年才能搭建起来的专家团队。
如今,这一局面正在改变。
过去只有大型研究机构才能做到的事,现在一名研究员就可以完成。当Agent承担了大部分动手工作时,瓶颈转移到了算力、数据,以及指挥Agent的那个人的判断力上。
“人人都能训练模型”,蕴含着巨大的想象空间。
以前,大多数人和公司如果需要专属模型,往往租用一个通用模型、再在边缘做适配。
现在,一支芯片设计团队、一个机器人实验室,或是一家医院,都可以用自己的数据、为自己的问题训练一个模型。基座模型以及围绕它们构建的系统,将不再是只有少数大厂才能制造的东西,而会更加普及。
另一方面,过去需要一个大型团队才能启动的AI项目,现在可以从小团队,甚至一个人起步;而随着算力越来越便宜、越来越强大,更多人能够去尝试这些项目。“一人公司”或者“超级个体”,有望变成现实。
人们的工作方式也会被改变:随着越来越多的工作被交给Agent,人类的日常工作将越来越不像“亲手做事情”,而越来越像“带领一个小型实验室”:设定研究方向、设计值得运行的实验、判断哪些想法值得继续推进。
Mirendil描绘了更加炫目的前景:下一个模型将部分由Mirendil自己的模型来构建,而每一个在构建 AI这件事上变得更强的模型,都会让下一个模型的构建更便宜、更快速。
“我们认为,还没有达到完全自主的RSI,但我们已经比以往更接近了。”公司称。
此外,公司已经开始对Mirendil-Base进行后训练。Mirendil-Base-Large以及达到前沿水平的Mirendil-Base-XL仍在训练中。
03
Mirendil的背后,是两位Anthropic前员工:Behnam Neyshabur和Harsh Mehta。
Neyshabur是80后,伊朗出生、读大学。2011 年去了美国,在丰田工业大学芝加哥分校拿了博士学位。毕业后,他在谷歌DeepMind干了5年,2024年底加入Anthropic,领导了Discovery团队,专门研究怎么让AI像科学家一样参与研发。
Mehta是印度裔,印度理工学院古瓦哈提分校毕业的,在DeepMind的时候跟Neyshabur是同事。加入Anthropic之后,Mehta搭建了Anthropic内部自动化AI研究平台的第一个版本。
2025年12月,两人前后脚离职,成立了Mirendil,公司定位是让AI来帮助科学家造出他们自己的AI,而不只是直接用AI辅助科学。
换句话说,他们希望让科研团队能够自己训练、迭代专属AI模型,不用再仰仗大厂的通用模型。背后的技术路线,就是最近AI圈内炒得很热的RSI。
今年6月,Mirendil官宣了 2 亿美元种子轮融资,投后估值 10 亿美元。投资方包括a16z、凯鹏华盈、英伟达等。
团队目前约 20 人,都是从Anthropic、xAI、Google DeepMind、OpenAI 出来的研究员和工程师,在旧金山市中心办公。
Mirendil-Base的亮相,标志着公司跨过了第一个里程碑。
但话说回来,“单人训练千亿参数模型”听起来美好,门槛并没有被拉低多少。
1000万美元的成本,对大厂来说不算什么,刚刚拿到融资的Mirendil也还付得起。但对于绝大多数个人、小团队来说,依然是天文数字。
更别说,能指挥 Agent整出如此大活儿,不是随便拉一个工程师就能上手的。Mirendil的人才质量之高、AI项目经验之丰富,在整个硅谷都处于第一梯队。
“一人手搓大模型”的时代确实在靠近,但离普通人还很远。
Mirendil-Base 的发布,是这条漫长道路的第一块路标。至于它能不能真的把大模型的门槛打下来,还得看后续更大规模模型的实际水平,以及这套方法论能不能复制到别人身上。
 简体中文
 English