


机器人在真实世界中的每一次执行,都在产生经验。如何把这些经验利用起来,一直是个难题。传统做法依靠人工纠正,由远程操作人员监控机器人执行,在策略出错时接管并给出正确动作。这种模式在几台机器人上还可以维持,但随着集群规模扩大,人工监督迟早跟不上需求的增长。
针对这一问题,清华大学、智元机器人与无问芯穹联合团队提出了集体经验学习(CEL),一种让已部署机器人共享执行经验、共同改进同一策略的学习范式。
论文链接:https://arxiv.org/abs/2610.25736
CEL 的算法实现是失败引导的经验检索微调(FERT):利用机器人执行失败时的上下文,从整个集群共享的成功经验中检索相关轨迹片段,并将其中记录的动作作为监督信号来更新策略。整个过程无需额外收集专家示范或纠正动作。人类只需为每次执行标注成功或失败并重置环境,动作本身全部由机器人提供。
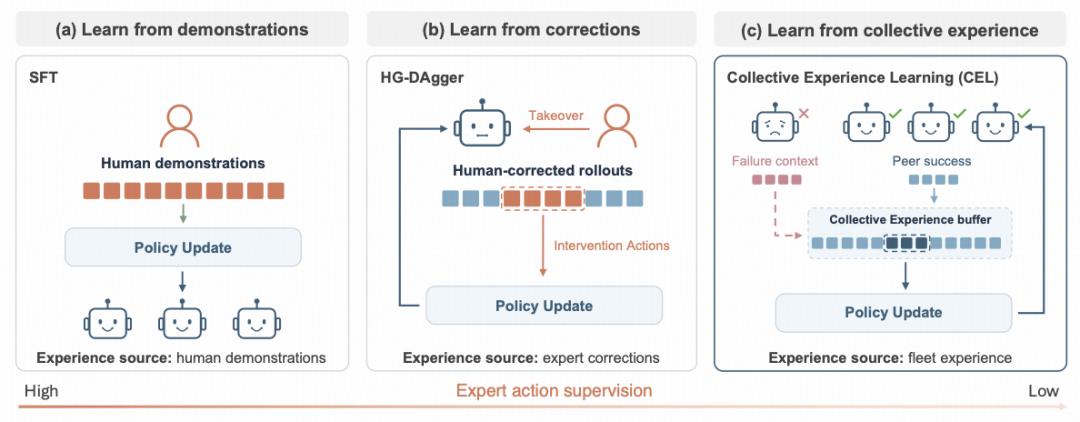
图|机器人策略学习的三种经验来源:人类演示、专家纠正与集群集体经验
为支撑大规模集群上的持续学习,团队还构建了容错异步训练系统(FATS)。这样,即使集群中的个别机器人因故障、重置或维护而工作中断,经验采集、策略优化与策略分发仍能持续进行。
在手机包装、插花、叠衣服等五项真实世界操作任务上,研究团队每项任务各进行了 120 次试验,参与评估的机器人均未参与训练数据采集,最终策略的成功率达到93.3% 至 99.2%。在固定每台机器人采集时长,仅增加机器人数量时,集群越大、经验越多,FERT 的成绩总体也越好。在多阶段手机包装任务中,使用 96 台机器人进行学习后,任务成功率从 79.2% 提升至 98.3%。
这些结果表明,集体经验可以成为一种可行的可扩展机器人学习基础:随着部署规模扩大,经验供给同步增长,而无需专家监督随之同比例扩张。这为机器人在部署过程中持续提高策略可靠性提供了一条路径。
一、研究方法
CEL 的算法与系统实现分别是 FERT 和 FATS 。
FERT 的核心思想可以概括为一句话:成功提供模仿对象,失败决定学什么。具体流程分为以下四步:
- 第一步,异步经验采集。集群中的机器人持续自主执行任务,每条完成的轨迹标注成功或失败的二元结果。成功轨迹进入集体经验缓冲区作为学习素材;失败轨迹不提供动作,仅仅用作检索线索。这保证了系统能从失败中学习,却不会模仿失败的动作。
- 第二步,经验编码。将冻结的 VLA 视觉编码器的输出(经空间池化)与本体感知的关节状态分别归一化后拼接,形成统一的检索表示,使不同机器人之间的经验可以相互比较。
- 第三步,失败引导检索,也是该方法的关键。二元标签只能说明一条轨迹失败了,却无法定位失败发生的位置。FERT 取失败终点前约 3 秒的观测序列作为查询,通过带斜率约束的子序列动态时间规整(S-DTW),在成功经验库中找到时间对齐、状态相似的成功片段。直观理解,就是回答"在类似情境下,怎样做才能成功"。
- 第四步,优先级微调。检索命中的片段获得更高的采样优先级,反复出现的失败情境会让相关成功行为被更频繁地学习;同时优先级随时间指数衰减,保证学习始终聚焦于策略当前最容易失败的环节。策略更新采用动作块的对数似然拟合,无需价值函数、评论家或优势估计。理论上,团队证明了在成功重放与检索对齐条件下,FERT 的更新方向与提升任务成功率的目标一致,且检索加权带来一阶正贡献。
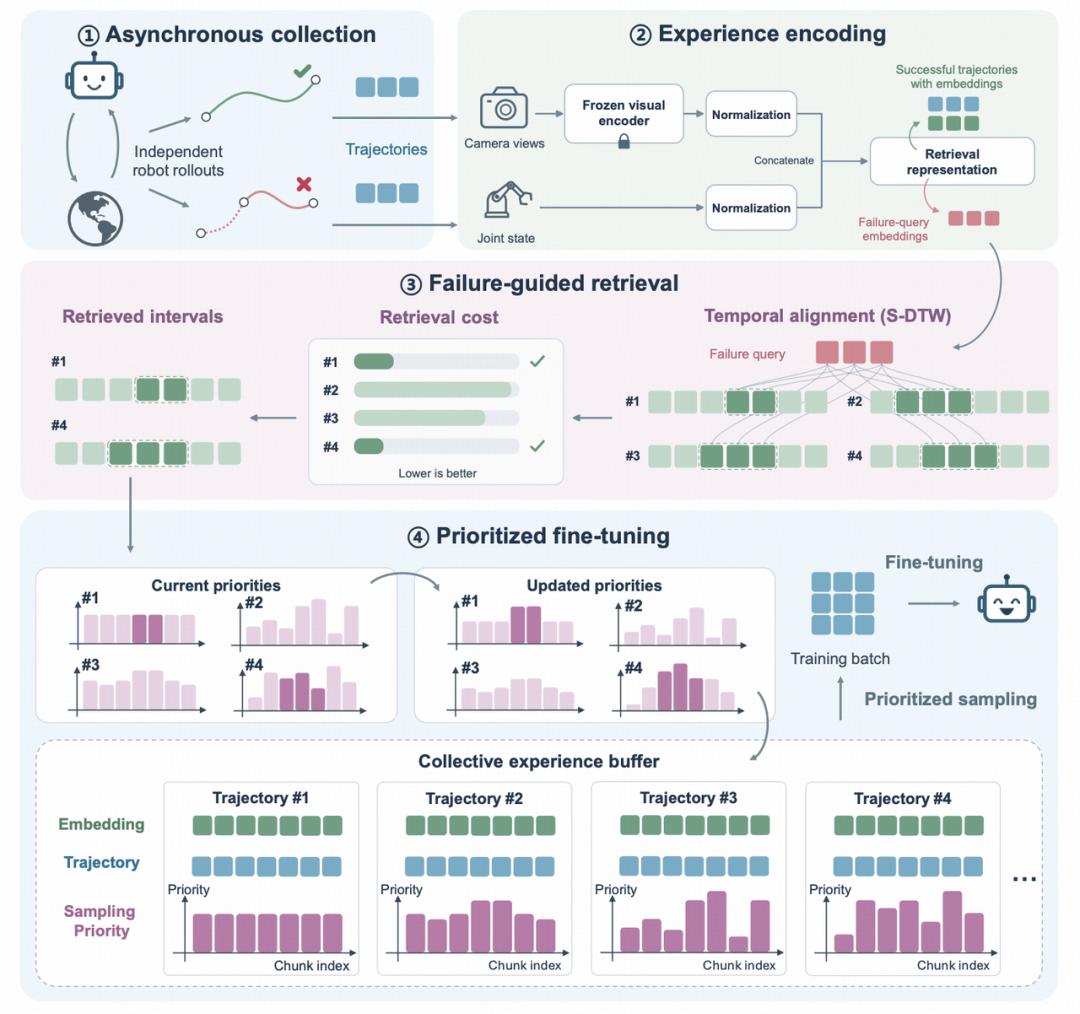
图|FERT 总体流程
要在真实集群上跑通 FERT 的这一学习循环,工程难度不亚于算法本身。团队指出两个关键特性:一是交互与经验的时序要求不同。机器人必须在下一次动作前收到推理结果(毫秒级),而训练需要的是完整回合记录(GB 级,但不必即时到达)。二是实体机器人随时可能中断。在 96 台机器人的实际运行中,平均每 22 分钟就有一台出现故障。
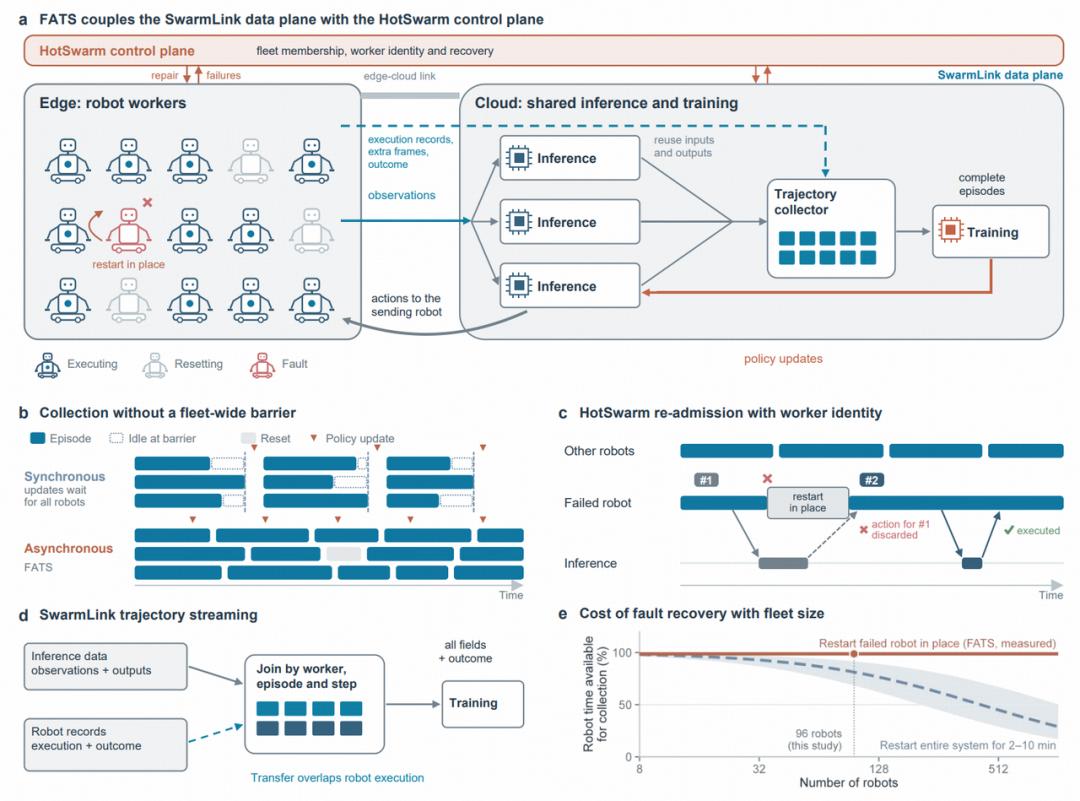
图|FATS 架构
为解决这两项难题,FATS 采用了双平面架构。
其中,数据平面 SwarmLink将机器人执行连接到共享云端推理与训练,推理请求汇入公共请求池,暂停的机器人自动让出算力;回合数据在执行过程中流式上传,已用于推理的观测在云端直接复用,避免重复传输;交互流量优先于批量训练数据。
控制平面 HotSwarm将集群建模为动态成员关系,“工位”,即绑定节点、设备与机器人的固定位置,与“工作器”,即占用工位的进程,生命周期分离,工位贯穿训练全程,工作器可随时替换。机器人故障时,系统就地重启其工作器、以新版本号重建连接、重放被中断的调用,其余机器人不受影响;为失败工作器计算的过期动作会被识别并丢弃,防止动作与观测错配的数据污染训练。恢复策略也分级设计:环境工作器随时就地重启,代价至多一个回合;训练工作器周期性存档并从最新检查点恢复,数小时积累的优化器状态得以保全。
二、实验结果
实验覆盖了五项真实桌面操作任务。插花(柔性物体)、叠衣服(可变形织物)、手机充电(插拔与精确对齐)、凳子组装(小物体与工具使用)、手机包装(多阶段放置,耗时 2-3 分钟)。硬件为双臂 AgiBot G2 机器人,基础模型为 π0。
在每项任务的最大集群规模下,多机器人 HG-DAgger 将五任务平均成功率从 SFT 的 36.3% 提升至 81.0%;FERT 在不使用任何额外专家数据的情况下,进一步将平均值提升至 97.3%,平均失败率相对降低 86.0%。其中手机充电从60.0%提升至 97.5%,失败率相对降低 93.8%;手机包装从 79.2% 提升至 98.3%。
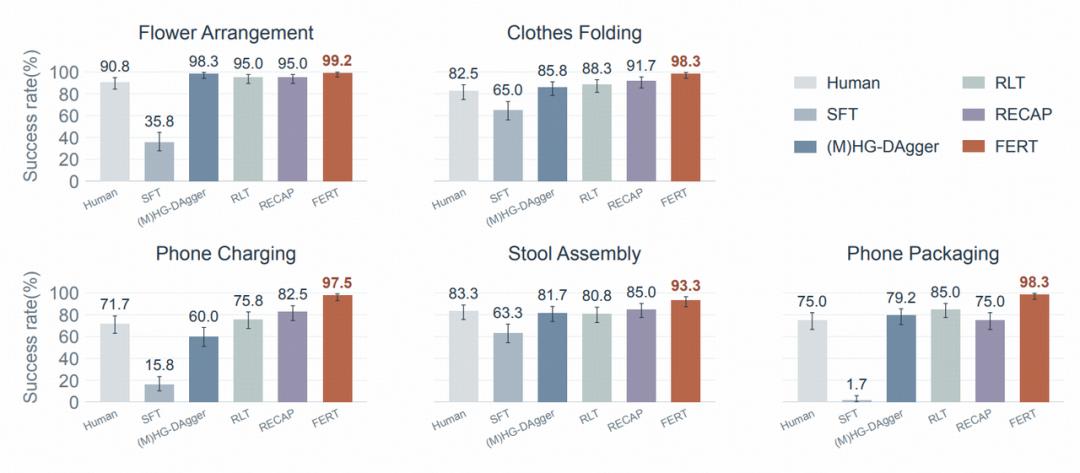
图|五个任务的主要结果
FERT 在全部五项任务上超过人类遥操作,平均高出 16.7 个百分点,手机充电上高出 25.8 个百分点;它也全面领先两个基线——单机器人在线强化学习 RLT(平均领先 12.3 个百分点)与同样使用集群数据但保留专家纠正的离线强化学习 R
固定单台机器人采集时间、仅增加机器人数量时,FERT 的成功率在五项任务上总体持续上升:手机包装任务中,训练集群从 16 台扩至 96 台,成功率从 86.7% 升至 98.3%。与之对照,依赖人工干预的 HG-DAgger 在集群扩大后出现饱和甚至回落,有限的人类监控与干预能力构成了性能上限。而 FERT 的经验供给随集群规模自然增长,“机器人越多、学得越好”的扩展曲线得以成立。需要注意的是,小集群下 FERT 也可能低于初始策略,原因在于成功经验尚不足以覆盖策略遇到的各种失败情境。
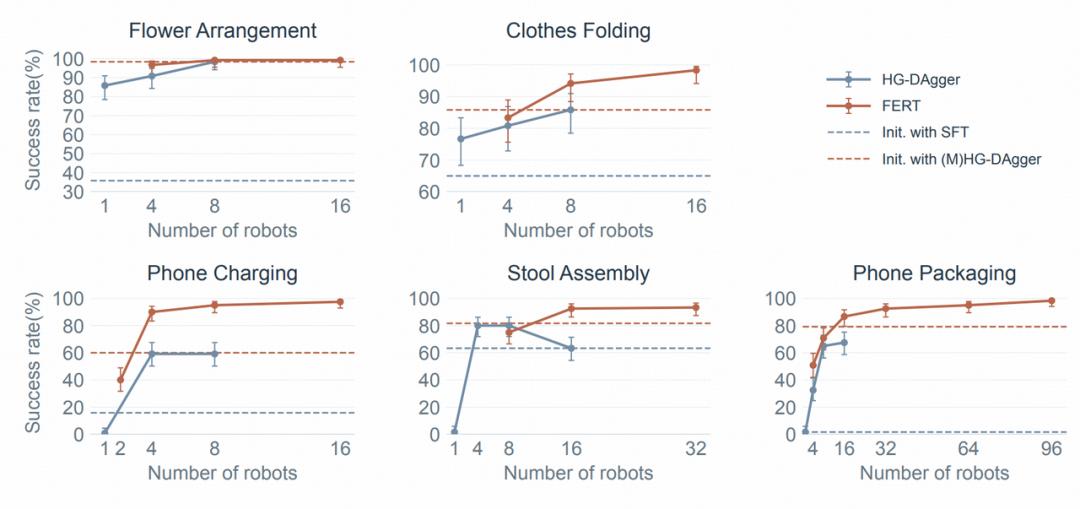
图|随集群规模扩展
最后,研究团队通过消融实验检验各设计选择的贡献。在手机包装任务(16 台训练机器人,完整配置成功率 86.7%)上的消融验证了各设计的作用。移除失败引导检索后,成功率跌至 64.2%,下降 22.5 个百分点,是所有消融项中降幅最大的一项,直接验证了"按失败情境选择经验"的价值;去掉检索片段前后的动作上下文扩展,成功率降至 57.5%,说明匹配片段前后的动作上下文对学习成功行为同样重要。策略同步频率以每 500 个优化器步最优,过疏会延迟新策略的使用,过密则每个策略版本下积累的经验不足;优先级保留因子以中等值 0.88 最优,体现了保留历史检索信息与响应最新失败之间的权衡。
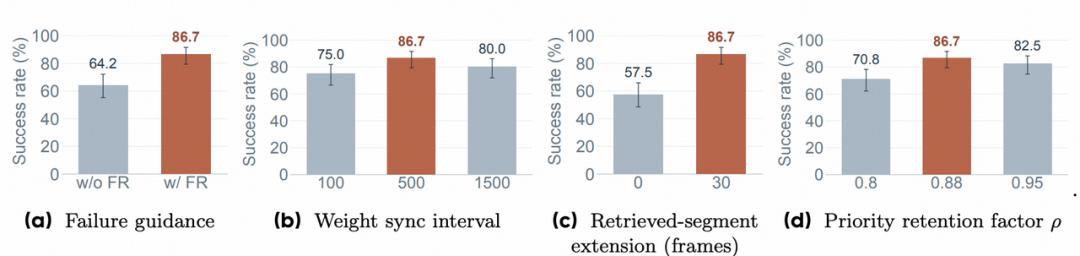
图|消融实验结果
在系统层面上,96 台机器人在近 8 小时运行中共采集 9,834 个回合,期间 30 起故障仅造成 1.3% 的机器人时间损失。作为对照,若采用同步采集,采集量只剩实测的 33%;若每次故障后整机重启 5 分钟,也只能保住 86%。容错异步设计的价值由此得到量化。
研究团队也指出,评估限于单一平台(AgiBot G2)上的五个任务专属策略。更广泛的任务分布、异构机器人平台,以及更长运行周期中适应环境变化,都留待后续工作关注。
整体来看,CEL 带来了一种新的部署逻辑。机器人集群贡献的不仅是任务执行,还有可供整个集群学习改进的经验。通过一个共享策略,单台机器人的经验可以转化为整个集群的能力。随着部署规模扩大,经验来源同步增长。从而,机器人越多,不只是产能越大,更能越学越好,而且不受专家监督供给的制约。
更多技术细节,详见原论文。
 简体中文
 English