


有意思,谷歌刚被曝跑通了RSI,一篇关于如何让AI实现自我进化的论文,就被官方发到了网上。
打开方式还挺别致,“做梦”。
对,没让大模型重新训练自己,也不是让AI直接修改自己的权重,而是Dream-RSI,直接就是一个“梦中学”。
不开玩笑,咱还是正经说,其实是研究人员们发现了一个有点妙的事情:
AI真实探索留存下的历史记录,本身就是一个模拟世界。
于是,一次昂贵的真实探索结束后,Agent不必真的重新跑上几百、几千遍实验,就可以在过去已经发生过的搜索树里,进行虚拟推演(做梦),反复试验新的搜索策略。
等找到更好的策略,再回到真实环境里跑一次。
新的探索,又会产生一棵更大的搜索树。
再拿来“做梦”。
如此循环。
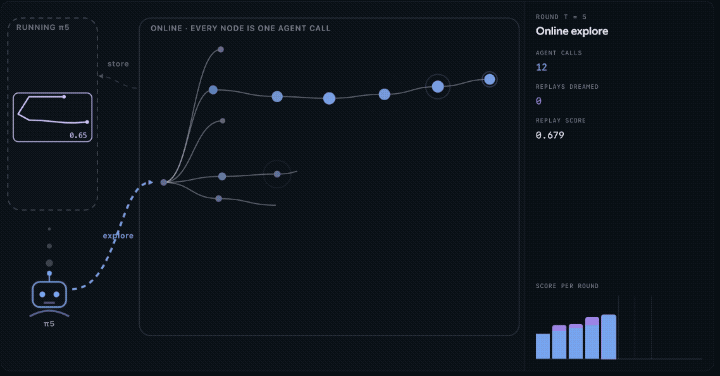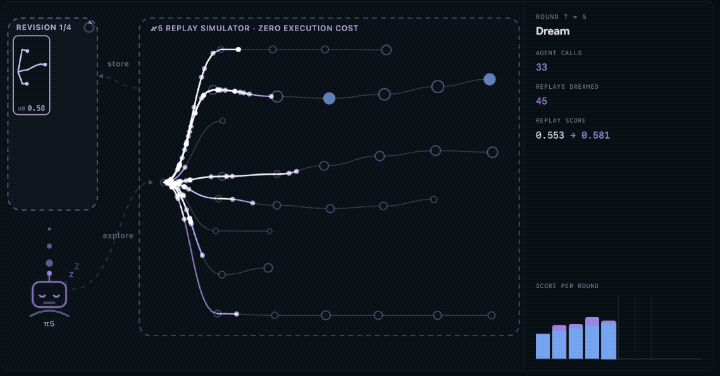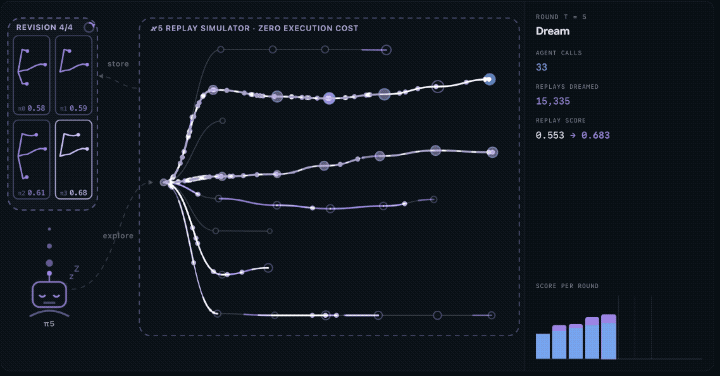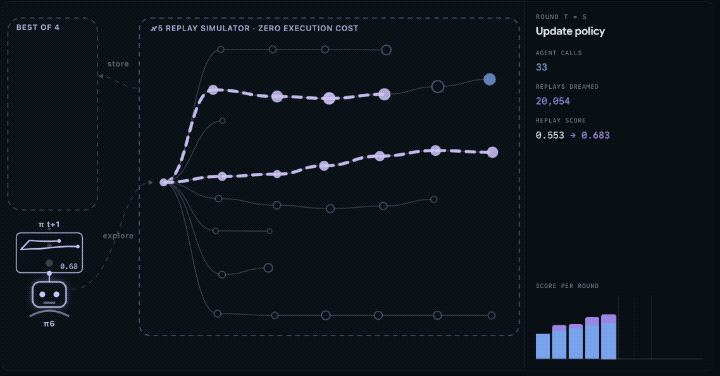
省了一大笔钱不说,这法子还真的管用。在算法工程、数学优化和GPU内核工程三类任务上,研究人员都证明,Dream‑RSI不仅能大幅降低探索的计算成本,还能达到甚至超越原有方案的发现效果。
历史就是世界
一起来细扒一下论文。
论文的核心思路可以这样总结:把AI走过的弯路,变成AI新的训练场。
谷歌的研究人员认为,RSI的核心驱动力,其实在于高效探索。因此如何管控并优化探索策略,是一个非常关键的问题。
实际上,很多AI科研系统都已经实现了一个Loop:
生成一个方案 → 跑实验 → 看结果 → 修改方案 → 再跑实验。
问题是,随着搜索空间的不断扩大,固定的探索策略无法自适应调整;而在线策略优化,又存在迭代时间长、反馈滞后、代价高等等困境。
Dream-RSI抓住了一个此前没有被充分利用的东西:历史。
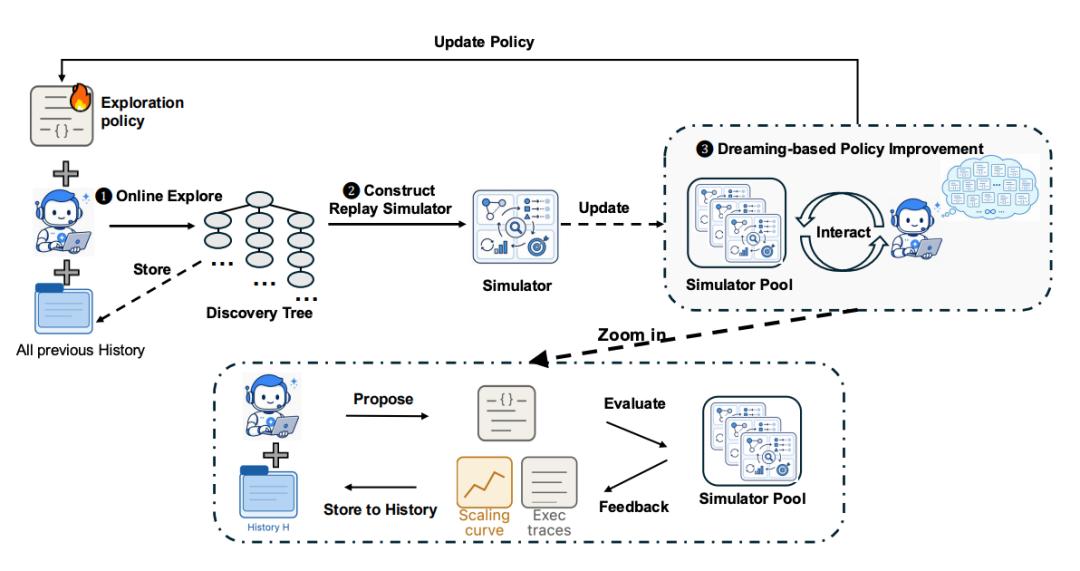
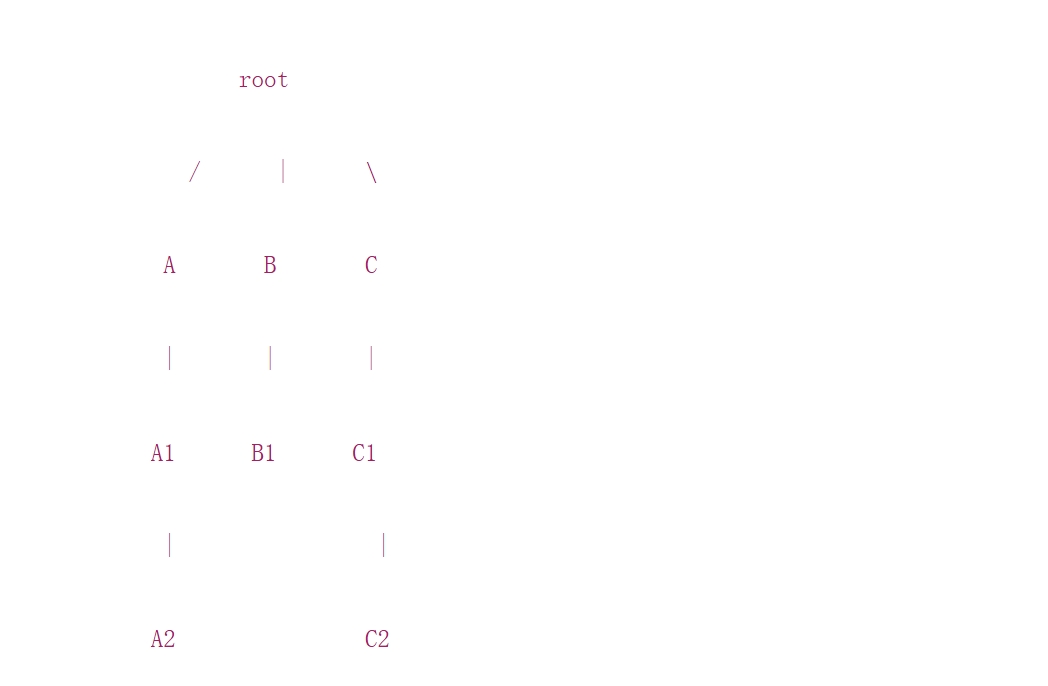
一次Agent探索任务跑下来,其实会留下非常丰富的记录,形成一棵发现树(Discovery Tree)。
be like:
谷歌的研究人员换了个视角,发现这一堆历史日志,不就是一个模拟器嘛!
举个例子,Agent首次执行的策略,是把A、B、C分支依次都跑一遍,跑完之后每个节点的结果其实都存下来了:A1得多少分、B1会不会报错、C2效果怎样、各自花了多少计算量。
现在,我们换一种搜索策略,比如:先跑C,如果C1不够好,再走A。
从头再跑一遍?大可不必,因为C、C1、A、A1这些结果都可以直接调用,只要让新策略在旧树上“重新走一遍”,就能算出,“如果当时这么做,需要花费多少计算量,能达到什么效果”。
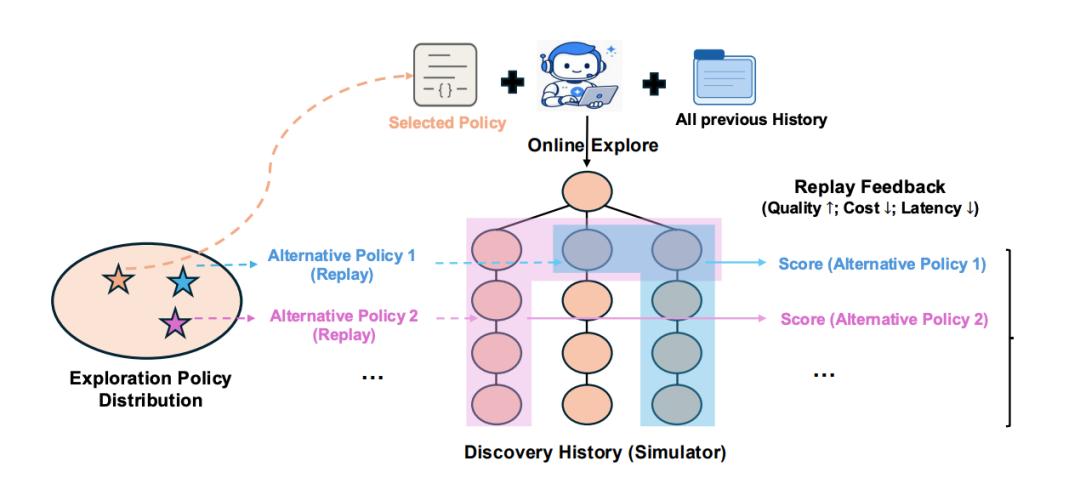
也就是说,在Agent已经探索过的区域里,历史就是世界。
只需要一次真实的执行,大量新的策略探索都能更低成本地在这个“模拟世界”中被验证。
在梦中自我进化
整个Dream-RSI系统分为三步。
第一步,真实探索。
当前探索策略控制一个Coding Agent,决定开哪些分支、继续哪些方案、跑多少个并行任务、什么时候结束。
所有过程被记录为一棵发现树。
第二步,开始做梦。
引入另一个大语言模型来负责开发探索策略。
每生成一种新的探索方案,不重新跑实验,而是在过去积累的所有发现树上“回放”结果。
最终,综合考虑答案质量、搜索成本和并行效率,找出更好的动态策略。
第三步,把赢家重新派出去。**
新策略进入真实环境,指挥下一轮探索。
由于策略已经变化,它可能会走到上一代Agent没有抵达过的位置。
这样就会产生新的发现树,继续扩大下一轮的“梦境”。
也就是:
真实探索 → 产生更多历史 → 历史变成更多模拟世界 → 在模拟世界中优化探索策略 → 更好的策略产生新的历史……
大幅降低计算成本,效果不降反增
研究团队把Dream-RSI扔到了8个发现任务里,横跨三个方向:算法工程、数学优化和GPU Kernel优化。
最直接的对照组叫Recursive Fixed Exploration。
它和Dream-RSI使用相同模型、相同Evaluator、相同初始策略和资源约束。
不同在于,一个每轮都会学习如何重新组织探索,另一个永远按照第一轮的固定策略继续搜索。
算法工程
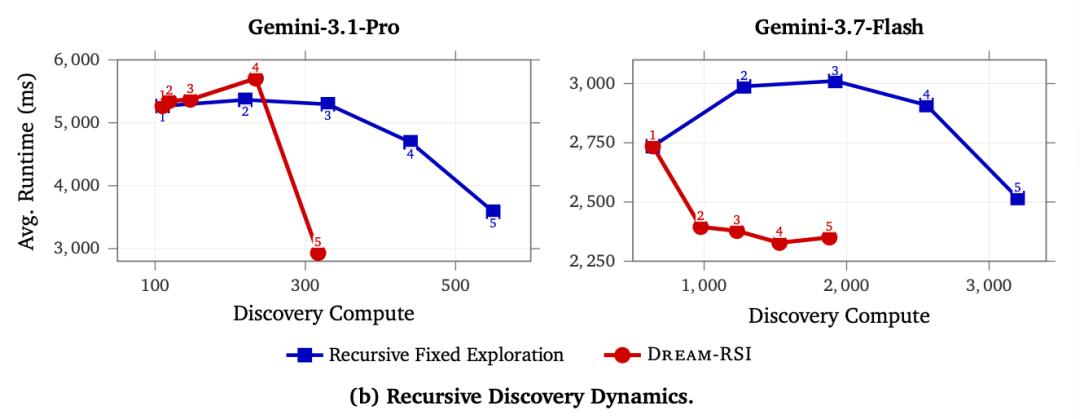
研究团队让Agent优化Lasso regularization path。
当模型为Gemini 3.1 Pro时,固定探索最终消耗550次Agent调用,六个测试数据集平均运行时间3587.1ms。
Dream-RSI则用了317次调用,最终做到2931.0ms。
换成Gemini 3.7 Flash也是类似:
固定策略用了3200次Agent调用,平均耗时2516.7ms;Dream-RSI用了1879次,耗时降到2350.6ms。
跟SimpleTES的对比结果差距更夸张。
SimpleTES对应实验预算达到51200次调用。Dream-RSI在部分设置下则只需几百次调用。
两者最高能差出去162倍。
GPU Kernel
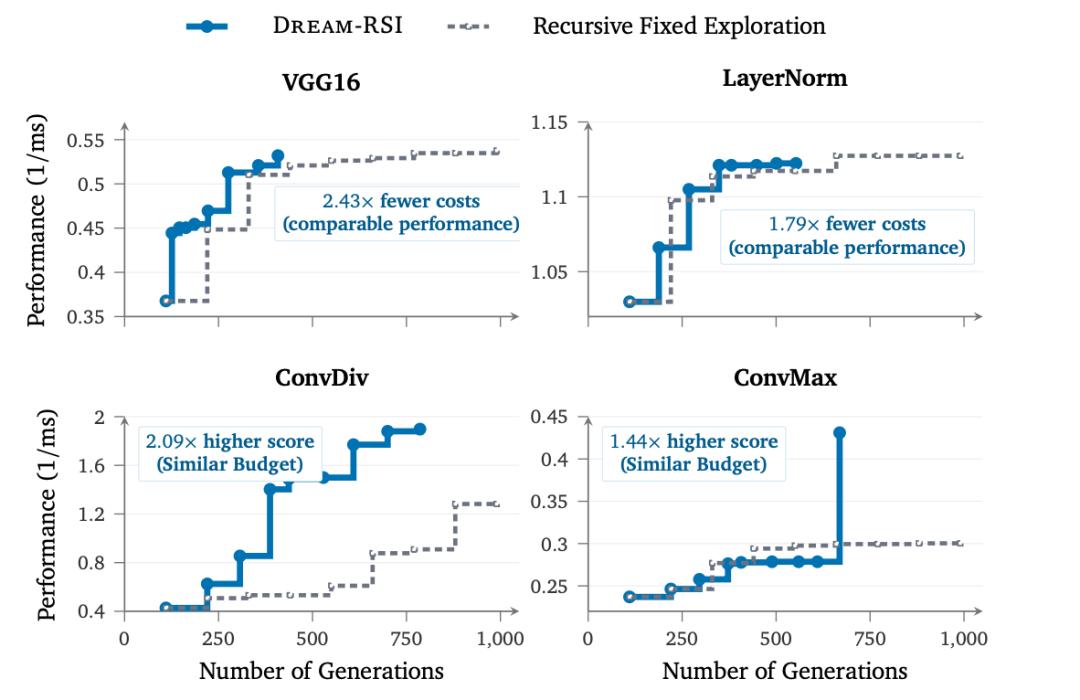
在VGG16和LayerNorm任务上,Dream-RSI分别相差2.43倍和1.79倍的生成次数,做到相近性能。
在ConvDiv和ConvMax中,则在接近的计算预算下,把性能分别提高2.09倍和1.44倍。
数学优化
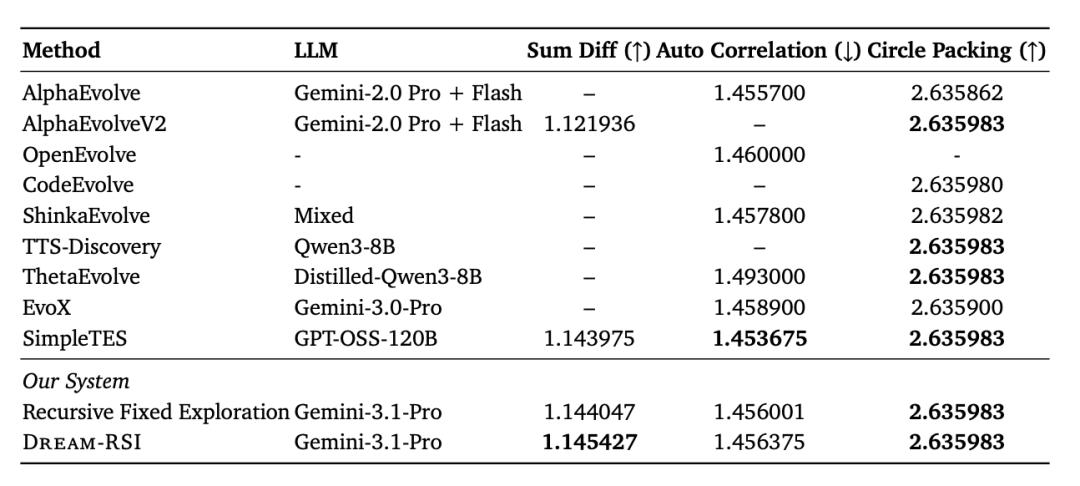
在Sum Difference上,Dream-RSI拿到1.145427,高于论文列出的多个基线;Circle Packing打到2.635983。
但Auto Correlation中,SimpleTES仍然是SOTA。不过Dream-RSI在结果相近的情况下,调用量做到了1000 vs 51200。
One More Thing
有意思的一点是,研究人员们还发现,给AI总结“经验教训”,结果反而更差了。
他们把之前探索中踩的坑直接塞进下一轮Prompt,结果万万没想到:
加了显式语义指导以后,不管是固定探索还是Dream-RSI,表现反而普遍下降了。
论文给出的解释是:
长程科研搜索往往同时存在很多并行路线。
如果过早去总结“高层结论”,就相当于提前给未来的探索加上了很强的先验。
结果可能不是少走弯路,而是直接把一些看起来没希望、实际上可能有价值的路线堵死了。
最后,做个小小的总结,实际上,在Dream-RSI的整个实验里,模型本身没有被重新训练,与其说是模型的自进化,更像是Harness的自进化。
过去我们谈Agent自进化,关注最多的是两件事:一、把成功经验写进Memory;二、把历史数据重新拿去训练模型。
Dream-RSI提供了第三条路:
模型可以不变,知识甚至不用先总结成文字,先让「寻找知识的方法」自己进化。
下一代Agent不必只从上一代留下的“答案”里学习。
而是学习:
上一代到底是怎么找到答案的,以及——有没有一种更好的找法。
论文由Google、Google DeepMind、马里兰大学和弗吉尼亚大学研究者共同完成,目前论文、项目页和代码仓库均已公开。
 简体中文
 English