


当AI智算中心从千卡走向万卡,算力竞争已不只是芯片性能的比拼,更是集群内部连接效率的较量。400G/800G高速网络规模化部署,海量网卡、交换机与光模块在机柜间密集铺开,布线系统的性能、成本与能耗,直接影响算力集群的落地效率。
AI集群的绝大多数链路集中在机柜间与同厅内,距离多在百米以内。面对这一密集而短距的连接场景,多模光纤成为数据中心厂商的首选。
多模光纤是一种纤芯直径较大、可在同一波长下同时传输多个导波模式的光纤。典型多模光纤的纤芯直径为50微米量级,而单模光纤通常在9微米左右。因纤芯较粗、折射率呈渐变分布,光便可以在同一根纤芯内以多条路径向前传输。与单模光纤只允许一个基模传输不同,多模光纤的“多”体现在同一根纤芯内多个模式并行传播。
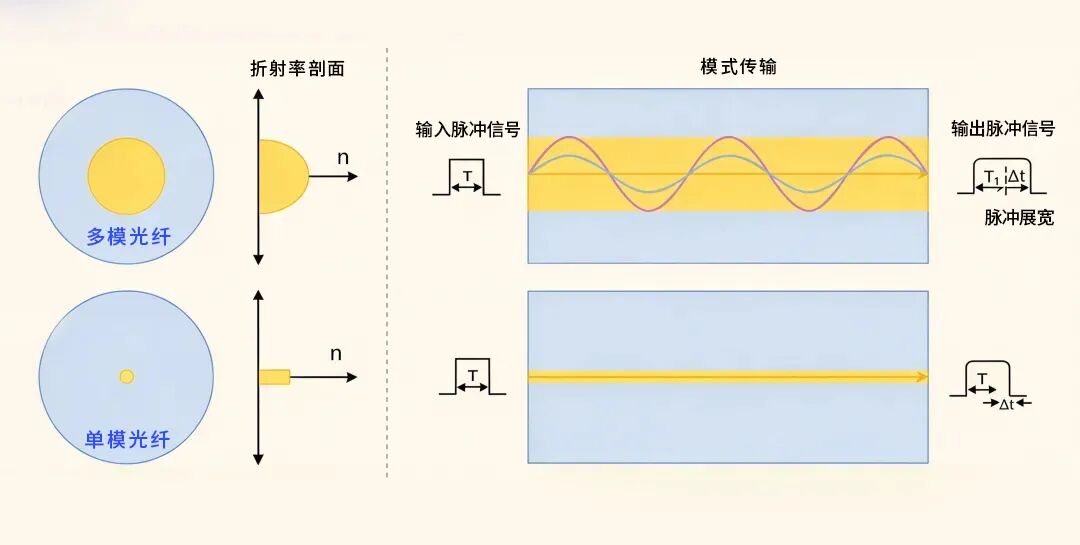
光在光纤中不同的传播结构,对光电转换的激光器芯片提出了不同的要求。多模方案与VCSEL(垂直腔面发射激光器)天然匹配,其工艺成熟、功耗较低,规模化部署既能满足容量要求,较传统单模方案又更具成本优势。同时,较大的纤芯带来更宽松的对准容差,连接器加工与现场安装难度下降,工程与运维成本进一步降低。
其代价是模式色散——不同模式的传播速度存在差异,距离越长,信号脉冲展宽越明显。因此,多模光纤的适用边界天然定位于几十米到几百米的短距互联。
AI大模型训练中,GPU之间的梯度同步与参数交换密集发生在机柜内和机柜间,集群的流量分布高度集中百米以内。这段“短距”连接数量最多,对单链路成本、功耗和安装最为敏感,恰好匹配多模光纤的特性——在短距离下实现高性价比互连,同时满足带宽需求。
根据行业机构测算,多模方案系统总成本可比单模方案低约30%至40%;在800G短距场景中,VCSEL加多模光纤的典型功耗也比单模方案低约10%至15%。当连接规模以万条计,单链路节省的成本与功耗将被成倍放大。
因此,在短距互联这一特定约束下,多模光纤凭借其独有特性,成为AI智算中心内部互联的优选项——在最密集的连接层实现成本、功耗与性能的最优解。
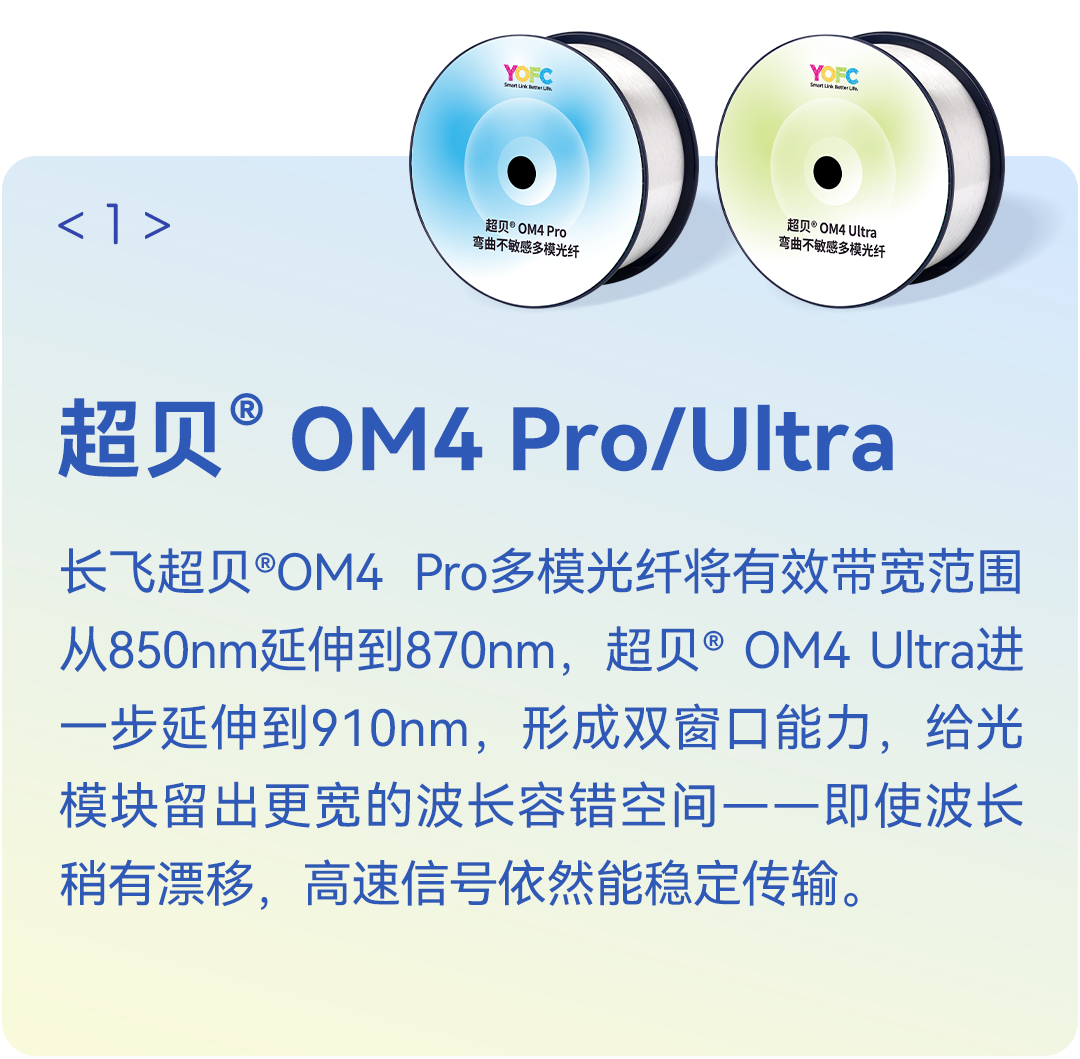
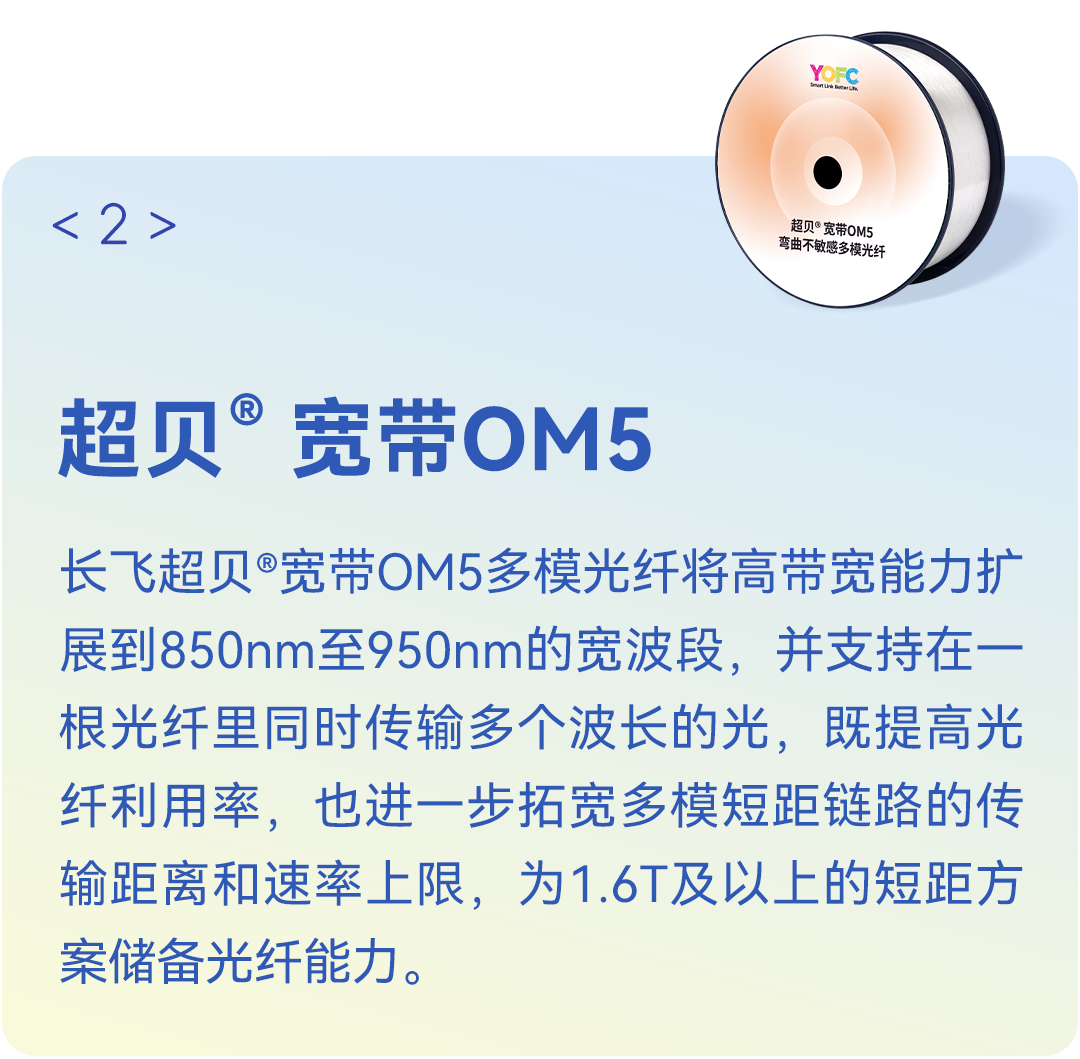
随着传输速率从400G迈向800G、1.6T,光模块发出的光波长不再精准固定在传统850nm附近,而是会往长波“跑偏”。传统OM4光纤在长波860~870nm附近的带宽余量,难以支持高速传输,面对波长漂移也愈发吃力。长飞的思路,是把光纤的“可用窗口”做宽。
左右滑动查看更多
这些产品背后,是长飞公司对光纤的前道工艺——PCVD制棒工艺的长期积累。PCVD工艺每层沉积厚度可达微米级,能够实现对光纤预制棒剖面结构的精细控制,这是渐变折射率多模光纤带宽性能的工艺根基。
在链路验证层面,长飞公司已基于212G VCSEL完成30至50米高速传输验证,并在IPEC标准框架下完成了基于30米多模光纤链路的1.6T SR8实时传输演示,以及150米800G-eSR8传输演示,将短距多模互联的速率与距离边界持续推进。
在AI智算中心,并非每一根光纤都需要承担长途传输的使命。百米以内的密集连接层,才是决定集群效率的关键环节。多模光纤以可控的成本、更低的功耗和持续演进的带宽能力,成为算力集群内部互连的坚实底座。长飞公司将依托持续的技术积累与产品创新,让这一底座在速率代际更替中始终保持可靠与高效,与产业伙伴共同夯实智算时代的连接根基。
 简体中文
 English