


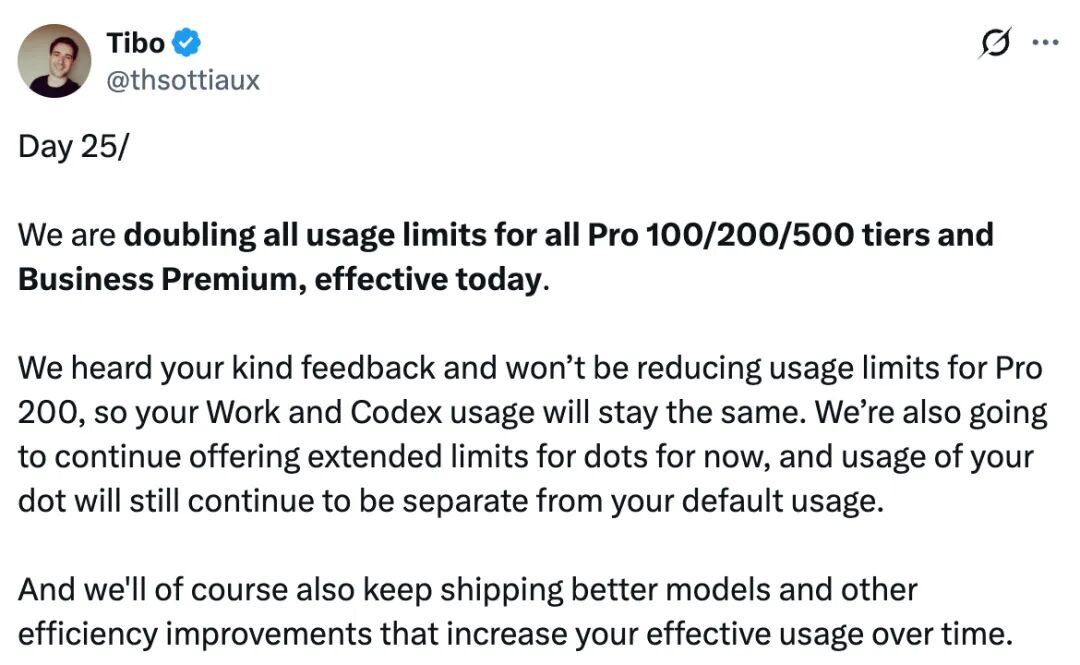
10 月 29 日,OpenAI 产品负责人 Tibo 宣布,从即日起,Pro 100、Pro 200、Pro 500 以及 Business Premium 套餐的使用限制全面翻倍。
其中还有一项重要说明:OpenAI 听取用户反馈后,决定不再削减 Pro 200 的使用额度,因此该套餐的 ChatGPT Work 和 Codex 使用量将维持原有水平。与此同时,Dots 目前仍将继续享有扩容额度,而且其使用量与账户默认额度相互独立,不计入默认额度。
这项调整实际上回应了此前 Pro 订阅体系调整引发的争议。OpenAI 此前推出 500 美元的 Pro 500,并调整 200 美元 Pro 套餐的权益,原有 Pro 200 用户曾面临部分使用额度下调的预期。此次公告撤回了相关削减安排,意味着用户反馈确实影响了最终政策决定。
后续,有用户进一步询问,Pro 500 是否意味着可以获得相当于 Plus 套餐 50 倍的使用量,Tibo 直接回答“Yes”。这也体现出 OpenAI 正在进一步拉开不同付费层级之间的使用额度差距,为高强度 AI 编程和工作流用户提供更大的使用空间。
社区对此并非一边倒地叫好。部分 Pro 用户欢迎额度扩容,但也有 200 美元 Pro 用户指出,自己此前已经享有较高额度,此次只是撤回了原定的削减计划,并没有获得真正意义上的新增权益。
“我很高兴其他 Pro 档位以及低额度套餐的用户拿到了实打实的额度上涨,这些才是真正的优化。但把取消原定降额这件事,打包算进 28 天改进计划里,对外宣传成全面翻倍升级,这有误导之嫌。坦白说,对于一直在跟进这件事、并且依赖官方公告做规划的用户而言,这种说法实在让人难以接受。”有用户说道。
与此同时,一些 Plus 用户对本次调整没有覆盖低价套餐表达不满,认为 OpenAI 正在进一步拉大不同付费层级之间的使用体验差距。
除了提高额度,Tibo 还强调,OpenAI 会继续推出更好的模型和效率优化,让用户随着时间推移获得更多实际使用量。值得注意的是,这次调整属于 OpenAI 为期 28 天的产品改进计划中的第 25 天。Tibo 随后还开玩笑称,OpenAI 正在从“重置额度公司”毕业,转向“Token 公司”。
OpenAI 负责 Codex 和 ChatGPT 产品的 Andrew Ambrosino 也表示,团队已经启动一轮密集改进,重点解决应用简洁性和性能问题,并由他亲自负责。
这意味着 OpenAI 并不打算只依靠扩大套餐上限解决用户需求,而是希望同时提高模型能力、推理效率和单位算力的产出。对于越来越依赖 Codex 的开发者而言,能否获得稳定、充足的使用额度,已经成为影响订阅决策的重要因素。
除了 OpenAI,过去一年,Anthropic 也频繁调整 Claude Code 的使用限制,甚至经历了从收紧到扩容、再到部分回收的过程。
2026 年 3 月,Anthropic 曾收紧免费、Pro 和 Max 用户在高峰时段的 5 小时使用额度;5 月与 SpaceX 达成算力合作后,又将 Claude Code 的 5 小时额度翻倍,并取消 Pro 和 Max 套餐的高峰期额度削减。与此同时,公司还曾将 Claude Code 周度额度临时提高 50%,但在 9 月结束促销后,仅保留了比原始水平高 25% 的永久额度。
对额度调整的不满,也引发了用户对订阅权益的诉讼。
Anthropic 的 Max 5x 和 Max 20x 套餐分别宣传提供 Pro 套餐 5 倍和 20 倍的使用量,但这一倍率实际上指每个 5 小时会话窗口内的使用量,而非每周累计使用量,用户同时还受到周度总量限制。今年 9 月,一批用户因此对 Anthropic 提起集体诉讼,认为相关限制没有在购买过程中得到充分、醒目的说明,导致实际使用体验与购买预期存在差距。
1 后台 Agent 在不起眼的地方吃了不少 Token
AI 编程工具的额度问题并非简单的套餐定价问题。随着 Agent 逐渐接管更多开发任务,后台自动执行、任务调度和多智能体协作也开始消耗大量算力,甚至出现用户没有直接感知到任务,却已经消耗了不少使用额度的情况。
今年 6 月,OpenAI 的 Codex 就曾出现过类似问题。当时,不少用户发现,原本需要一周才能消耗完的使用额度,突然在一两天内就被用完。部分 200 美元 Pro 用户表示,过去需要连续工作一周才能用完的额度,后来一天就可能消耗殆尽。
Tibo 随后解释,问题与后台工作量异常有关:自动代码审查和辅助子智能体有时会比预期更频繁地运行,甚至重复执行任务,或者在发生错误后过度重试,导致不必要的算力消耗。此外,Codex 仪表盘还曾显示一些实际上并未计入用户账单的活动,进一步加剧了用户对额度异常消耗的困惑。
为此,OpenAI 组织了紧急排查,成立专项团队调查问题,部署修复并重置所有用户的使用额度,同时增加后台使用量监控,以便更早发现类似问题。Tibo 还表示,团队会为用户额外补充一次额度重置,以弥补此前异常消耗造成的影响。
Anthropic 的 Claude Code 也被发现存在类似问题,只不过消耗发生在一个更加不起眼的环节。
8 月 15 日,一名开发者在 Anthropic 的 Claude Code GitHub 仓库提交 Issue,要求官方提供一个正式开关,允许用户关闭子智能体状态摘要,而不必牺牲整个子智能体功能。
问题出在 Claude Code 的后台状态刷新机制。当用户启动多个子智能体时,系统会定期调用模型,为每个活跃智能体生成一条简短状态提示,例如当前正在执行什么任务。按照开发者对 Claude Code 内部请求的分析,这项机制默认每隔 30 秒触发一次,每次都会重新提交子智能体的完整对话历史及工具定义,交给模型生成摘要。最终输出通常只有几十个 Token,主要用于更新界面中的状态文字,同时帮助用户和 Claude Code 掌握各个后台智能体的工作进展。
开发者对一次持续 4 小时、启动 27 个子智能体的会话进行了抓包分析。在 1496 次 API 请求中,有 339 次属于 agent_summary,占全部请求的 22.7%;这部分请求产生约 6276 万原始 Token,占总原始 Token 的 22.2%。按照 Opus 5 的缓存读取、缓存写入和输出价格进行加权后,其成本仍占整个会话约 18%。
另一名开发者在使用 4 个子智能体进行 1 小时 45 分钟测试时,也发现了类似问题。其中,一个长期运行的智能体上下文规模达到约 38 万 Token,103 次状态摘要请求产生 2180 万缓存读取 Token,占整个会话缓存读取量的 26%,但最终输出仅约 2100 个 Token。按照该开发者的测算,仅这个智能体用于生成状态提示,每小时就可能产生约 4500 万缓存读取 Token。
更麻烦的是,这些后台请求设置了skipTranscript: true,通常不会进入常规会话转录文件。因此,依赖会话记录统计消耗的第三方工具可能低估实际 Token 使用量。用户看到的是智能体状态栏里不断变化的几个词,背后却可能发生了大量上下文读取。
10 月 28 日,开发者“Flamerix AI”也公开了自己的监测结果。通过分析 Claude Code 的 OpenTelemetry 遥测数据,其发现,在一周的统计周期内,agent_summary占全部估算费用的 16.4%,占 API 请求总量的 19.7%,输入与输出 Token 比例约为 9000:1。换句话说,系统为生成少量状态文字,需要反复读取大量上下文。
Flamerix AI 随后发布了一份采用 MIT 许可证的开源脚本,尝试通过 Bun 预加载机制拦截相关定时器,在不修改 Claude Code 二进制文件的情况下关闭状态摘要。该脚本在 Linux 环境下进行了多个版本测试,关闭摘要后,后台子智能体、Forked Skills 和后台会话仍然能够正常运行,只是 Agents 面板不再持续更新状态文字。不过,这种方式依赖 Claude Code 内部实现,尚不是 Anthropic 官方支持的解决方案,后续版本更新也可能使其失效。
随着这件事持续在社区引发讨论,一位自称 Claude Code 团队成员的 Anthropic 工程师 Edwin Arbus 也出面回应。
他解释称,这项机制只针对正在工作的后台智能体,空闲状态的智能体不会持续触发摘要请求。Flamerix AI 测得的 16.4% 可能来自大量使用后台智能体的团队,并不具有普遍代表性。根据 Anthropic 上一周的遥测数据,在提交遥测信息的 Claude Code 用户中,agent_summary 按照 API 标价计算约占总成本的 2%,占请求总量略低于 4%;如果只看终端环境,这一比例约为 6%。
不过,Arbus 也承认,即使是 2%,对于一项主要用于生成状态提示的功能而言,成本仍然偏高。他透露,Anthropic 已经在 Claude Code 2.1.311 及之后的版本中修复了最昂贵的一类情况,即摘要请求未能命中提示缓存的问题。目前团队还在开发一种更便宜的实现方式,不再每次都提交完整对话历史,而是发送简短笔记,再交由更小的模型生成摘要。
不过,这并不意味着后台摘要开销已经完全消除。10 月 29 日,仍有开发者在 Claude Code 2.1.312 版本上复现了相关请求。另有开发者对 30 天内 129 次后台智能体会话进行统计,发现 agent_summary 约占请求量的 14%、估算费用的 10%,在一个包含 40 个智能体的会话中甚至达到 24%。
这也说明,问题并非简单的后台请求数量过多,而是上下文规模、缓存命中率、模型选择和刷新频率共同决定了最终成本。对于长期运行的智能体,哪怕每次请求都能命中缓存,反复读取数十万 Token 的上下文,累计起来仍然是一笔不小的开销。
2 AI 编程工具怎样才能稳定服务?
开发者愿意为 AI 编程投入大量预算,根本原因还是它可能带来真实的生产力提升。不过,工具使用量增加并不等于收益同比增加,如何衡量投入产出比(ROI)正在成为新的问题。
额度调整对用户产生影响的同时,也会反过来影响 AI 编程工具厂商自身的商业模式。
固定月费订阅与按量计费有着不同的经济逻辑。对于按 Token 收费的 API 业务,用户消耗越多,厂商通常获得越多收入;但对于 Pro、Max 等固定月费订阅,用户支付的价格相对固定,推理成本却可能随着使用量持续增加。尤其当 Agent 可以长时间自主运行、并行调用多个子智能体时,少数重度用户就可能产生远高于普通用户的算力成本。
Anthropic 的基础设施投入也能说明这种压力。其 IPO 文件也指出,计算力是 Anthropic 最大的成本项目,公司未来 10 年对合作伙伴的算力和基础设施支出承诺超过 6000 亿美元,其中相当一部分合同不可取消,或不取决于实际使用量。对于这样的厂商而言,算力既是产品供给的基础,也是必须长期管理的重大成本。
因此,收紧额度能够在短期内控制单用户成本、保护订阅业务毛利;提高额度则有利于吸引重度开发者,增强产品黏性,并扩大企业客户使用规模。但如果厂商频繁改变用户已经形成预期的使用权益,就可能损害品牌信任,甚至促使企业建立多供应商策略,降低对单一产品的依赖。
AI 编程工具最终卖给开发者的不只是模型能力,更是一种可以持续调用的研发生产力。如果厂商无法让用户准确预测成本,也无法保证关键工作流的持续运行,那么即使模型能力再强,开发者也可能选择限制使用、分散供应商,甚至重新评估采购计划。
参考链接:
https://x.com/thsottiaux/status/2115850175868727621
https://github.com/anthropics/claude-code/issues/86879
https://news.ycombinator.com/item?id=50284255
https://www.businessinsider.com/openai-codex-usage-limit-warroom-fix-issue-2026-6
https://community.openai.com/t/day-25-wasnt-a-2x-improvement-for-existing-pro-200-users-stop-calling-a-canceled-downgrade-an-upgrade/1410852
https://gist.github.com/flamerix-ai/c3905705cc4205e5de3011fa2e74efce
https://www.reuters.com/legal/litigation/anthropics-ipo-close-look-ai-frontrunners-rapid-growth-spiraling-costs-2026-10-26/
https://www.theverge.com/ai-artificial-intelligence/990313/anthropic-class-action-lawsuit-pricing-subscription-plans




 简体中文
 English