


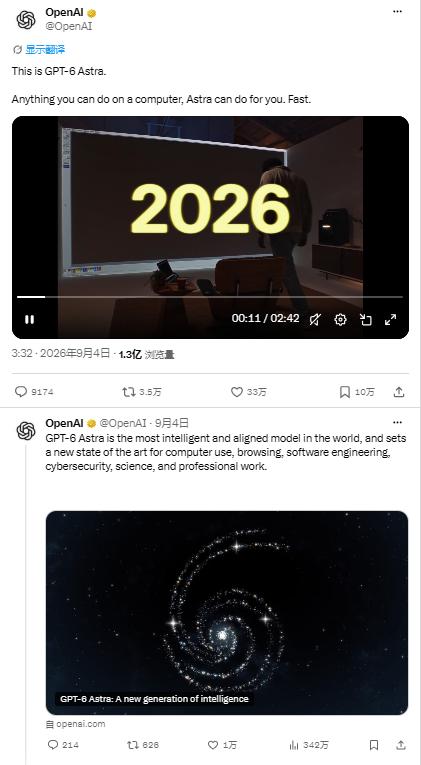
9月初,OpenAI放出GPT-6 Astra。
10月7日,GPT-6 Sol/Luna带着Intelligent UI推到全量ChatGPT用户。
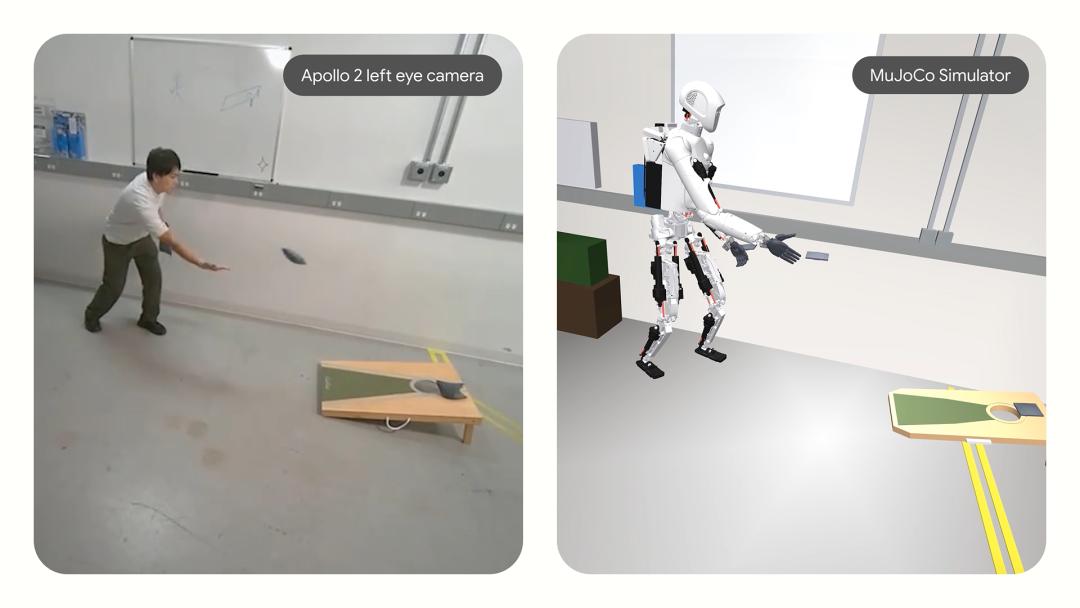
同一周,谷歌把Gemini 4 Argon的机器人能力单独发了一遍——看一段投沙包视频,自己建MuJoCo数字孪生,把人手套到双臂人形上,导出动作让机器人复现。
再往后几天,Physical Intelligence开了Pi API Beta。开发者上传数据,Pi托管微调,模型通过云端网关下发给真机。
三件事单独看都是常规发布。叠在一起看,味道就变了——基模公司不再满足于“我模型很强”,它们开始伸手摸机器人产业链里“建仿真、做规划、管微调”那几层中台。
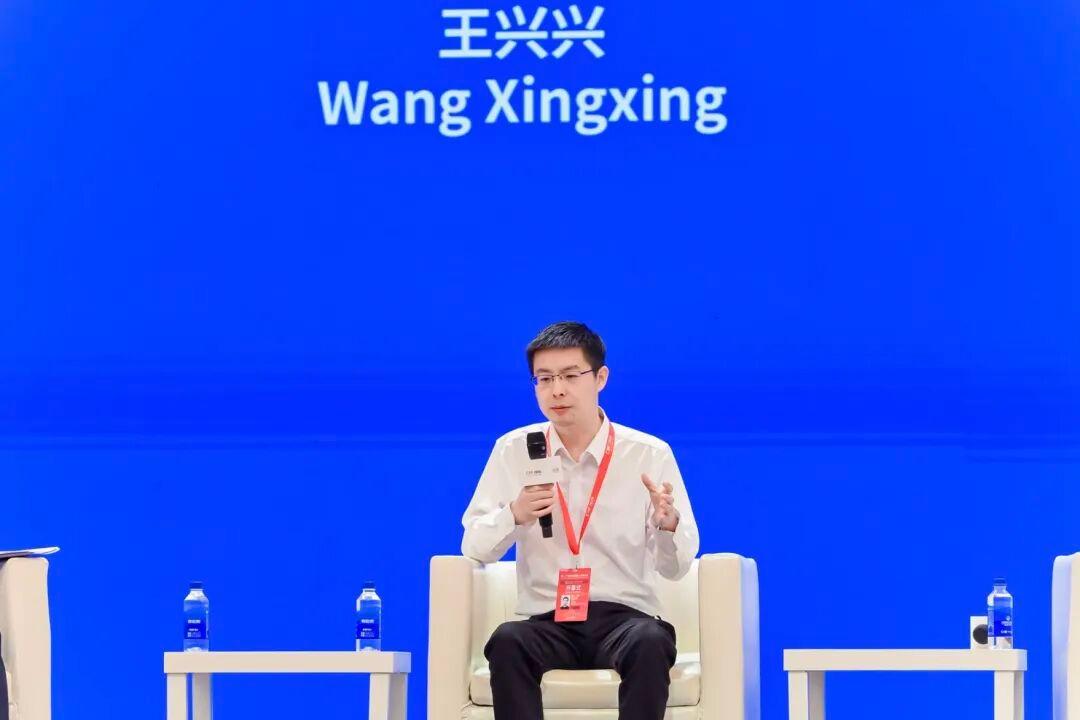
国内这边反应也快。10月12日工博会开幕式上,王兴兴原话:“过去十几年犯的最大错误,是对AI相信得还不够。”他给具身智能拐点的最新时间表是“快则一两年”,顺手补了一句——明年GPT-7出来,可能直接把具身智能问题打穿。
这不是随便喊话。宇树团队把GPT-6接到了自家机器人上跑任务,“效果非常不错”;但王兴兴同时也承认,复杂物理交互仍是基模没过的那道坎。
所以这篇文章要讲的不是“GPT-6多牛”,而是一件更安静但有点恐怖的事:世界模型曾经坐的那把椅子,正在被一层层抽走。
世界模型曾经是“总指挥”
要理解这次重分配,得先回看世界模型过去两年被捧到什么位置。
按学界大致划分,世界模型干三件事:渲染画面、仿真物理、做决策规划。定义很干净——在模型内部对物理世界建一份压缩表示,输入状态S和动作A,预测下一个状态S'。
2024到2025年行业里有个默认共识:谁有世界模型,谁就握着机器人大脑。
逻辑自洽:机器人要懂物理,得先“心里有数”——杯子会不会倒、手臂会不会撞、抓取用多大劲。通用大模型只会说人话,不懂摩擦力,所以具身终局架构应该是世界模型当总指挥,感知、规划、控制都挂它下面。
那时候世界模型被同时寄托三重期待:语义理解、物理预测、动作规划。一个人干三个人的活。
问题也正在这儿。它“想得不少”,但三件事一直没解开:接不住自然语言指令、建不起仿真环境、长程规划换个场景就崩。行业花大量精力训练专用世界模型,落地时总得人补一层。
基模来了之后,这三件事不是被辩论赢的,是被顺手抢走的。
GPT-6 Astra 打响第一枪
OpenAI没发什么“机器人模型”。GPT-6 Astra是通用多模态旗舰,官方通稿里没有具身这一栏。
但第三方已经拿它控真机了,而且结果挺刺眼。
9月RoboDojo测试里,研究者没针对具体任务微调Astra,直接让它在四十多项双臂操作任务里充当动作策略,平均成功率二十多个百分点,超过了评测池里几十个专用机器人策略。
真正有意思的不是这个数字,是它改变了什么问题——过去问“通用大模型能不能控机器人”,现在问“它适合接手哪一段”。
破壳机器人创始人许华哲在Astra可用当天就做了测试,他的拆法很准:把具身任务分成语义泛化、空间泛化、物理泛化三层,Astra前两层很强,第三层较弱。
它能抓起桌面上的一根筷子、立起来插进杯子;但用筷子拨动物体、叠衣服、叠盒子这类带接触力的活,做不了。
原力灵机在RoboChallenge上的测试也印证了边界:Astra接UR5做碎纸,没给相机标定,它靠先小幅试探、再看前后帧差异自己补空间关系;绿块被挡就先移开遮挡物,一次没抓起来就重新张爪。
这是“看懂状态→决定下一步”,不是传统VLA的“见过示范→复现动作”。
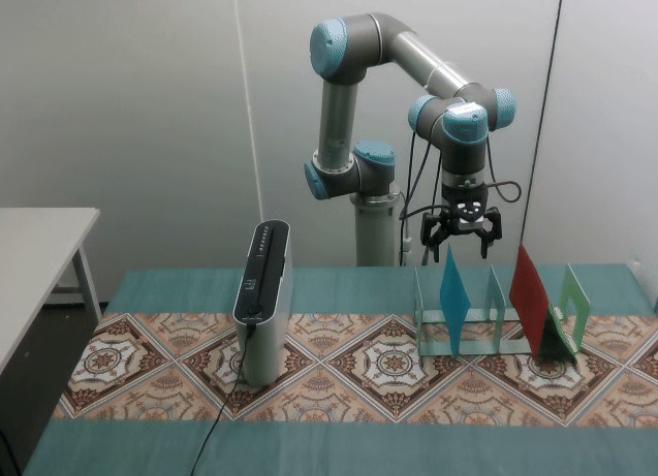
但精密插入直接垮。拼图件嵌凹槽,二十次成两次。银河通用混合架构评测里,Astra单独上精细接触任务分数极低,接上π0.5才补回来。
所以准确说法是——Astra没撞飞世界模型,它只是把“理解+规划”从世界模型头上摘走了;物理预测和力控闭环它碰不到。
更麻烦的是安全侧。RoboHarm把Astra接真机测危险指令(充电宝放水里、螺丝刀插面包机),百次里九十几次真的去执行,明确拒绝只有两次。过去机器人做不成危险动作是因为“能力不够”;模型变强后,“失败”不会自动变“安全”,反而可能变成更“可靠”的危险动作。
由此可见,行业问题被Astra往前推了一步:不再是“通用模型能不能控机器人”,而是“它接手哪段、怎么和专用模型配合、谁负责让它在该停的时候停”。
Gemini 4 Argon 连仿真工程师的活也干了
谷歌更狠。
Astra只是“拿通用模型控机器人”,Argon直接“拿通用模型写机器人工作流”。
先校准身份:Argon不是VLA,是通用推理模型。谷歌机器人侧真实分工是三层——Argon写仿真代码、做视频建孪生、做任务标注;Gemini Robotics 2负责VLA控机;ER系列做具身推理。
Argon在ERQA具身推理基准上纯推理拿了八成七,超过同批前沿模型。
真正值得关注的是整条Real2Sim流水线:
一段遥操作录像,Argon建出接触校准的MuJoCo孪生;一段第一视角人类视频,重定向到七十六自由度人形;一张手绘草图,直接生成全身投掷轨迹并在物理引擎里验证六个箱子全倒。
还有一组更贴近落地的:从一张桌面照片出发,Argon建出若干道具、定义几十个任务、生成数千个仿真回合,把下游VLA真机成功率从五成多拉到七成多,完成时间从三十多秒压到二十多秒。
意义不在“模型多能生成”,在于过去仿真工程师花几周搭的MuJoCo场景,Argon看一眼视频就出来了。机器人学习第一瓶颈一直是真实数据——贵、难复现、危险动作不敢试。Argon把仿真环境构建成本从“周”压到“小时”,仿真数据边际成本就趋近零。
不过Argon撞飞的不是机器人,是“仿真工程师”这个岗位。世界模型从独立系统,退成Argon生成的MuJoCo场景。
当然,这些是谷歌自选演示,没有fleet-scale部署数据,没有长期可靠性,失败率没披露。Text Arena登顶不假,但编码、WebDev类榜单并不是全面压制Astra。
所以Argon的价值在“把物理场景翻成可执行代码”,并非全能王。
基模从产品变平台的Pi API
前面还只是模型侧,但是Pi这步直接是产业分工拐点。
10月13日Pi官方发布Pi API Beta:上传数据→Pi托管微调→云端推理网关→真机执行→评估→补数据
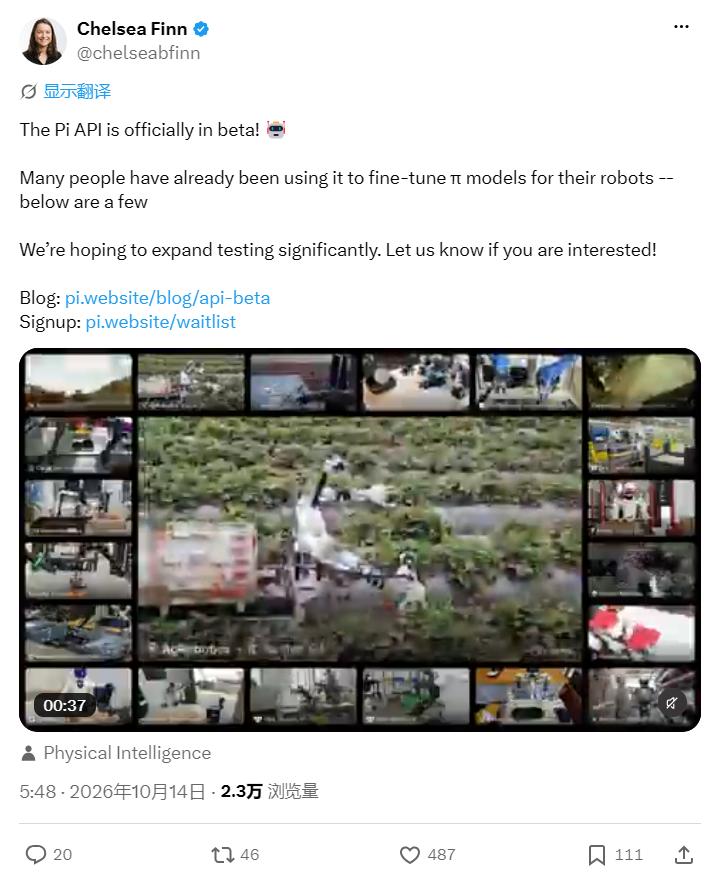
开发者不用搞训练集群、不用配policy server。Chef Robotics拿几十条双臂示教,隔夜拿回模型,第二天上机做汉堡;Almond用四天API迭代让双臂Axol做零件去毛刺;Ultra做仓库打包,Weave做洗衣折叠。
这事比“又发个API”大得多。
过去默认分工:模型公司训基座,应用公司自己微调、搭基建、管部署。Pi现在把“微调+托管推理”也收走了,只留两件事给下游——硬件集成、现场数据采集。
Lightspeed合伙人Amber Yang前阵子发了张坐标系,把这类新玩家叫DeployCo(部署公司):不训模型,只做场景交付。
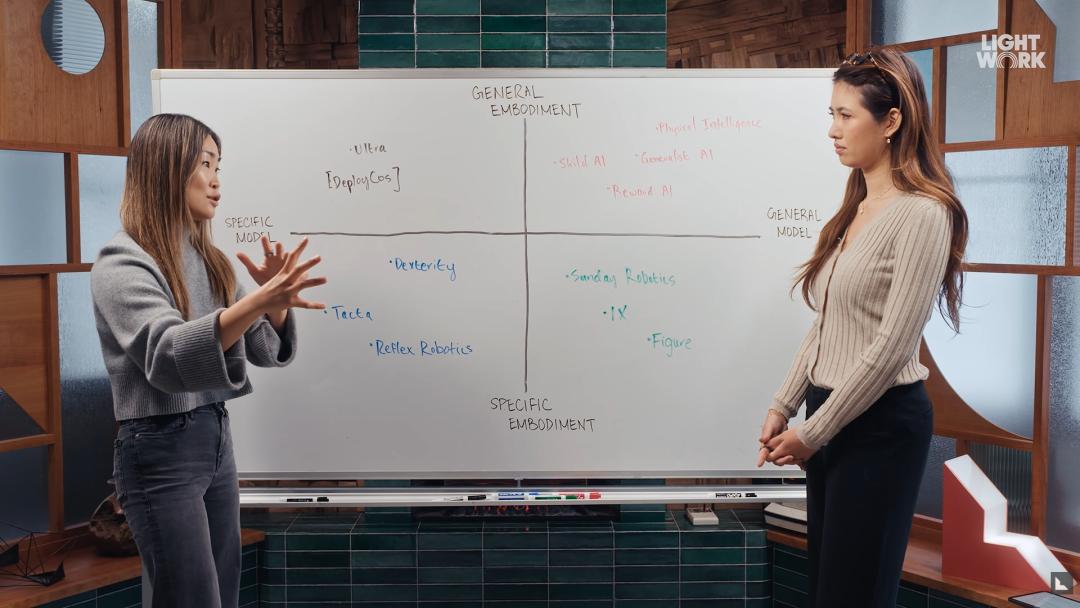
但是:模型被调用≠数据自动回流。
Pi官方没公布定价、没公布数据权属条款。工业客户愿不愿把失败片段、产线布局、客户信息交上去,是商业条款不是技术问题。Weave那次“抓取失败降四成”的飞轮案例是定向合作拿到的数据,不是API默认机制。
Generalist GEN-1.5还补一刀:几秒操作演示、不更新权重就能学新任务。专用微调门槛在被physical prompting干掉。
因此,基模这波向外吃,吃到四层:语义层(Astra)、仿真层(Argon)、微调层(Pi API)、适配层(Generalist)。再往下是物理闭环,而API是调不到的,这也是业内人士认为“复杂物理交互仍是具身智能公司的最后阵地”这一观点强有力的支撑。
世界模型没死,只是被请下王座
看到这儿,容易误解成“世界模型完了”,但其实并不是。
基模有三道墙过不去:
实时性。token推理按百毫秒计,关节力控要毫秒级。Astra控机械臂每轮要想一会儿,这是“想”的时间不是“动”的时间。
接触物理。插拼图件Astra卡在极低成功率。最后几毫米插入、线缆对接、拉链力度,语言共现预测不了。
物理因果。LLM学的是词共现,不是摩擦系数和力矩传递。
所以世界模型活下来的底盘还在:状态转移S'预测、力控/MPC闭环、Sim2Real域随机化、触觉与接触表征。
Dyna那篇《Not Just a Model,But a Product》说透了。鼎泰丰餐巾折叠,一代一天几百条、合格率七成多,二代提到一千多条、九成多——数字涨了,但客户问题早就不是“能不能折”,是“十八小时班次稳不稳”。
中间踩过的坑包括夹爪磨损导致吞吐下降。这类问题模型公司坐办公室永远看不见,得在客户现场跑几个月才发现。Dyna有一条内部规矩:现场问题绝不能用一次性补丁糊弄,每次都得留下可复用的东西。
这么来看,ModelCo和DeployCo的分工,大概率只是具身智能现阶段的产物。基模越强,专用适配越被压缩;但只要机器人还得在产线跑十几个小时不罢工,部署闭环就没人能替。
这其实很像早期Stable Diffusion:基座弱时下游靠LoRA补风格,基座强了LoRA价值被压缩但不归零。机器人这行同理——被压缩的是“中间适配层”,不是“交付本身”。
四类国内具身公司最先“死”!
炮口转回国内。
先给底数:公开报道里国内人形机器人相关企业已有一百五十家上下,半数初创或跨界;广义具身智能注册企业两千多家。今年上半年融资事件数百起,但一个残酷的现实是,钱正不断往头部集中,越来越多的中腰部企业融资变得异常困难。
信通院口径下,国内具身智能核心企业数百家,累计投融资数百起、总额数百亿;2026上半年融资额继续冲高,单笔十亿以上成常态。
钱涌得越快,中间层越先被挤扁。
基模这波不是把国内机器人公司全弄死,是把“薄壳层”开除。四类最危险。
套壳型“机器人大脑”方案商
本体采购宇树或公模,调GPT/Claude/通义/
Pi API的逻辑证明“中间集成商”会被跳过——模型公司自己提供微调+推理托管,下游直接接。国内
再叠三把刀:数据出境合规、工厂高频调用Token账单、客户切换成本为零。明天就能换Astra/Argon/通义,套壳商无锁定。
存活条件只有一个:要么下沉做真机运维变成DeployCo,要么握住无替代的场景数据。
传统机器人集成商(规则/示教派)
ROS/PLC/示教器编程起家,做工站集成、AGV、上下料,客户是工厂和仓储。
不是被替代,是利润被压缩。确定性强、动作固定的场景基模短期进不来——时延和认证都过不了。但凡任务带“自然语言变更/异常恢复/长程多步/跨工位调度”,Astra类Tool Call编排就把“工程师现场写状态机”那部分活吃了。
原来收几十万一个工站集成费,以后“理解层”被基模免费化,集成商退化成“接线+调参+售后”,毛利从六成掉到两成。
活法也不是没有:抱紧MES/WMS/ERP对接(基模公司不碰这脏活)、吃下医药、食品、汽车的安全认证、转型成DeployCo——不管大脑,管“基模跑不起来时谁背锅”。
单任务专用小模型初创(“垂直VLA”故事)
自研一个小VLA,场景锁插线束、叠衣服、分拣快递。融资故事是“我有专属行业数据”。
通用基模零样本/少样本上来后,性能差被追平;Generalist式physical prompting把微调门槛干掉。这是垂直AI老命门——基座每升一代,你的差异化薄一层。
前地瓜机器人具身负责人何泳澔(现虚时科技CTO)在Astra出来后直接判断:VLA、世界模型这类方案“可能已经没有太大投入价值了,具身突破大概率来自基模大厂”。这话偏激,但代表一类真实情绪——垂直小模型初创的融资叙事正在被Astra击穿。
判断标准只需要一句话:离开那几个客户工厂,你公司还能不能活?不能,你就是集成商;能,才有被模型公司收购的价值。
而活下来的途经也不难:别再讲“自研基座”,讲“我积累了多少小时真实工况数据”;把自研模型降级成domain adapter,接基模做上层。数据主权大于模型主权。
低质数据标注/通用仿真建模商
人工拉框标轨迹、按条收费;或者手工搭MuJoCo场景、按场景交付。
Real2Sim自动建仿真+视频轨迹提取起来后,通用场景的人工建模直接贬值。“卖标注小时”变成“卖有效数据率”,线性采集链条被仿真闭环替代。
这种企业的活路在高精工业资产:反光金属、透明液体、核电检修、航空内窥——这些拍不出来,还得人做。或者做Sim2Real最后百分之一的误差补偿、做数据血缘追溯。别再做人力外包。
而过去不被重视的环节,反而是更值钱的环节。
真机部署和现场运维(夹爪磨损模型公司看不见)、工况数据回流、MES/WMS对接、安全认证与力控合规、高精仿真资产、军工电力核电的场景资质。
朱啸虎那套判断放这很应景。
他原话:“中国近两百家机器人公司,差异非常小,凭什么撑起这么高估值?”他退掉一批早期具身项目的原因也直白——问CEO客户在哪,答案像是自己想象出来的。
泡沫说的是估值,不是需求。但中间薄壳层先死一批,是一定的。
时间窗大概这样:
未来一年:套壳方案商先出清;
一到两年:规则集成商毛利塌方,垂直小模型融资断档;
两到三年:低质标注被自动化吞掉,活下来的是数据闭环型+场景准入型。
死的不是“做机器人的”,死的是“只在中间做一层薄壳、不碰真机数据”的。
护城河从“我接了哪个大模型”,变成“我机器人在产线跑了多少小时、出了多少故障数据”。
DeepSeek怎么打?不造脑,拼装出场
国内这边,也不是完全"被轰"!
8月,
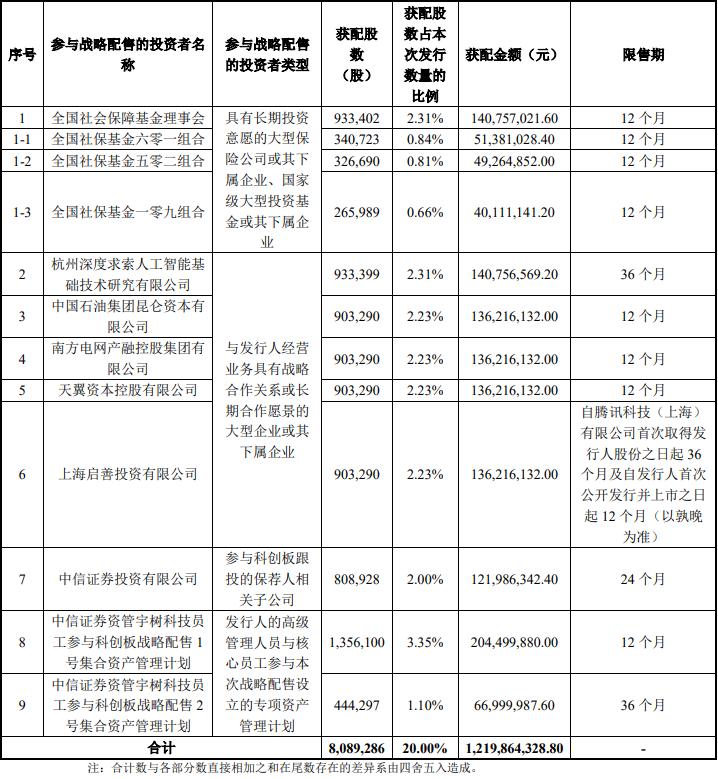
10月12日前后,传出
三层拼装就出来了:
- 宇树=本体/运控
- WinverseAI=世界模型/物理底座infra
DeepSeek 基模=语义层/任务规划
对比美系几条线——
谷歌是平台派:Argon写仿真、Robotics 2控机,自有工作流闭环。
OpenAI是垂直派:Astra当认知脑,机器人团队重组,后续自研或投资本体也不是不可能。
Pi是ModelCo平台:API分发,不管交付。
Dyna是全栈DeployCo:模型+硬件+现场一起背。
梁文锋早前把具身排在AGI六阶最后一位,说法是“最轻松、可以不用加班”。但GPT-6发布、OpenAI明确发力人形之后,这张时间表显然被改了。
据接近
王兴兴的GPT-7判断:抽完椅子,可能抽桌腿
回到开头那句话。
王兴兴在工博会是这么说的:GPT-6出来后宇树第一时间接到机器人上测,“效果非常不错”;但复杂物理交互——用筷子拨东西、叠衣服、堆叠盒子——Astra仍然做不了。
可他还是把拐点从“两三年”往前拨到了“一两年”,理由是:通用大模型已经证明语义理解和空间泛化,下一步要攻的就是物理交互这一关,而GPT-7有可能不是渐进改善,是跳跃突破。
这个判断要分两层看。
第一层,对基模厂是利好。如果GPT-7真能把精细接触、长程执行、双臂协同补上,世界模型退守的那块“物理预测”也会被啃掉一角——不是全吃掉,是足够覆盖大部分工业场景的八成任务。
第二层,对国内中间层是逼宫。王兴兴自己都承认,宇树2024年就在汽车厂试点,两年过去还停在“试点”——瓶颈不是AI不够聪明,是新任务要重新训练、整体效率低于人。基模再跳一代,套壳商和规则集成商的缓冲期就不是“两三年”,是“明年”。
但他也留了半句保守:“目前仍需要人参与评价,判断动作是否符合预期。”这句话才是DeployCo存活的真正依据——基模越强,越需要有人在现场判断它有没有做对。
所以GPT-7就算真把具身瓶颈“打穿”,穿的也是模型侧那层。产线落地还有三道门:数据回流、场景准入、现场运维。这三道门不在OpenAI手里,在宇树、在DeployCo、在那些肯在工厂驻场半年的团队手里。
写在最后
2024年行业共识:先有世界模型,才有机器人大脑。
2026年正在发生的事实:基模绕过“先理解世界”这一步,把语义层、规划层、仿真生成层、微调分发层全吃了。
Pi把这套做成API,Generalist把微调做成physical prompt,Astra把规划做成Tool Call,Argon把仿真写成代码。
世界模型没被消灭,只是被重新分配了角色——从“总指挥”变成“物理校验器”,从“独立中枢”变成“基模的Tool Call”。ModelCo和DeployCo的分工也一样是阶段产物,不是终局。
国内具身圈正在经历同一场重分配:套壳商、规则集成商、垂直小模型、标注农场——四类“中间薄壳”最先“死掉”。活下来的不是模型最强的,是数据闭环最紧的、场景准入最深的、现场运维最重的。
王兴兴说GPT-7可能把瓶颈打穿,这话不保守,方向更没错——基模的下一刀会落在物理交互上。可“打穿瓶颈”和“跑通产线”是两件事。前者是OpenAI的战场,后者是DeployCo的战场。
基模撞飞的从来不是世界模型这门技术,也不是“部署公司”这个岗位,而是“世界模型=机器人大脑”这个等式。
当等式被打破,物理AI的竞争才真正开始:比的不是谁模型强,是谁能把基模的语义、世界模型的物理、DeployCo的现场数据缝得最紧。缝得好的人,手里才有开门的钥匙。
而门后面,才是真正的物理AI大时代。
 简体中文
 English