


1962年"数据管理"第一次被写进文献时,它的目的是省下存放穿孔卡的那一整层楼
一句话说清楚:数据治理不是一个新词,它已经走了六十年。而且它每一次"重新变热",都不是因为技术发明了什么新东西,而是因为谁在消费数据、为什么要消费它变了。今天我们重读这段历史,不是为了怀旧,是为了看懂:AI 时代的数据治理,到底要解决什么问题。
00 先给一张六十年全景图
在讲故事之前,先把时间线摆出来,方便你按图索骥:
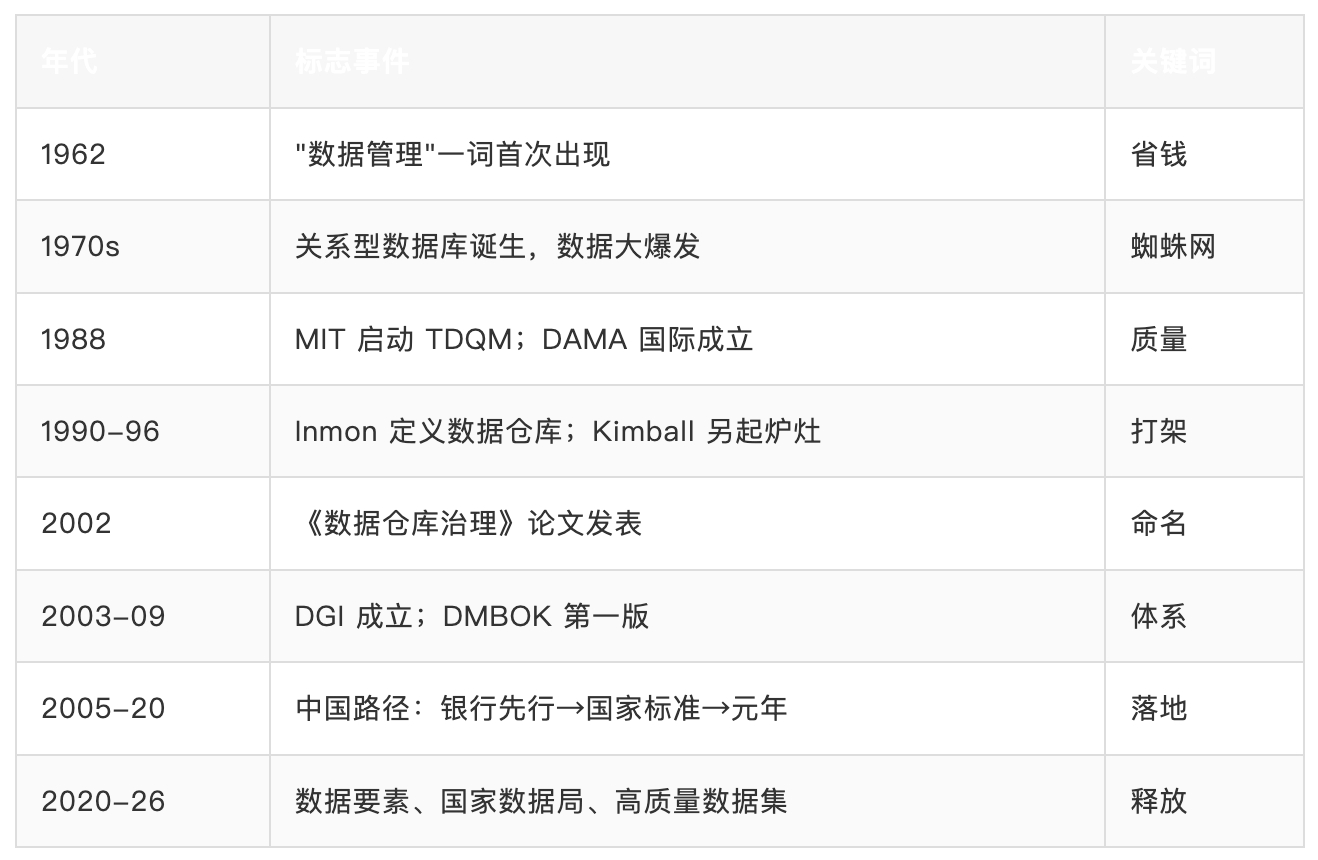
接下来,我们一个阶段一个阶段地讲人、讲故事。
01 穿孔卡时代:数据管理的原动力,是"省钱"
很多人以为数据治理是互联网时代的产物。其实不是。
"数据管理"(Data Management)这个词,1962 年就出现在文献里了。那一年,数据处理服务组织协会(ADAPSO)正式提出这个概念,CJ Roach 在《Part XVIII. Data management》里给出了最早的定义:研究数据如何被收集、记录、存储、检索、分析和展示。
但你猜当时人们为什么要"管理"数据?不是为了用,是为了省。
那个年代数据存在穿孔卡上。有多占地方?有些公司要用整整一层楼来存放穿孔卡。所以那时的数据管理,关注的重点是"少存点、存好点、别浪费"——本质上是在优化硬件成本,跟今天的"释放数据价值"完全是两回事,甚至还带着点档案管理的味道。
真正的转折发生在 70 年代。磁盘取代了磁带,磁盘提供直接寻址能力,操作灵活了,一种叫"数据库管理系统(DBMS)"的软件诞生了——就是今天我们说的关库型数据库的祖先。OLTP 系统随之出现,数据开始爆炸式生产。
然后,一件影响深远的事发生了:有人写了一个叫"抽取"的程序,把数据从 OLTP 库里抽到一个新库里,再对新库做操作。这样既不影响生产系统,又能随意折腾数据。这其实就是数据仓库和 OLAP 的起源。
但"抽取"带来了一个副作用——每抽一次,就多一份脱离管控的数据副本。日积月累,整个企业变成了"蜘蛛网"式的自然演化体系结构。这个比喻后来被 Bill Inmon 反复引用:企业越庞大、越成熟,这张网就越乱、越解不开。
于是,数据管理第一次被赋予了新含义:不只是省空间,而是降低冗余、保证一致。70 年代末,诺兰(Nolan)的信息化成熟度模型里,专门讲了"数据管理(Data Administration)"这个阶段——企业信息化走到一定阶段,必然撞上数据孤岛这一关。
这一阶段的启示:数据治理的第一次出现,驱动力是成本;第二次出现,驱动力是混乱。都不是因为数据"值钱",而是因为数据"碍事"。这个底层逻辑,后面还会反复出现。
02 1988:MIT 的两个教授,把"质量管理"搬进了数据世界
1988 年是数据治理史上极其重要的一年,两件事同时发生。
第一件事在 MIT。Richard Y. Wang 和 Stuart Madnick 两位教授启动了"全面数据质量管理"(TDQM,Total Data Quality Management)项目。
他们的灵感来源很有意思——不是来自计算机科学,而是来自制造业的质量管理。TDQM 提出了一个核心概念:"数据制造"。
什么意思?他们认为,数据不是凭空产生的,它像工业品一样,是被"生产"出来的:有原材料(源数据)、有加工工序(ETL)、有产成品(报表和指标)、有质检环节。既然工业品可以用全面质量管理(TQM)来管控,那数据为什么不行?
顺着这个思路,TDQM 确立了数据质量的三大管理要素:度量、分析、改进,并强调从经济、技术、组织三个维度同时下手。1994 年,他们进一步提出四类质量维度:固有质量(准确性、可信度)、上下文质量(时效性、相关性)、可呈现质量(可解释性、一致性)、可访问质量(可访问性、安全性)。
今天你在 DAMA 里看到的那些质量维度,源头就在这里。
第二件事在洛杉矶之外——国际数据管理协会 DAMA 正式成立(首个分会 1984 年在洛杉矶成立,1988 年选举产生首届管理委员会)。一批意识到"数据需要专业管理"的人,终于有了自己的组织。
同一时期还有个小插曲:1987 年,John Zachman 提出了企业架构(Enterprise Architecture)框架,特别强调数据架构对解决"重复建设、缺乏统一视图"的作用。但尴尬的是,相比业务架构的贴近业务、应用架构的看得见摸得着,数据架构的作用一直不温不火——它没有立刻带来治理的春天。
这一阶段的启示:最重要的一次思想跃迁——数据可以被当作产品来管理。一旦接受"数据是制造出来的",质量问题就不再是"人的疏忽",而是"工序的缺陷"。这是后来所有数据质量方法论的地基。
03 1990s:两个"之父"吵架,吵了六年
90 年代,数据治理史上最著名的一场争论爆发了。主角是两位大佬。
一位是 Bill Inmon,"数据仓库之父"。1990 年,他提出了"数据仓库"的概念,次年出版《建立数据仓库》,给出了那个被引用最多的定义:数据仓库是"面向主题的、集成的、随时间变化的、非易变的、用于支持管理决策的数据集合"。
Inmon 主张自上而下:先建一个全企业统一、高度规范化(3NF)的企业级数据仓库,作为唯一权威真相源,再从它派生出各个部门的数据集市。
另一位是 Ralph Kimball,"商业智能之父"。1996 年,他出版《数据仓库工具箱》,主张自下而上:先挑一个具体业务流程(零售销售、客服、Web 分析),建一个维度模型(星型模型),一个事实表周围挂一圈维度表,交付给业务,收反馈,再做下一个。多个数据集市之间通过"总线架构"和一致性维度串起来。
有意思的是,两人其实是生活中的好朋友。但他们的粉丝吵得不可开交,一度差点打起来。争论的实质是两种世界观的碰撞:
Inmon 要的是全局一致性——先苦后甜,代价是项目周期长、投入大。连 Inmon 自己都承认,他的方法昂贵、短期内不容易看到 ROI,历史上纯 Inmon 路线的项目往往要18 到 36 个月才能交付第一张面向分析师的报表。
Kimball 要的是快速见效——几周就能交付第一个星型模型,代价是"集成债":如果一致性维度管不好,不同时期、不同团队建的集市会各自漂移,最后变成一堆难以调和的孤岛。
这场架最后怎么平的?Inmon 推出了 CIF(企业信息工厂),把 Kimball 的数据集市也纳入了进来,形成一个更大的框架——相当于"我承认你的东西有用,但得挂在我的体系里"。争论这才平息。
这一阶段的启示:这场争论从未真正结束。今天的数据湖仓之争、Data Mesh 与集中治理之争、"先建标准还是先出报表"之争,骨子里还是 Inmon 与 Kimball 的那个问题:是先有全局一致,还是先有局部可用?2026 年主流的 Medallion 架构(Bronze 原始层 / Silver 治理层 / Gold 消费层),本质上就是一次官方和解——Silver 层是 Inmon 的,Gold 层是 Kimball 的。
04 2002:命名的那一刻,来自一家保险公司
讲了这么久"数据管理",那"数据治理"(Data Governance)这个词,到底什么时候第一次正式登场的?
学术界的共识是 2002 年。
那一年,三位美国学者——Hugh J. Watson、Celia Fuller、Thilini Ariyachandra——发表了一篇论文,题目是《Data warehouse governance: best practices at Blue Cross and Blue Shield of North Carolina》(数据仓库治理:北卡罗来纳蓝十字蓝盾公司的最佳实践)。
注意这个题目:它不是一篇纯理论文章,而是一家医疗保险公司的真实项目复盘。三位作者把那个项目里如何组织团队、如何协调利益相关方、如何系统化推进质量管理的过程写了出来——这是历史上第一次公开、系统地记录"数据治理"的实践。
论文里有一句非常关键的话:"数据仓库治理是 IT 治理的一个子集。"它要求建立恰当的组织结构和流程,协调所有利益相关方的投入,覆盖基础设施、使用和项目管理三个层面。
这句话解释了数据治理的出身——它是从 IT 治理里长出来的。所以早期数据治理框架的核心要素和 IT 治理高度一致:组织(谁负责)、战略(为什么做)、架构(管什么)、流程(什么时候管)。
换句话说,数据治理从诞生的第一天起,重点就不是"技术怎么实现",而是"权责怎么分配"。这个基因一直保留到今天——你去翻 DAMA 的定义,核心依然是"决策权"和"问责制"。
这一阶段的启示:很多人今天做数据治理做成"IT 部门的技术项目",其实是走偏了。它的原生定义是管理问题:谁说了算、谁负责、谁来协调。技术只是执行手段。
05 2003-2017:从一句话,变成一套体系
概念有了,接下来需要有人把它变成可执行的框架。
2003 年,Gwen Thomas 创立了国际数据治理研究所(DGI)。他们做了一件关键的事:把"治理"这个抽象词,拆成了12 个步骤——调整政策与控制、建立决策权、建立问责制、执行管理、管理变革、定义数据、解决问题、指定数据质量要求、将治理融入技术、利益相关方关怀、沟通、衡量和报告价值。
同时给出十大关键组件:使命愿景、目标与治理指标、规则定义与政策、决策权、问责制、控制、数据利益相关方、数据治理办公室、数据治理委员会,以及主动/被动/持续的治理流程。
如果你今天要给一家企业搭数据治理体系,这套东西依然是最实用的骨架之一。
另一条线是 DAMA。2009 年,DAMA 国际发布《DAMA 数据管理知识体系指南》(DAMA-DMBOK)第一版,确立了"一个核心 + 九大职能"的结构:以数据治理为核心,向外展开数据质量管理、数据架构管理、数据开发、数据操作管理、数据安全管理、参考与主数据管理、数据仓库与商务智能管理、文档与内容管理、元数据管理九大领域。
DMBOK 的意义在于:它第一次把数据治理从"几篇文章"变成了"一本书、一套标准、一个可以考试认证的体系"。从此数据治理有了共同的词汇表,从业者终于可以跨企业对话。2017 年,DMBOK 推出第二版,进一步扩展到 11 个知识域。
顺便说一句,今天很多人考的 CDGA/CDGP 认证,考的就是这套体系。
06 中国路径:从一个人、一批银行,到一部国家标准
中国的故事,有自己的节奏。
先说一个人:高复先教授。1986 年,他把西方的信息工程(IE)和数据管理理论引进国内。当时国内企业信息化刚起步,他看到的问题是:花了巨资建通信网络、自动化系统、管理信息系统,却因为缺乏高层统筹规划和统一信息标准,设计、生产、经营管理的数据无法流通共享,形成了一个个信息孤岛。
他提出的方法是"信息资源规划(IRP)"——先做总体数据规划,建立数据管理基础标准,再谈系统集成。2002 年他出版专著《信息资源规划——信息化建设基础工程》,逐步形成了适合中国国情的 IRP 体系。数据元素、数据标准、元数据这些今天从业者挂在嘴边的概念,在国内的普及,高老师功不可没。称他为中国数据治理的先行者之一,并不为过。
再说第一批实践者:银行。2005 年前后,早期数据仓库建设在中国兴起,最先动起来的是商业银行和通信运营商——它们数据量大、系统多、监管严。商业银行通过与埃森哲、IBM 等国外 IT 咨询公司合作,最早把数据治理的概念在中国落了地。
这里有个细节特别值得玩味:中国移动的数据仓库建设始于 2004 年,而元数据管理规范直到 2006 年才正式推出。先建设、后治理,几乎是那个年代的标配。这一阶段的数据治理基本由 IT 部门牵头,业务部门很少参与。
然后是监管推动。2010 年底巴塞尔委员会发布《第三版巴塞尔协议》,对银行的数据使用、积累和管理提出要求;银监会 2011 年推出《银行监管统计数据质量管理良好标准》,从组织机构及人员、制度建设、系统保障和数据标准、数据质量监控检查与评价、数据报送应用和存储五大方面提出要求。数据治理第一次变成了"不做到就要挨罚"的事。
再然后是标准国际化。2015 年,在巴西圣保罗召开的 ISO/I
2018 年是中国的标准之年。6 月 7 日,国家市场监督管理总局和国家标准化管理委员会发布公告,批准《信息技术服务治理 第 5 部分:数据治理规范》(GB/T 34960.5-2018),2019 年 1 月 1 日起实施。同年,银保监会发布《银行业金融机构数据治理指引》,标志着数据治理在中国银行业进入全面实践时代。
2020 年,中国软件评测中心副主任吴志刚在 DAMA 中国数据管理峰会上提出:2020 年是数据治理元年。这个提法得到业界广泛认同。同年,《华为数据之道》出版,把一家中国头部企业的治理实践摆到了台面上。
这一阶段的启示:中国的数据治理,走的是一条"先建后治、由点到面、监管驱动"的路。从 IT 部门的独角戏,到监管强制要求,再到国家标准落地——每一步都不是技术自然演进的结果,而是被问题逼出来的。
07 2020-2026:从"治理数据",到"释放数据"
2020 年之后,故事的性质变了。
此前所有的数据治理,核心动词都是"管"——管住质量、管住口径、管住安全。而从 2020 年起,数据在中国被正式赋予了另一重身份。
2020 年 4 月,《中共中央 国务院关于构建更加完善的要素市场化配置体制机制的意见》发布,首次将数据作为一种新型生产要素写入中央文件。中国成为世界上首个把数据列为生产要素的国家。
2022 年 12 月,《关于构建数据基础制度更好发挥数据要素作用的意见》("数据二十条")发布,系统构建了数据产权、流通交易、收益分配、安全治理的"四梁八柱",并提出数据产权"三权分置"。
2023 年是最密集的一年。3 月,机构改革方案提出组建国家数据局;10 月 25 日,国家数据局正式挂牌;8 月 21 日,财政部印发《企业数据资源相关会计处理暂行规定》,自 2024 年 1 月 1 日起施行——数据资产从此可以正式入表。这一年,入表企业数量从一季度的 18 家扩张到三季度的 56 家。
2024 年 1 月,《"数据要素×"三年行动计划(2024—2026 年)》发布,聚焦 12 个重点场景推动数据价值释放。同年 10 月,《国家数据标准体系建设指南》印发,明确到 2026 年基本建成国家数据标准体系。12 月,《关于促进数据产业高质量发展的指导意见》首次明确提出"高质量数据集"概念,将其作为人工智能与实体经济融合的核心载体。
2025 年 2 月,国家数据局组织 27 个部委召开高质量数据集建设工作启动会,标志着高质量数据集建设进入系统化、规模化推进阶段。
数字最能说明变化的速度。据国家数据局在 2026 年 4 月第九届数字中国建设峰会上发布的《全国数据资源调查报告(2025 年)》:2025 年中国数据生产总量达 52.26 ZB,同比增长 27.28%,约占全球的 27.44%;全国高质量数据集数量超过 11 万个、规模超 908 PB,同比分别增长 61.13% 和 142.58%。全国日均词元(Token)调用量,从 2025 年初的超万亿增长到年末的 100 万亿。
2026 年,全国数据工作会议将这一年定为"数据要素价值释放年",政府工作报告明确提出"深化数据资源开发利用,健全数据要素基础制度,建设高质量数据集"。
这一阶段的启示:数据治理的动词,从"管"变成了"放"。而且是必须先治理好,才能放心地放——高质量数据集这个词本身就是证据:它既要求"高质量"(治理的结果),又要求"数据集"(可交付、可交易、可消费的形态)。
08 一条暗线:驱动力变迁,才是这段历史的真相
把六十年串起来看,你会发现一条清晰的暗线:
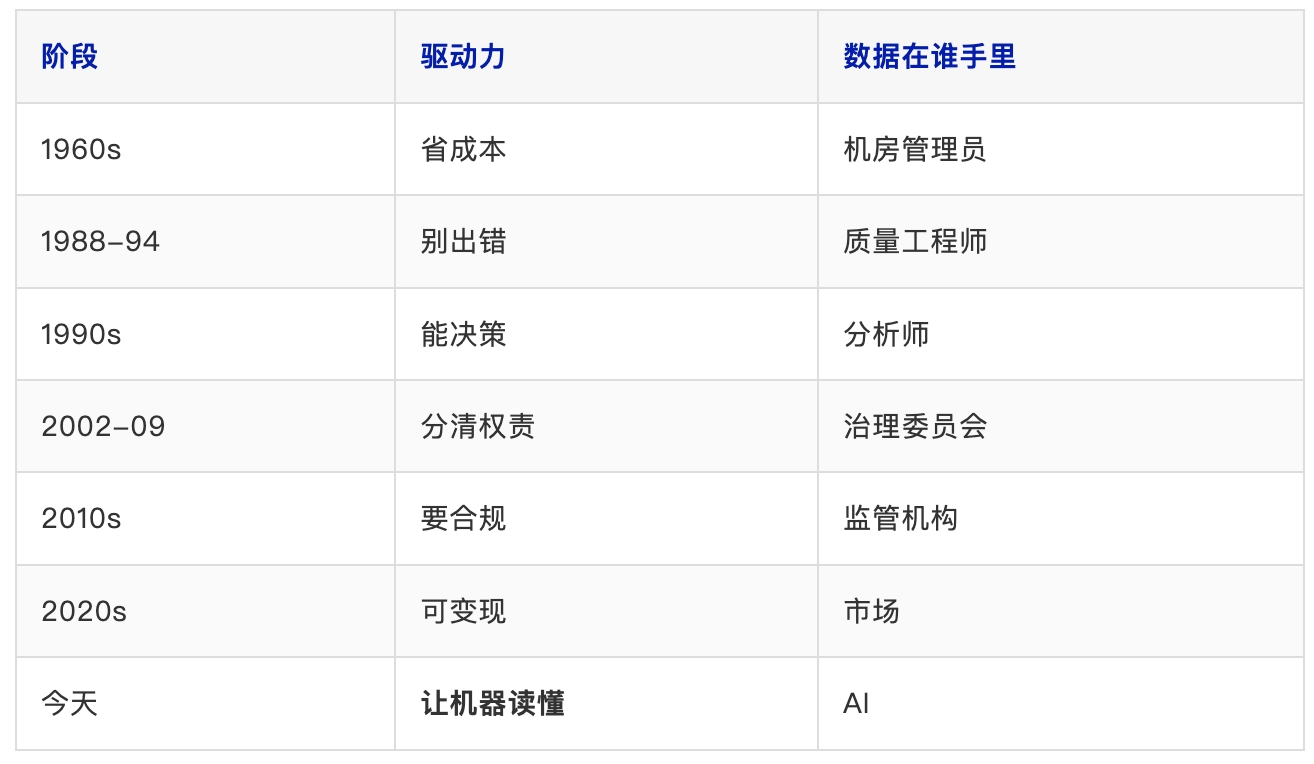
看明白了吗?每一次驱动力变化,"数据治理"这个词的含义就被重写一次。
而今天这一轮,可能是六十年里最剧烈的一次。因为历史上所有的消费者都是人——人遇到歧义会停下来问一句,人能脑补上下文,人看到"华东区"会猜到是按注册地。但 AI 不会。它遇到歧义不会停下来,它会猜一个继续跑,而且跑得非常有说服力。
这就是为什么"高质量数据集"在 2024 年底被首次提出、2025 年就成了 27 个部委联合推进的国家行动——因为消费数据的人,第一次不是人了。
写在最后
回望这六十年,你会发现一个有点残酷的事实:数据治理从来没有因为"提前规划得好"而被重视过,它每一次走上台前,都是因为出事了——因为穿孔卡堆满了整整一层楼,因为抽出来的数据织成了蜘蛛网,因为两个部门的报表对不上,因为监管要罚,因为 AI 开始一本正经地胡说。
所以它本质上不是一门"建设学科",而是一门"补课学科"。每一次技术往前跑一步,它就在后面补一步。
但换个角度看,这也正是它的价值所在:每一次补课,都是在为下一轮技术跃迁铺路。今天你把标准、语义、契约补上,明天 AI 才敢在你家的数据上跑。六十年过去了,这件事的本质没变——先定义清楚,才谈得上用得好。
 简体中文
 English